
Agregações, GROUP BY e HAVING
Agregar é transformar várias linhas em uma medida
Na aula anterior, vimos como JOINs combinam relações e alteram a granularidade do resultado. Agora vamos resumir essas linhas de maneira controlada.
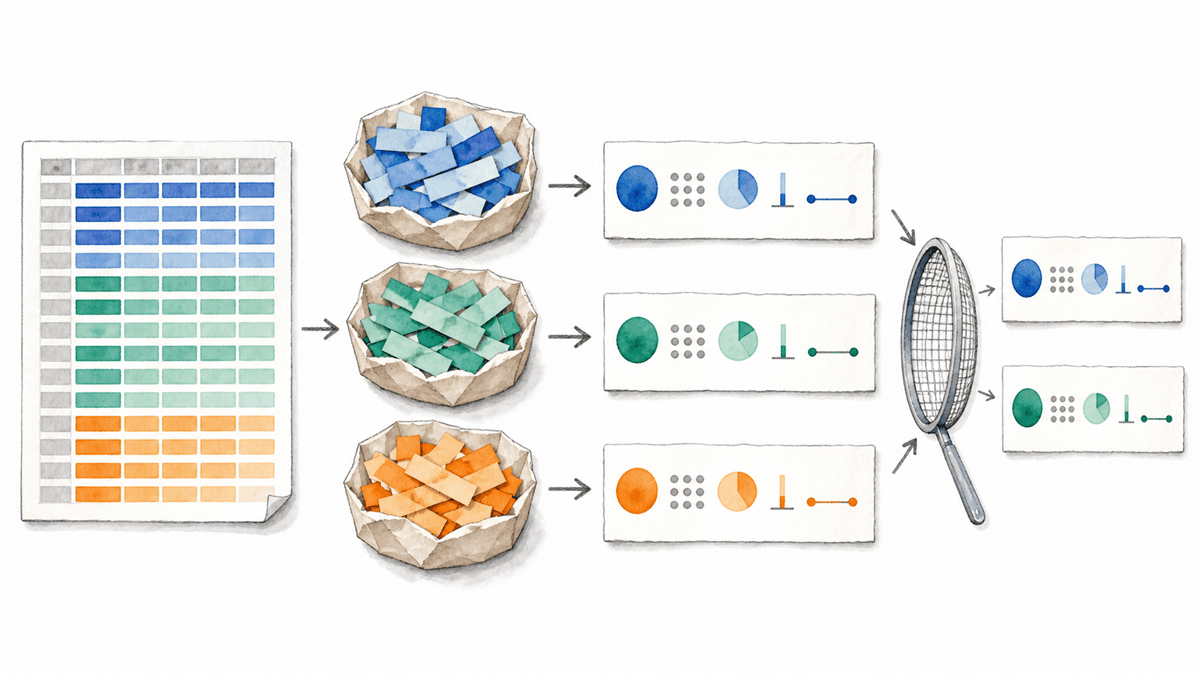
Uma função de agregação recebe um conjunto de valores e produz um resultado: quantidade, soma, média, menor ou maior valor. GROUP BY divide as linhas em grupos antes do cálculo; HAVING decide quais grupos calculados permanecem.
SELECT
  trilha_id,
  COUNT(*) AS total_matriculas
FROM matricula
WHERE situacao = 'ativa'
GROUP BY trilha_id
HAVING COUNT(*) >= 2
ORDER BY total_matriculas DESC, trilha_id;
Cada linha desse resultado representa uma trilha, não mais uma matrícula. A consulta só é correta quando essa nova granularidade corresponde à pergunta.
A consulta agregada possui uma ordem lógica
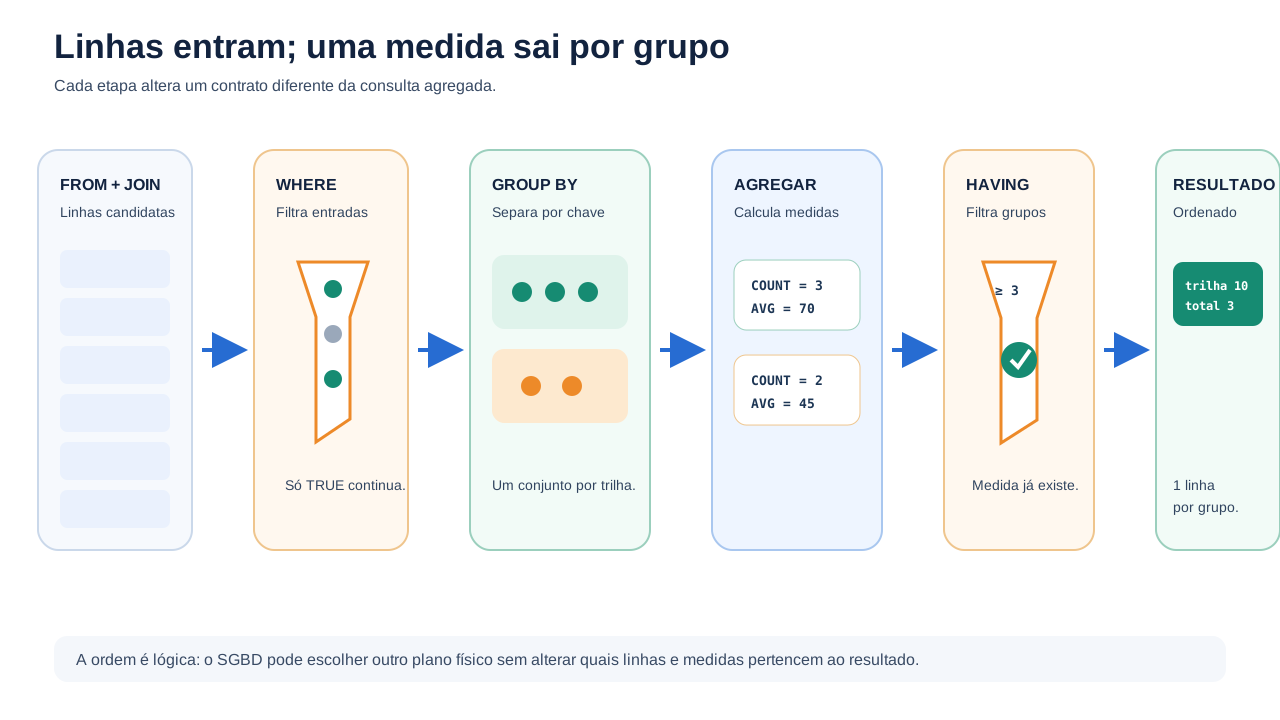
Para compreender filtros e nomes disponíveis, leia conceitualmente a consulta nesta sequência:
FROM e JOIN → WHERE → GROUP BY → agregações → HAVING → SELECT → ORDER BY
FROMeJOINformam as linhas de entrada;WHEREelimina linhas antes dos cálculos;GROUP BYsepara as linhas restantes;- as funções calculam uma medida por grupo;
HAVINGelimina grupos completos;SELECTforma a saída;ORDER BYordena o resultado final.
Essa é uma ordem lógica para raciocinar. O otimizador pode executar operações físicas de outra forma quando preservar o mesmo resultado.
Sem GROUP BY, toda a entrada forma um conjunto
SELECT COUNT(*) AS total_matriculas
FROM matricula;
Sem GROUP BY, a consulta agregada trata todas as linhas selecionadas como um único grupo implícito. Por isso retorna uma linha com o total geral.
SELECT
  COUNT(*) AS quantidade,
  SUM(progresso_percentual) AS soma,
  AVG(progresso_percentual) AS media,
  MIN(progresso_percentual) AS menor,
  MAX(progresso_percentual) AS maior
FROM matricula
WHERE situacao = 'ativa';
As funções mais frequentes respondem a perguntas diferentes:
| Função | Pergunta respondida |
|---|---|
COUNT(*) | quantas linhas existem? |
COUNT(expressao) | em quantas linhas a expressão não é NULL? |
SUM(expressao) | qual é a soma dos valores não nulos? |
AVG(expressao) | qual é a média dos valores não nulos? |
MIN(expressao) | qual é o menor valor não nulo? |
MAX(expressao) | qual é o maior valor não nulo? |
MIN e MAX não se limitam a números: também podem operar sobre datas, textos e outros tipos ordenáveis, conforme o SGBD.
COUNT(*) e COUNT(coluna) não contam a mesma coisa
Considere quatro matrículas:
| matricula_id | concluida_em |
|---|---|
| 501 | 2026-08-10 |
| 502 | NULL |
| 503 | 2026-08-12 |
| 504 | NULL |
SELECT
  COUNT(*) AS matriculas,
  COUNT(concluida_em) AS com_data_de_conclusao
FROM matricula;
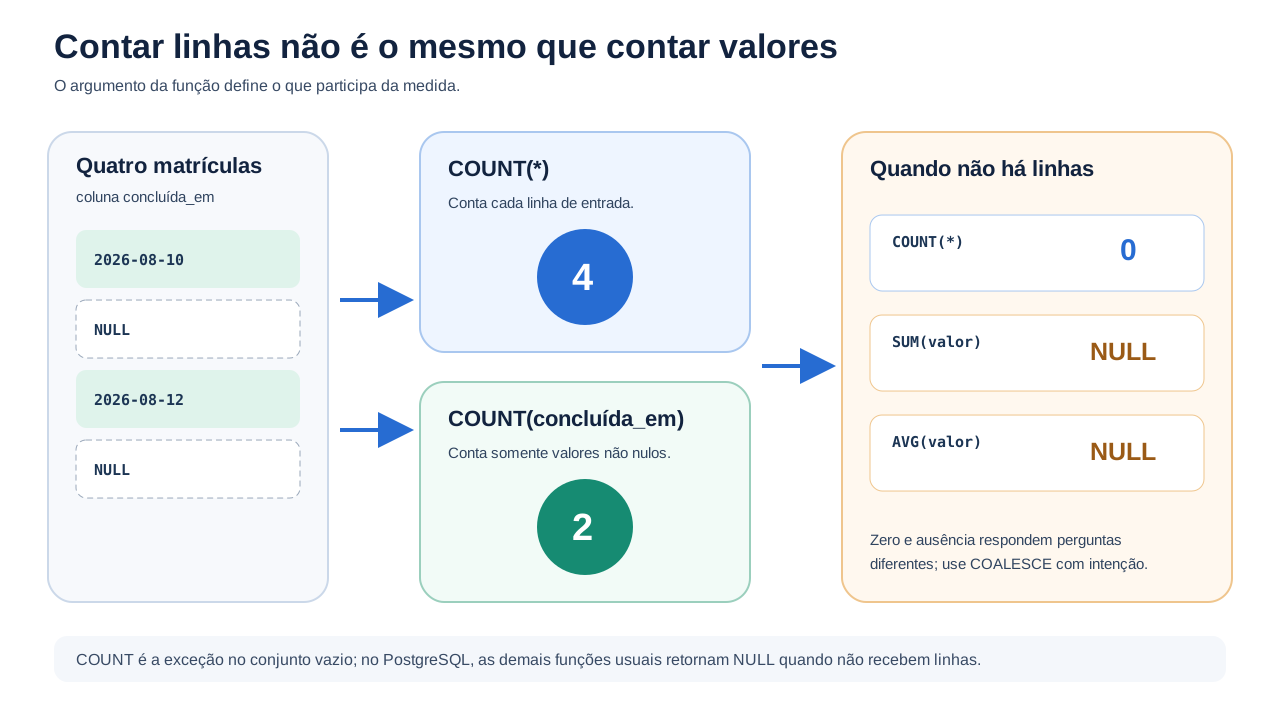
O resultado é 4 e 2. COUNT(*) conta linhas, mesmo que algumas colunas sejam nulas. COUNT(concluida_em) conta somente as linhas em que essa expressão produz valor não nulo.
COUNT(1) também conta linhas, pois o literal 1 não é nulo. Ele não é uma forma especial ou necessariamente mais rápida de contar; COUNT(*) comunica a intenção diretamente.
DISTINCT altera a entrada da função
SELECT COUNT(DISTINCT estudante_id) AS estudantes_unicos
FROM matricula
WHERE situacao = 'ativa';
Agora cada valor não nulo distinto de estudante_id participa uma vez. Isso não equivale a SELECT DISTINCT sobre a linha de saída: o DISTINCT está dentro da função e afeta apenas a entrada daquela agregação.
NULL é ignorado pela maioria das agregações usuais
SUM, AVG, MIN, MAX e COUNT(expressao) trabalham com entradas não nulas. Isso significa que:
AVG(progresso_percentual)
calcula a média apenas entre matrículas com progresso conhecido. Não trata progresso ausente como zero.
AVG(COALESCE(progresso_percentual, 0))
responde outra pergunta: considera toda ausência como zero. Só faça essa substituição se a regra de negócio declarar equivalência entre “desconhecido” e “nenhum progresso”.
Um conjunto vazio merece tratamento explícito
Quando nenhuma linha é selecionada:
COUNT(*)retorna0;- no PostgreSQL,
SUM,AVG,MINeMAXretornamNULL; COALESCE(SUM(valor), 0)pode produzir zero quando zero é o elemento neutro desejado.
SELECT COALESCE(SUM(duracao_minutos), 0) AS duracao_total
FROM conteudo
WHERE publicado = true;
Não aplique COALESCE automaticamente. “Não existem avaliações” pode ser semanticamente diferente de “a média é zero”.
GROUP BY cria uma linha por combinação de chaves
SELECT
  trilha_id,
  situacao,
  COUNT(*) AS quantidade
FROM matricula
GROUP BY trilha_id, situacao
ORDER BY trilha_id, situacao;
Cada combinação distinta de trilha_id e situacao forma um grupo. A ordem das expressões em GROUP BY não cria uma hierarquia nem garante a ordem de saída; use ORDER BY para apresentação.
A lista de SELECT precisa ter um valor por grupo
Esta consulta é ambígua:
SELECT trilha_id, estudante_id, COUNT(*)
FROM matricula
GROUP BY trilha_id;
Um grupo de trilha pode conter vários estudantes. Não existe um único estudante_id que represente o grupo. Em regra, uma expressão da lista de saída deve:
- participar de
GROUP BY; ou - estar dentro de uma função de agregação; ou
- ser derivável de forma não ambígua segundo dependências funcionais reconhecidas pelo SGBD.
O PostgreSQL reconhece alguns casos de dependência por chave primária, mas não transforme essa possibilidade em atalho obscuro. Agrupe pela chave estável e selecione atributos funcionalmente determinados apenas quando o significado estiver claro.
NULL forma um grupo
Em agrupamento, linhas com NULL na mesma chave são reunidas. Isso não significa que NULL = NULL se tornou verdadeiro em comparações comuns; agrupamento possui regras próprias para formar classes.
SELECT nivel, COUNT(*)
FROM trilha
GROUP BY nivel;
Se várias trilhas não possuem nível informado, aparecerá uma linha de grupo com nivel nulo.
WHERE filtra linhas; HAVING filtra grupos
Requisito: encontrar trilhas com pelo menos duas matrículas ativas.
SELECT
  trilha_id,
  COUNT(*) AS total_ativas
FROM matricula
WHERE situacao = 'ativa'
GROUP BY trilha_id
HAVING COUNT(*) >= 2
ORDER BY total_ativas DESC, trilha_id;
WHERE remove matrículas não ativas antes da formação dos grupos. HAVING compara a contagem já calculada e remove grupos com menos de duas linhas.
Uma função agregada não pode ser usada diretamente em WHERE na mesma camada:
-- Incorreto
WHERE COUNT(*) >= 2
Nesse momento lógico, os grupos ainda não existem. Use HAVING para condições agregadas.
Se uma condição não depende de agregação, geralmente deve ir em WHERE, reduzindo a entrada antes do agrupamento:
WHERE publicada_em >= DATE '2026-01-01'
GROUP BY area_id
HAVING COUNT(*) >= 3
FILTER calcula várias medidas condicionais no mesmo grupo
No PostgreSQL, a cláusula FILTER limita as linhas entregues a uma função específica:
SELECT
  trilha_id,
  COUNT(*) AS total,
  COUNT(*) FILTER (WHERE situacao = 'ativa') AS ativas,
  COUNT(*) FILTER (WHERE situacao = 'concluida') AS concluidas
FROM matricula
GROUP BY trilha_id;
O grupo continua contendo todas as matrículas. Cada FILTER escolhe a entrada de sua própria medida. Isso é diferente de colocar situacao = 'ativa' em WHERE, o que removeria as concluídas de todas as agregações.
Uma alternativa amplamente reconhecida usa expressão condicional:
SUM(CASE WHEN situacao = 'ativa' THEN 1 ELSE 0 END)
Escolha considerando portabilidade, clareza e suporte do produto. Evite misturar formas sem necessidade na mesma base de código.
Agregações após LEFT JOIN exigem a coluna certa
Requisito: mostrar todas as trilhas e quantas matrículas cada uma possui, inclusive zero.
SELECT
  t.trilha_id,
  t.titulo,
  COUNT(m.matricula_id) AS total_matriculas
FROM trilha AS t
LEFT JOIN matricula AS m
  ON m.trilha_id = t.trilha_id
GROUP BY t.trilha_id, t.titulo
ORDER BY t.trilha_id;
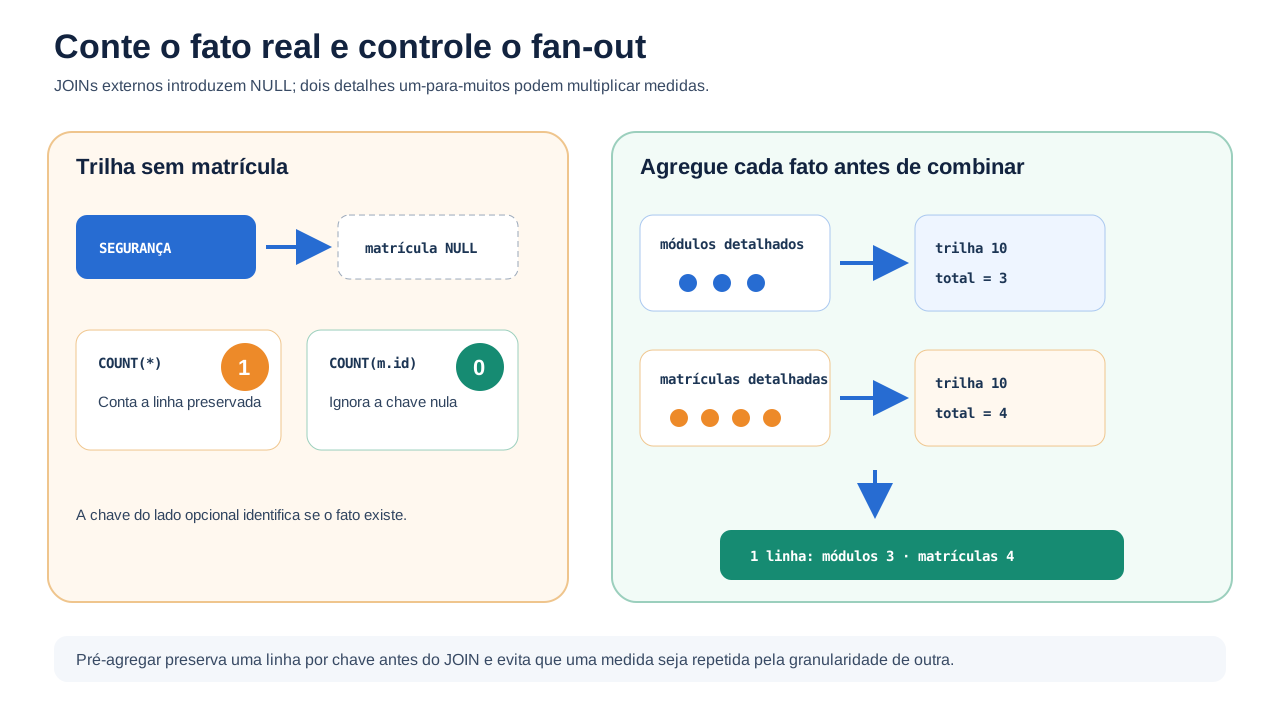
Para uma trilha sem matrícula, o LEFT JOIN produz uma linha preservada com colunas de m nulas:
COUNT(*)contaria essa linha e retornaria1;COUNT(m.matricula_id)retorna0, pois a chave do lado opcional é nula.
Essa escolha não é detalhe sintático: define o fato contado.
Dois lados “muitos” podem inflar medidas
Se uma trilha tem três módulos e quatro matrículas, juntar ambos os detalhes produz doze linhas. Depois disso:
COUNT(mo.modulo_id)       -- 12, não 3
COUNT(ma.matricula_id)    -- 12, não 4
COUNT(DISTINCT ...) pode recuperar algumas contagens, mas não protege somas em geral e pode esconder uma granularidade mal planejada. Uma estratégia é resumir cada lado em sua própria granularidade antes do JOIN:
SELECT
  t.trilha_id,
  COALESCE(mo.total_modulos, 0) AS total_modulos,
  COALESCE(ma.total_matriculas, 0) AS total_matriculas
FROM trilha AS t
LEFT JOIN (
  SELECT trilha_id, COUNT(*) AS total_modulos
  FROM modulo
  GROUP BY trilha_id
) AS mo ON mo.trilha_id = t.trilha_id
LEFT JOIN (
  SELECT trilha_id, COUNT(*) AS total_matriculas
  FROM matricula
  GROUP BY trilha_id
) AS ma ON ma.trilha_id = t.trilha_id;
Cada subconsulta entrega no máximo uma linha por trilha. A próxima aula aprofundará subconsultas e CTEs; aqui, o princípio importante é agregar cada fato antes de combinar medidas incompatíveis.
A ordem dentro de uma agregação é diferente da ordem final
Algumas funções produzem o mesmo resultado independentemente da ordem, como SUM e COUNT. Outras, como string_agg, dependem da sequência dos valores.
No PostgreSQL:
SELECT
  trilha_id,
  string_agg(titulo, ', ' ORDER BY ordem) AS conteudos
FROM conteudo
GROUP BY trilha_id;
O ORDER BY dentro de string_agg controla a ordem dos títulos dentro da string. Um ORDER BY no final da consulta controla a ordem das linhas de grupos. São contratos diferentes.
Use funções de coleção e sintaxes específicas somente quando o produto e o formato de saída justificarem. A explicação central de COUNT, SUM, AVG, MIN, MAX, GROUP BY e HAVING continua compatível com o SQL relacional amplamente adotado.
Um exemplo completo
Requisito: listar todas as trilhas publicadas desde 2026 que possuem ao menos duas matrículas ativas. Mostrar total geral, ativas, estudantes únicos e média de progresso conhecido.
SELECT
  t.trilha_id,
  t.titulo,
  COUNT(m.matricula_id) AS total_matriculas,
  COUNT(m.matricula_id)
    FILTER (WHERE m.situacao = 'ativa') AS matriculas_ativas,
  COUNT(DISTINCT m.estudante_id)
    FILTER (WHERE m.situacao = 'ativa') AS estudantes_ativos,
  ROUND(
    AVG(m.progresso_percentual)
      FILTER (WHERE m.situacao = 'ativa'),
    2
  ) AS progresso_medio_ativo
FROM trilha AS t
LEFT JOIN matricula AS m
  ON m.trilha_id = t.trilha_id
WHERE t.situacao = 'publicada'
  AND t.publicada_em >= DATE '2026-01-01'
GROUP BY t.trilha_id, t.titulo
HAVING COUNT(m.matricula_id)
         FILTER (WHERE m.situacao = 'ativa') >= 2
ORDER BY matriculas_ativas DESC, t.trilha_id;
Leia por contratos:
LEFT JOINpreserva trilhas sem matrícula durante a formação da entrada;WHEREseleciona as trilhas que podem participar;GROUP BYdefine uma linha por trilha;- cada função mede um aspecto do grupo;
FILTERlimita apenas a medida associada;HAVINGexige ao menos duas matrículas ativas;ORDER BYcria uma apresentação previsível.
O resultado final já não inclui trilhas sem matrículas ativas por causa de HAVING. O LEFT JOIN continua útil porque permite calcular e testar a ausência antes dessa decisão explícita.
Erros comuns
- usar
COUNT(coluna)pensando que conta todas as linhas: valores nulos são ignorados; - usar
COUNT(*)após LEFT JOIN para contar filhos: a linha preservada pode virar um falso total1; - tratar
NULLcomo zero sem regra de negócio: ausência e valor zero são estados diferentes; - colocar agregação em
WHERE: os grupos ainda não existem nessa etapa; - usar
HAVINGpara um filtro simples de entrada: mais linhas são agrupadas sem necessidade e a intenção fica menos clara; - selecionar coluna sem agrupar nem agregar: não há um valor único representativo;
- supor que a ordem de GROUP BY ordena a saída: somente
ORDER BYgarante ordem; - ignorar fan-out de JOINs: contagens e somas podem ser multiplicadas;
- aplicar
DISTINCTcomo reparo universal: pode esconder o problema e não corrige toda medida; - esperar zero de SUM em conjunto vazio: no PostgreSQL, o resultado é
NULL; - confundir agregação com função de janela: a agregação comum reduz linhas; uma função com
OVERpode manter cada linha, assunto da próxima aula; - arredondar cedo demais: arredonde a apresentação final, não cada parcela, salvo exigência do domínio.
Checklist de uma agregação confiável
- Qual é a granularidade das linhas de entrada?
- Qual será a granularidade de cada linha de saída?
WHEREinclui exatamente os fatos que devem participar?- A função escolhida responde à pergunta correta?
COUNT(*)ouCOUNT(coluna)representa o que será contado?- Como valores nulos devem influenciar a medida?
- O conjunto vazio deve produzir
NULL, zero ou nenhuma linha? - Todas as expressões não agregadas possuem um valor único por grupo?
HAVINGfiltra uma propriedade do grupo, e não uma linha individual?- Um JOIN multiplicou os fatos antes do cálculo?
- Cada lado precisa ser pré-agregado?
- A ordem interna da função e a ordem final foram declaradas quando necessárias?
O que você deve guardar
Funções agregadas transformam muitas linhas em uma medida. Sem GROUP BY, existe um conjunto geral; com ele, cada combinação de chaves forma um grupo. WHERE decide quais linhas entram, HAVING decide quais grupos saem e FILTER pode limitar apenas uma função específica.
COUNT(*) conta linhas; COUNT(expressao) ignora resultados nulos. Após JOINs, a chave contada e a granularidade intermediária definem se a medida é verdadeira ou inflada.
Na próxima aula, compararemos subconsultas, CTEs, operações de conjunto e funções de janela para compor consultas mais elaboradas sem perder a granularidade.
Referências
- ISO — ISO/IEC 9075-2:2023, SQL/Foundation. Acesso em 30 ago. 2026.
- ISO — ISO/IEC 9075-2:2023/Cor 1:2026. Acesso em 30 ago. 2026.
- PostgreSQL Global Development Group — Aggregate Functions. Acesso em 30 ago. 2026.
- PostgreSQL Global Development Group — GROUP BY and HAVING. Acesso em 30 ago. 2026.
- PostgreSQL Global Development Group — Aggregate Expressions and FILTER. Acesso em 30 ago. 2026.
- PostgreSQL Global Development Group — Aggregate Functions Tutorial. Acesso em 30 ago. 2026.