
SELECT, filtros, ordenação, aliases e valores NULL
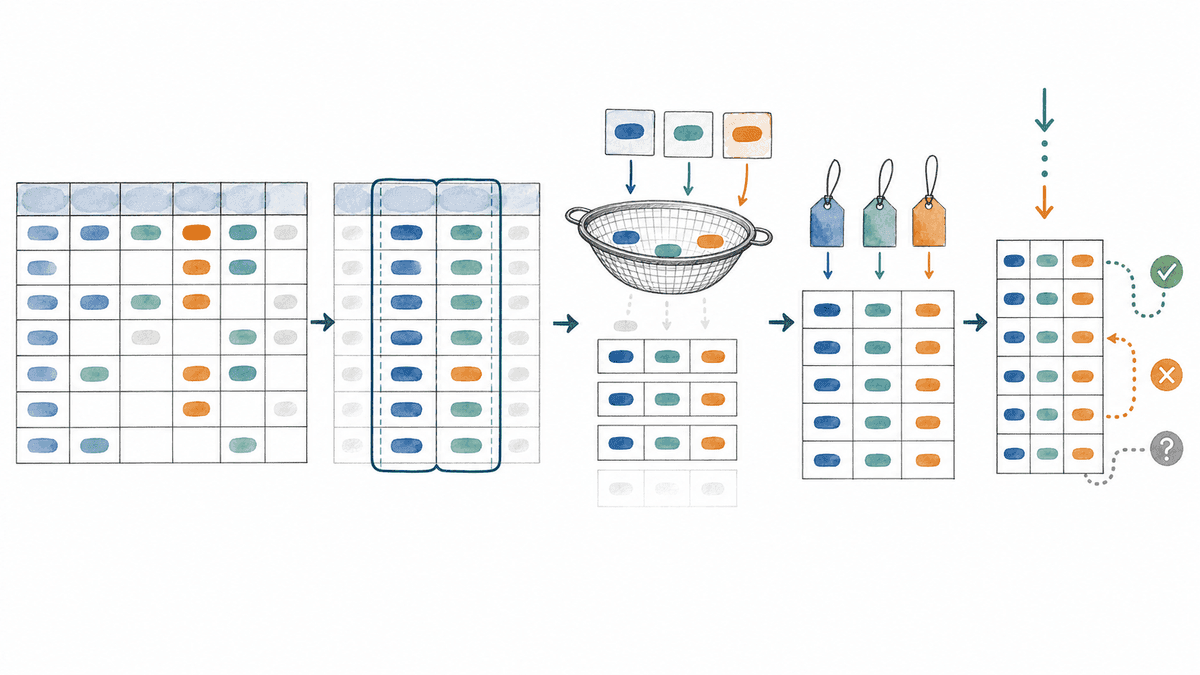
SELECT transforma uma fonte em uma relação de resultado
Na aula anterior, vimos que SQL define estruturas, opera dados, controla privilégios e delimita transações. Agora aprofundaremos a consulta mais frequente: SELECT.
Uma consulta declara quais colunas produzir, de qual fonte obter linhas, quais linhas preservar e em qual ordem apresentar o resultado. Ela não é apenas uma leitura da tabela inteira: pode projetar colunas, calcular expressões, renomear saídas, filtrar valores e ordenar o conjunto final.
SELECT
  trilha_id,
  titulo,
  publicada_em
FROM trilha
WHERE situacao = 'publicada'
ORDER BY publicada_em DESC, trilha_id ASC;
Neste exemplo, FROM fornece as linhas candidatas, WHERE mantém apenas as publicadas, SELECT determina as colunas de saída e ORDER BY estabelece uma ordem previsível.
A ordem escrita não é a ordem lógica
Uma forma útil de entender a consulta básica é separar a sintaxe escrita da transformação lógica:
Escrita: SELECT → FROM → WHERE → ORDER BY → LIMIT
Lógica:  FROM → WHERE → SELECT → DISTINCT → ORDER BY → LIMIT
Essa sequência explica comportamentos que parecem estranhos no início. Um alias criado na lista de saída pode ser usado em ORDER BY, que atua depois dela, mas normalmente não pode ser usado em WHERE, que filtra antes da lista de saída existir.
SELECT duracao_minutos / 60.0 AS duracao_horas
FROM trilha
WHERE duracao_minutos >= 60
ORDER BY duracao_horas DESC;
Escrever WHERE duracao_horas >= 1 nessa mesma camada não funciona no PostgreSQL: o alias ainda não faz parte da tabela virtual filtrada. Repita a expressão ou mova o cálculo para uma subconsulta/CTE quando essa abstração realmente melhorar a leitura.
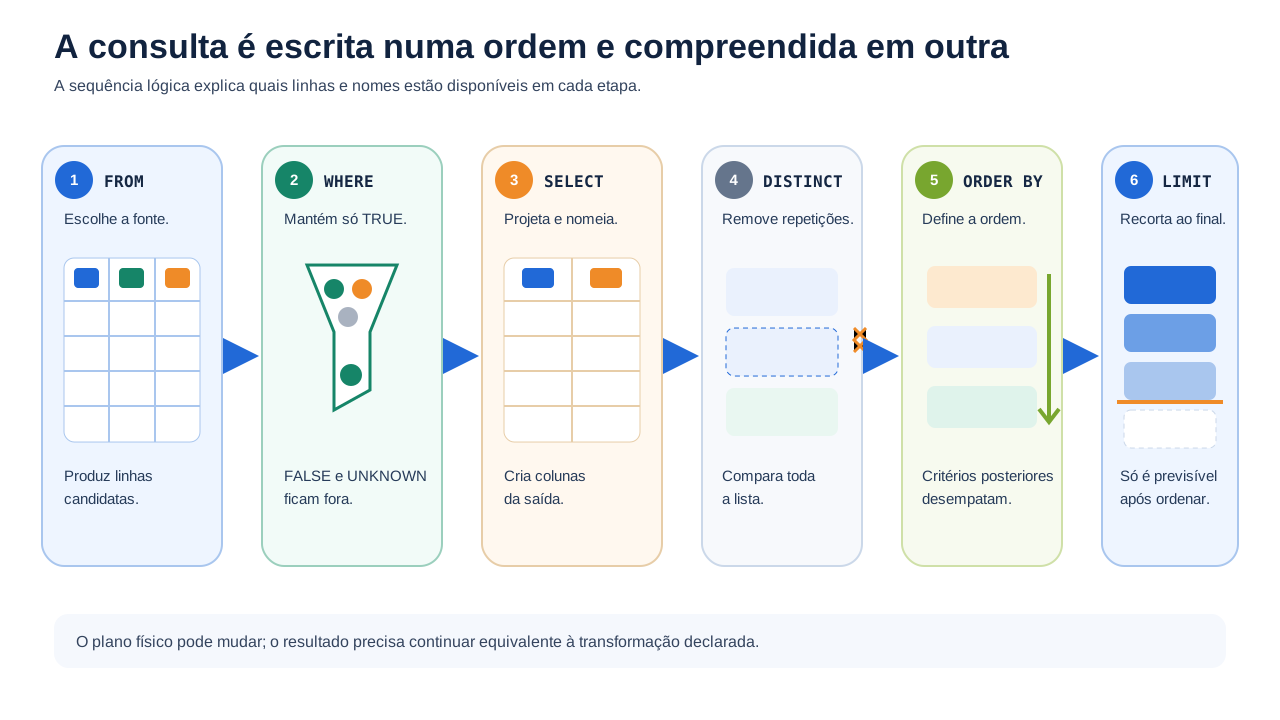
Essa é uma explicação conceitual. O otimizador pode reorganizar operações físicas quando provar que o resultado continua equivalente.
SELECT define as colunas de saída
Prefira colunas explícitas
SELECT trilha_id, titulo, situacao
FROM trilha;
SELECT * solicita todas as colunas produzidas por FROM. É útil na exploração pontual, mas costuma ser uma interface frágil em aplicações:
- uma alteração no esquema muda silenciosamente a saída;
- colunas grandes ou sensíveis podem ser transportadas sem necessidade;
- duas consultas visualmente iguais podem passar a retornar formatos diferentes;
- o contrato fica menos claro para quem revisa o código.
Selecionar explicitamente não é uma regra absoluta contra *; é uma forma de declarar o contrato quando a saída será consumida por outro componente.
A lista aceita expressões
Cada item pode ser uma coluna, literal, operação ou chamada de função:
SELECT
  titulo,
  duracao_minutos,
  ROUND(duracao_minutos / 60.0, 2) AS duracao_horas,
  situacao = 'publicada' AS esta_publicada
FROM trilha;
A expressão é avaliada para cada linha que chegou à lista de seleção. Ela cria uma coluna no resultado; não altera a coluna armazenada.
Alias nomeia a saída, não o dado original
SELECT
  titulo AS nome_da_trilha,
  publicada_em AS data_de_publicacao
FROM trilha AS t;
Há dois aliases diferentes:
nome_da_trilhaedata_de_publicacaosão rótulos das colunas de saída;té o nome temporário da fonte durante a consulta.
O alias não renomeia a tabela ou coluna no esquema. AS é opcional em várias posições, mas mantê-lo para colunas torna a intenção visível. Para tabelas, aliases curtos ajudam principalmente quando há várias fontes; a aula de JOINs aprofundará esse uso.
Evite aliases como x, valor2 ou campo_final quando a saída possui significado estável. O nome é parte do contrato entregue ao cliente.
WHERE filtra por um predicado
WHERE recebe uma expressão booleana para cada linha. Apenas linhas cujo resultado seja TRUE continuam.
Comparações básicas
SELECT trilha_id, titulo, duracao_minutos
FROM trilha
WHERE duracao_minutos >= 120;
Operadores frequentes incluem:
| Operador | Significado |
|---|---|
= | igual |
<> | diferente no padrão SQL |
<, <= | menor; menor ou igual |
>, >= | maior; maior ou igual |
O PostgreSQL também aceita != para diferente, mas <> é a grafia do padrão SQL.
Compare tipos compatíveis. Uma data deve ser tratada como data, não como texto dependente de formato:
SELECT titulo, publicada_em
FROM trilha
WHERE publicada_em >= DATE '2026-01-01';
BETWEEN inclui as extremidades
SELECT titulo, duracao_minutos
FROM trilha
WHERE duracao_minutos BETWEEN 60 AND 180;
Esse predicado equivale a:
duracao_minutos >= 60 AND duracao_minutos <= 180
As duas extremidades estão incluídas. Para timestamps, um intervalo semiaberto costuma ser mais seguro do que tentar representar “o último instante do dia”:
WHERE publicada_em >= TIMESTAMP '2026-08-01 00:00:00'
  AND publicada_em <  TIMESTAMP '2026-09-01 00:00:00'
IN compara com um conjunto explícito
SELECT titulo, situacao
FROM trilha
WHERE situacao IN ('publicada', 'arquivada');
Isso expressa várias igualdades ligadas por OR. Listas grandes, dinâmicas ou originadas de outra relação podem pedir outra estrutura; não concatene entradas externas para montar o conteúdo de IN.
LIKE procura padrões textuais
SELECT titulo
FROM trilha
WHERE titulo LIKE 'Banco%';
No padrão de LIKE:
%representa qualquer sequência de caracteres;_representa exatamente um caractere.
No PostgreSQL, ILIKE faz correspondência sem diferenciar maiúsculas de minúsculas segundo o locale, mas é uma extensão do produto. Regras linguísticas, collation e indexação afetam busca textual; não presuma que converter tudo com LOWER resolve qualquer idioma ou desempenho.
AND, OR e NOT compõem condições
SELECT titulo, situacao, duracao_minutos
FROM trilha
WHERE situacao = 'publicada'
  AND duracao_minutos >= 90;
SELECT titulo, situacao
FROM trilha
WHERE situacao = 'publicada'
   OR situacao = 'arquivada';
NOT nega uma condição:
WHERE NOT situacao = 'arquivada'
Por precedência, NOT é avaliado antes de AND, e AND antes de OR. Mesmo conhecendo a regra, use parênteses quando houver mais de uma interpretação plausível:
WHERE situacao = 'publicada'
  AND (nivel = 'basico' OR nivel IS NULL)
Sem os parênteses, uma leitura rápida poderia atribuir o filtro de situação apenas ao primeiro nível. Clareza é parte da correção.
NULL representa ausência ou desconhecimento
NULL não é zero, string vazia, falso ou uma data especial. Ele indica que não há um valor conhecido naquela posição, conforme a semântica definida para a coluna.
Na plataforma:
publicada_em IS NULLpode significar que uma trilha ainda não foi publicada;concluida_em IS NULLpode significar que uma matrícula ainda está em andamento;- um dado opcional pode permanecer desconhecido.
Esses significados são diferentes. O dicionário de dados precisa explicá-los; NULL sozinho não diz por que o valor está ausente.
Não compare NULL com igualdade
-- Incorreto para testar ausência
WHERE publicada_em = NULL
Uma comparação comum com NULL produz UNKNOWN, não TRUE:
WHERE publicada_em IS NULL
WHERE publicada_em IS NOT NULL
SQL possui lógica de três valores
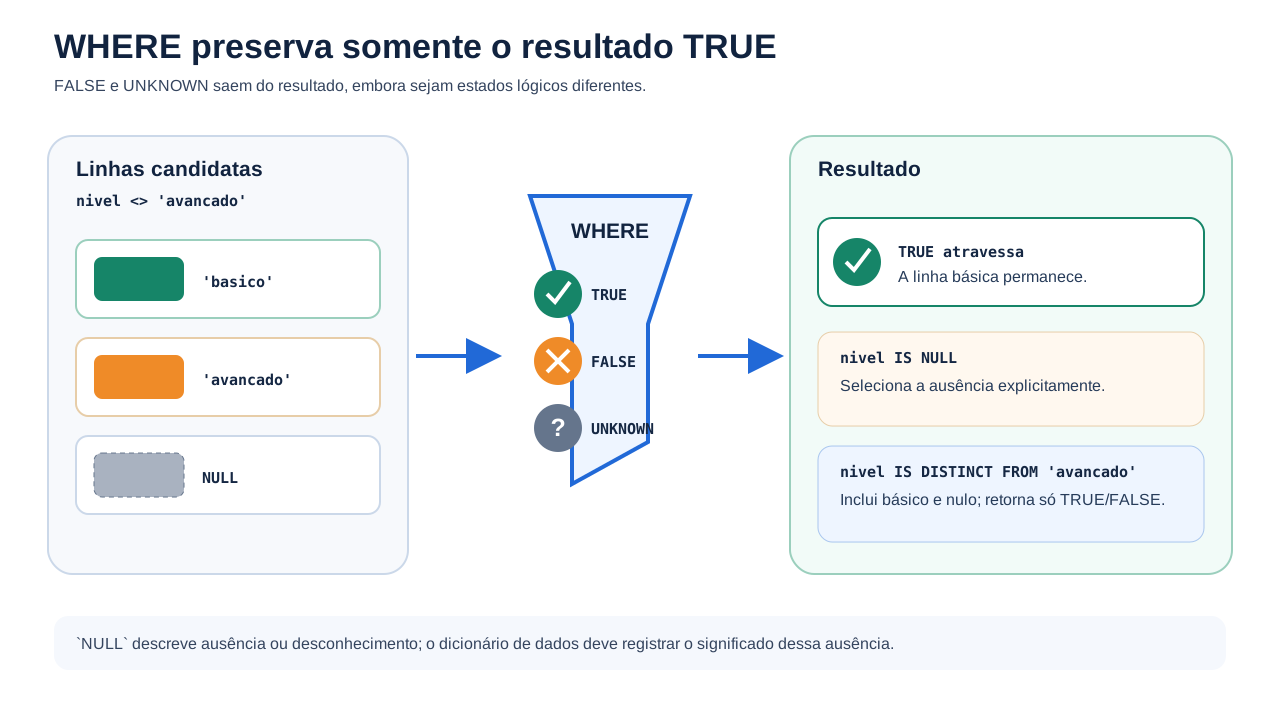
Além de TRUE e FALSE, uma expressão pode resultar em UNKNOWN, representado por NULL booleano. WHERE preserva somente TRUE; tanto FALSE quanto UNKNOWN são descartados.
Considere três trilhas com nivel: 'basico', 'avancado' e NULL.
SELECT titulo, nivel
FROM trilha
WHERE nivel <> 'avancado';
A linha com 'basico' permanece. A linha com 'avancado' produz FALSE. A linha com NULL produz UNKNOWN e também sai. Se a regra deseja “qualquer nível diferente de avançado, incluindo desconhecido”, declare isso:
WHERE nivel <> 'avancado'
   OR nivel IS NULL
Ou, quando disponível e semanticamente adequado:
WHERE nivel IS DISTINCT FROM 'avancado'
IS DISTINCT FROM trata NULL como valor comparável para esse teste e sempre retorna verdadeiro ou falso. IS NOT DISTINCT FROM funciona como igualdade que considera dois nulos equivalentes.
AND, OR e NOT propagam UNKNOWN
Alguns casos essenciais:
| A | B | A AND B | A OR B |
|---|---|---|---|
TRUE | UNKNOWN | UNKNOWN | TRUE |
FALSE | UNKNOWN | FALSE | UNKNOWN |
UNKNOWN | UNKNOWN | UNKNOWN | UNKNOWN |
NOT UNKNOWN continua UNKNOWN. O valor conhecido pode decidir a expressão: FALSE AND UNKNOWN já é falso; TRUE OR UNKNOWN já é verdadeiro.
NOT IN pode surpreender com NULL
WHERE situacao NOT IN ('arquivada', NULL)
Para uma situação diferente de 'arquivada', a comparação com o primeiro item é verdadeira para “diferente”, mas a comparação com NULL é desconhecida. A conjunção não chega a TRUE, e a linha é descartada. Evite nulos na lista e expresse a intenção positiva quando possível.
COALESCE substitui, mas também escolhe significado
COALESCE retorna o primeiro argumento não nulo:
SELECT
  titulo,
  COALESCE(nivel, 'nao informado') AS nivel_exibicao
FROM trilha;
Isso pode ser adequado na apresentação. Porém, substituir ausência por zero, vazio ou uma categoria real pode misturar estados distintos:
COALESCE(duracao_minutos, 0)
Agora “duração desconhecida” parece “duração zero”. Use a substituição somente quando os dois estados forem equivalentes para aquela operação.
DISTINCT elimina duplicatas da saída
SELECT DISTINCT situacao
FROM trilha;
DISTINCT considera a combinação completa das expressões selecionadas. Se a lista inclui situacao e nivel, duas linhas são duplicadas apenas quando esses dois valores coincidem segundo as regras aplicáveis.
SELECT DISTINCT situacao, nivel
FROM trilha;
Para eliminação de duplicatas, valores nulos na mesma posição são tratados como iguais no PostgreSQL. Isso não contradiz a lógica de NULL = NULL, que continua desconhecida: são operações com finalidades e regras diferentes.
ORDER BY é a única garantia de ordem
Sem ORDER BY, a ordem das linhas é não especificada. Ela pode mudar com volume, índices, paralelismo, estatísticas, versão ou plano de execução.
SELECT trilha_id, titulo, publicada_em
FROM trilha
ORDER BY publicada_em DESC;
ASC é ascendente; DESC é descendente. Para empates, acrescente critérios:
SELECT trilha_id, titulo, publicada_em
FROM trilha
ORDER BY
  publicada_em DESC,
  titulo ASC,
  trilha_id ASC;
Cada chave posterior só decide entre linhas empatadas nas anteriores. O identificador ao final cria uma ordem total quando é único.
Controle a posição de NULL
No PostgreSQL:
ORDER BY publicada_em DESC NULLS LAST, trilha_id ASC
NULLS FIRST e NULLS LAST deixam a intenção explícita. O padrão inicial de posicionamento pode variar por direção e por SGBD; declarar evita depender de uma convenção implícita.
Alias de saída pode ordenar
SELECT
  titulo,
  duracao_minutos / 60.0 AS duracao_horas
FROM trilha
ORDER BY duracao_horas DESC, titulo ASC;
No PostgreSQL, o alias pode aparecer sozinho em ORDER BY. Evite criar um alias igual ao nome de outra coluna disponível, pois a resolução pode ficar difícil de entender.
Ordenar por posição, como ORDER BY 2, também é aceito em diversos produtos, mas fica frágil quando a lista de saída muda. Prefira nomes ou expressões claros.
LIMIT recorta depois da ordenação
SELECT trilha_id, titulo, publicada_em
FROM trilha
WHERE situacao = 'publicada'
ORDER BY publicada_em DESC, trilha_id DESC
LIMIT 10;
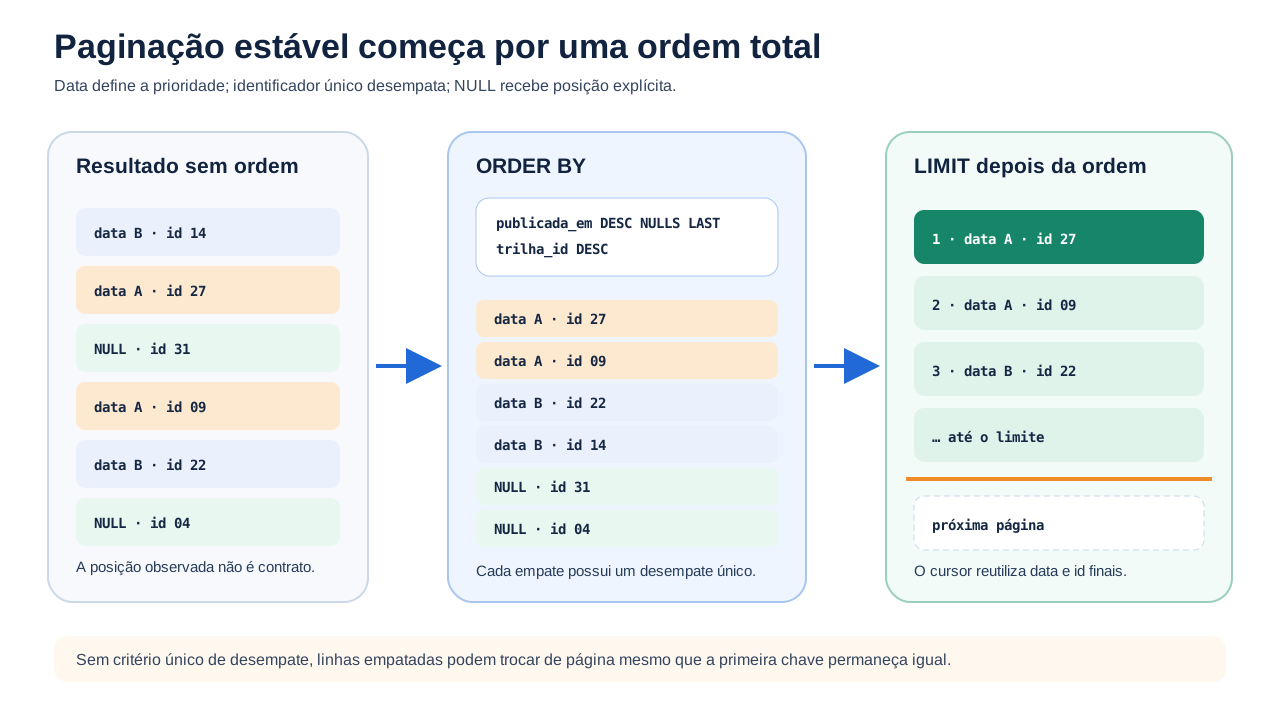
Sem ORDER BY, “as primeiras dez” não possui significado estável. Mesmo com uma coluna ordenada, empates podem trocar de posição; inclua uma chave única como desempate.
SELECT trilha_id, titulo, publicada_em
FROM trilha
WHERE situacao = 'publicada'
ORDER BY publicada_em DESC, trilha_id DESC
LIMIT 10 OFFSET 20;
OFFSET ignora linhas antes do recorte, mas o servidor ainda pode precisar calculá-las. Em páginas profundas, isso pode custar mais e sofrer deslocamento se linhas forem inseridas ou removidas entre requisições. Paginação por cursor — usando os últimos valores ordenados — costuma ser mais estável em fluxos dinâmicos, desde que preserve exatamente a mesma ordem total.
Um exemplo completo
Requisito: listar até dez trilhas publicadas desde 2026, com duração conhecida entre uma e cinco horas, priorizando as publicações mais recentes. Empates devem ser estáveis, e a saída precisa ter nomes adequados à API.
SELECT
  t.trilha_id AS id,
  t.titulo,
  ROUND(t.duracao_minutos / 60.0, 2) AS duracao_horas,
  t.publicada_em AS publicada_em
FROM trilha AS t
WHERE t.situacao = 'publicada'
  AND t.publicada_em >= DATE '2026-01-01'
  AND t.duracao_minutos BETWEEN 60 AND 300
ORDER BY
  t.publicada_em DESC,
  t.trilha_id DESC
LIMIT 10;
Leia a consulta por intenção:
FROMescolhe a fonte e cria o aliast;WHEREmantém somente linhas que cumprem todos os requisitos;SELECTdefine contrato e cálculo da saída;ORDER BYcria prioridade e desempate;LIMITrecorta o resultado já ordenado.
A condição de duração exclui NULL porque NULL BETWEEN 60 AND 300 resulta em UNKNOWN. Isso corresponde ao requisito “duração conhecida”. Se desconhecidas devessem aparecer, o predicado precisaria declarar essa opção.
Parametrize valores da aplicação
Valores fornecidos por uma interface devem seguir separados do texto SQL:
SELECT trilha_id, titulo
FROM trilha
WHERE situacao = $1
  AND publicada_em >= $2
ORDER BY publicada_em DESC, trilha_id DESC
LIMIT $3;
O formato $1, $2, $3 é comum em clientes PostgreSQL; outros drivers usam marcadores diferentes. Não concatene situação, data ou limite diretamente na instrução.
Parâmetros não substituem livremente identificadores, operadores ou ASC/DESC. Para ordenação escolhida pelo usuário, a aplicação deve mapear uma opção permitida para um trecho conhecido, em vez de aceitar sintaxe arbitrária.
Erros comuns
- usar
SELECT *como contrato permanente: mudanças no esquema alteram a saída; - imaginar que a ordem da tabela será preservada: somente
ORDER BYgarante apresentação; - ordenar sem desempate único: empates deixam páginas instáveis;
- usar alias de saída em
WHERE: essa etapa lógica ocorre antes da projeção; - escrever
= NULLou<> NULL: useIS NULL,IS NOT NULLou predicados distintos quando apropriado; - tratar
UNKNOWNcomoFALSEem toda lógica: ambos saem deWHERE, mas combinam de maneiras diferentes comAND,OReNOT; - usar
NOT INcom lista que pode conter nulo: o resultado pode nunca ser verdadeiro; - aplicar
COALESCEsem pensar no significado: ausência pode virar falsamente zero ou vazio; - adicionar
DISTINCTpara esconder duplicação incompreendida: investigue a granularidade; - usar
LIMITsem ordem total: o subconjunto pode variar; - concatenar filtros e ordenações vindos da interface: parametrize valores e permita apenas estruturas conhecidas;
- confundir ordem lógica com plano físico: o SGBD pode otimizar sem mudar a semântica.
Checklist de uma consulta previsível
- Qual é a granularidade de cada linha do resultado?
- Quais colunas realmente fazem parte do contrato?
- Cada filtro inclui e exclui exatamente os estados desejados?
- Como
NULLafeta cada comparação? - Os parênteses deixam
ANDeORinequívocos? DISTINCTé requisito real ou máscara para outra falha?- A ordem foi declarada?
- Existe um desempate único?
NULLS FIRSTouNULLS LASTprecisa ser explícito?LIMITe paginação usam essa mesma ordem total?- Entradas externas estão parametrizadas ou mapeadas por lista permitida?
- Nomes de saída comunicam significado ao consumidor?
O que você deve guardar
SELECT cria uma relação de resultado. FROM fornece as linhas; WHERE mantém apenas predicados verdadeiros; a lista de seleção projeta e nomeia colunas; DISTINCT elimina duplicatas da saída; ORDER BY estabelece a única ordem garantida; LIMIT recorta o conjunto depois dessa ordenação.
NULL representa ausência ou desconhecimento e introduz um terceiro resultado lógico. Comparações comuns com nulo não são verdadeiras nem falsas: são desconhecidas. Consultas corretas expressam explicitamente ausência, desempates e estados opcionais.
Na próxima aula, aprenderemos como JOINs combinam relações e quais linhas são preservadas por INNER, LEFT, RIGHT, FULL e CROSS JOIN.
Referências
- ISO — ISO/IEC 9075-1:2023, Database languages SQL — Framework. Acesso em 30 ago. 2026.
- PostgreSQL Global Development Group — SELECT. Acesso em 30 ago. 2026.
- PostgreSQL Global Development Group — Table Expressions and WHERE. Acesso em 30 ago. 2026.
- PostgreSQL Global Development Group — Select Lists and DISTINCT. Acesso em 30 ago. 2026.
- PostgreSQL Global Development Group — Comparison Functions and Operators. Acesso em 30 ago. 2026.
- PostgreSQL Global Development Group — Logical Operators. Acesso em 30 ago. 2026.
- PostgreSQL Global Development Group — Pattern Matching. Acesso em 30 ago. 2026.
- PostgreSQL Global Development Group — Sorting Rows. Acesso em 30 ago. 2026.
- PostgreSQL Global Development Group — LIMIT and OFFSET. Acesso em 30 ago. 2026.