
Bancos relacionais ou NoSQL: como escolher?
“Relacional ou NoSQL?” parece uma pergunta sobre produtos, mas começa antes deles. O sistema precisa preservar quais invariantes? Quais perguntas serão frequentes? Qual é a unidade atômica? Como os dados se relacionam? O que acontece durante uma partição de rede? Quem operará, protegerá e recuperará a solução?
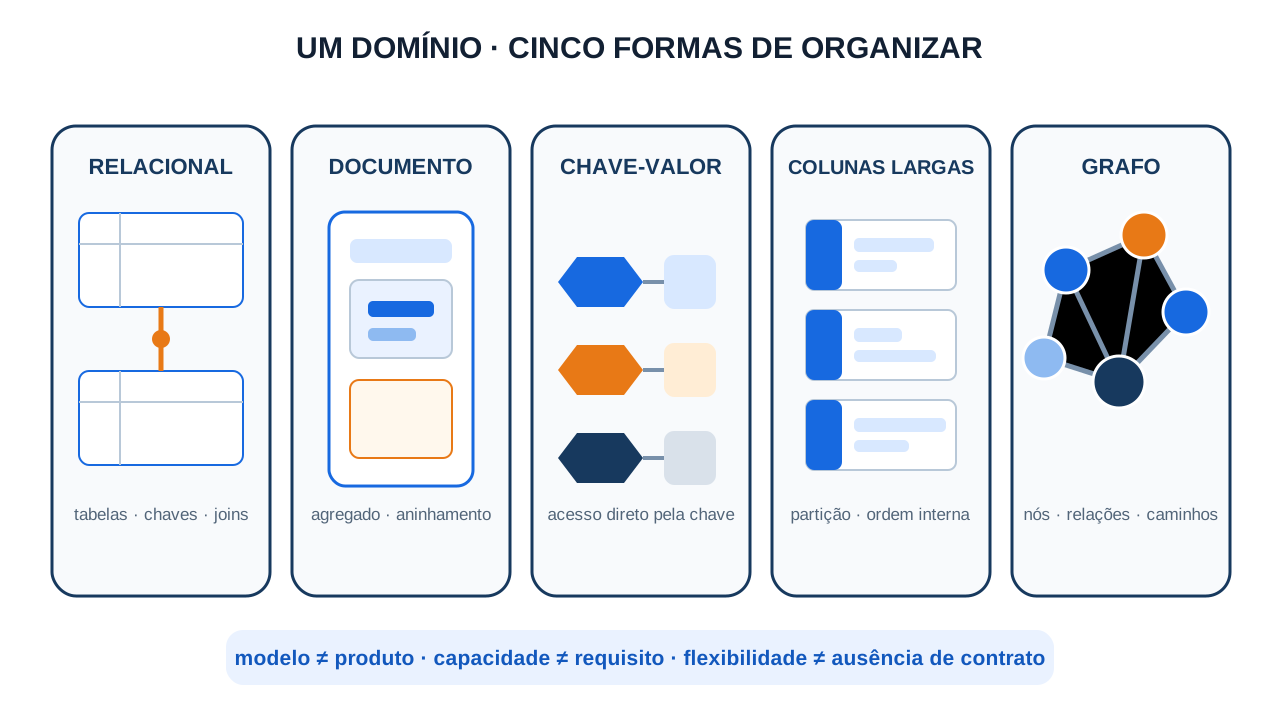
NoSQL não é um modelo único. Um banco documental, uma estrutura chave-valor, um banco de colunas largas e um grafo organizam dados e consultas de formas diferentes. “Escala” ou “flexibilidade” sem carga, volume, distribuição e requisito mensurável não decide entre eles.
Esta aula encerra a trilha conectando modelos de dados, modelo relacional, normalização, transações e operação segura numa decisão arquitetural.
Ao final, você deverá conseguir:
- explicar por que relacional versus NoSQL não é uma oposição binária;
- comparar relacional, documentos, chave-valor, colunas largas e grafos;
- transformar casos de uso em padrões de leitura e escrita;
- identificar agregados, relacionamentos, invariantes e fronteiras atômicas;
- distinguir consistência transacional, consistência de réplica e consistência no teorema CAP;
- evitar a classificação simplista “escolha duas letras do CAP”;
- avaliar particionamento, hot spots, distribuição e crescimento;
- reconhecer que schema flexível transfere validação, não elimina o contrato;
- calcular o custo operacional de uma nova tecnologia;
- propor persistência poliglota sem criar duas fontes de verdade acidentais;
- conduzir prova de conceito com dados, falhas e consultas representativas;
- registrar uma decisão reversível com critérios e gatilhos de revisão.
A escolha começa pela carga, não pela categoria
Considere o Guia Estudos. Há trilhas, módulos, conteúdos, autores, matrículas, progresso, buscas e recomendações. Antes de escolher um banco, descreva operações concretas:
| Operação | Entrada | Resultado | Frequência e escala | Garantia importante |
|---|---|---|---|---|
| abrir trilha | slug | módulos e conteúdos publicados em ordem | leitura frequente | não exibir conteúdo fora da trilha |
| registrar progresso | estudante, conteúdo, percentual | progresso atualizado | escrita concorrente | valor válido e matrícula existente |
| publicar conteúdo | conteúdo e versão | estado, data e evento | menor volume, alto valor | mudança e evento como unidade |
| buscar texto | termos e filtros | conteúdos ranqueados | variável | atraso de indexação declarado |
| recomendar próximos temas | estudante e relações | candidatos ordenados | exploração de conexões | explicação e atualização aceitáveis |
Agora aparecem perguntas úteis:
- módulos e conteúdos mudam juntos ou de forma independente?
- quais joins são centrais e quais são ocasionais?
- progresso precisa ser imediatamente consistente em todas as telas?
- busca pode estar alguns segundos atrasada em relação à publicação?
- a navegação usa profundidade conhecida ou caminhos variáveis?
- qual chave distribui carga sem concentrar um único tenant?
- qual operação precisa continuar durante perda de comunicação entre regiões?
O modelo relacional favorece fatos conectados e invariantes explícitos
No modelo relacional, fatos são representados por relações; chaves identificam linhas, foreign keys conectam fatos e constraints preservam regras. SQL permite compor consultas não previstas originalmente por seleção, projeção, join, agregação e janela.
Ele costuma ser uma escolha forte quando:
- há relacionamentos importantes em várias direções;
- transações abrangem múltiplas linhas ou tabelas;
- integridade referencial precisa ser imposta no banco;
- consultas analíticas e operacionais mudam com o tempo;
- relatórios combinam dimensões diferentes;
- a equipe domina SQL, migrações, monitoramento e recuperação;
- o domínio possui uma fonte de verdade transacional clara.
Exemplo: publicar um conteúdo, registrar a data e inserir um evento de saída pode ocorrer na mesma fronteira transacional. Foreign keys garantem que o conteúdo pertença a um módulo existente, enquanto consultas combinam trilhas, autores e progresso.
Relacional não significa formato incapaz de variar
PostgreSQL oferece arrays, tipos compostos, json e jsonb, busca textual, particionamento e extensões. Dados semiestruturados podem coexistir com colunas relacionais:
CREATE TABLE evento_conteudo (
  evento_id bigint GENERATED ALWAYS AS IDENTITY PRIMARY KEY,
  conteudo_id bigint NOT NULL REFERENCES conteudo,
  tipo text NOT NULL,
  ocorrido_em timestamptz NOT NULL,
  atributos jsonb NOT NULL DEFAULT '{}'::jsonb
);
Isso não transforma toda modelagem em “jogue tudo no JSON”. Identificadores, datas, estados e relações usados por constraints e consultas frequentes continuam melhores como colunas tipadas. Flexibilidade seletiva pode evitar uma segunda tecnologia prematura.
Relacional não significa apenas um servidor vertical
SGBDs relacionais oferecem réplicas, particionamento, paralelismo e diferentes arquiteturas distribuídas. Escalar horizontalmente ainda envolve chaves, consistência, roteamento e operação; mas “SQL não escala” é uma afirmação sem produto, topologia e carga.
O limite pode estar antes no SQL, no índice, no cache, no desenho da transação ou no volume devolvido, como vimos em índices e planos de execução.
Documento aproxima armazenamento de um agregado
Um banco documental armazena estruturas aninhadas, frequentemente semelhantes ao objeto lido pela aplicação. Um documento pode reunir uma trilha com metadados e módulos incorporados:
{
  "slug": "banco-de-dados-e-sql",
  "titulo": "Banco de Dados e SQL",
  "modulos": [
    {
      "ordem": 1,
      "titulo": "Fundamentos",
      "conteudos": [
        { "slug": "introducao", "titulo": "Introdução" }
      ]
    }
  ]
}
Embedding pode recuperar o agregado em uma operação e tornar atômicas mudanças dentro do mesmo documento. Ele funciona bem quando:
- os dados incorporados pertencem ao pai;
- são lidos e atualizados juntos;
- o conjunto aninhado tem tamanho limitado e previsível;
- duplicação é deliberada e possui estratégia de atualização;
- consultas importantes partem do agregado.
Incorporar ou referenciar é uma decisão central
Nem toda relação deve ser incorporada. Um autor participa de muitos conteúdos; copiar todo o perfil em cada documento cria várias representações. Referências reduzem duplicação, mas exigem consultas adicionais, agregações ou lógica da aplicação.
Evite arrays que crescem sem limite, como todas as matrículas dentro da trilha. O documento se torna ponto de contenção, aproxima-se do limite de tamanho e obriga reescrever uma estrutura ampla.
MongoDB oferece transações multidocumento, mas sua própria documentação recomenda que elas não substituam uma modelagem adequada: operações distribuídas têm custo, e a unidade documental continua relevante.
Schema flexível não significa ausência de schema
Mesmo sem uma definição rígida obrigatória para cada campo, existe contrato em:
- código da aplicação;
- validadores do banco;
- índices;
- serializadores e APIs;
- consumidores de eventos;
- painéis e pipelines analíticos.
Se versões diferentes escrevem formatos incompatíveis, a complexidade aparece nas leituras e migrações. Flexibilidade permite evolução gradual; não elimina governança, tipos, defaults nem compatibilidade.
Chave-valor otimiza acesso conhecido por uma chave
O modelo mais simples associa uma chave única a um valor. Se a operação conhece a chave, a rota é direta:
progresso:estudante:842:trilha:10 → estado serializado
É apropriado para casos como:
- cache com expiração;
- sessão e token revogável;
- contador ou limite de taxa;
- idempotência por identificador de operação;
- estado efêmero de processamento;
- consulta cujo acesso natural sempre começa pela chave.
Sistemas como Redis expõem estruturas além de strings — hashes, listas, sets, sorted sets, streams e outras — com operações próprias. “Chave-valor” não implica necessariamente valor opaco, mas o caminho primário continua centrado na chave e nas operações oferecidas.
Perguntas secundárias mudam o custo
Se você precisa encontrar “todos os estudantes ativos de uma região com progresso acima de 80%, ordenados por última atividade”, uma coleção de chaves individuais não oferece automaticamente esse acesso. Será necessário manter índices secundários, estruturas derivadas, busca externa ou escolher outro modelo.
Também defina o que ocorre quando o cache perde dados. Se a resposta for “reconstruir da fonte”, ele não é a fonte de verdade. Se não existe outra fonte, políticas de persistência, replicação, backup e consistência passam a ser requisitos centrais.
Colunas largas modelam consultas pela chave de partição
Bancos inspirados em Bigtable organizam grandes conjuntos particionados por chave e ordenados dentro da partição. O termo “colunar” aqui não é sinônimo automático de formato analítico colunar.
Uma tabela orientada à consulta poderia usar:
partition key: trilha_id
clustering: publicado_em DESC, conteudo_id
Isso facilita listar conteúdos recentes de uma trilha. Outra pergunta, como conteúdos por autor e situação, pode exigir outra tabela materializada especificamente para esse acesso.
O modelo é atraente quando:
- volume e taxa de escrita justificam distribuição horizontal;
- padrões de consulta são conhecidos e estáveis;
- acesso ocorre por chave de partição;
- desnormalização e duplicação são aceitas conscientemente;
- a equipe sabe operar replicação, compaction, reparos e capacidade;
- os requisitos de consistência cabem nas garantias e configurações do produto.
A chave de partição define equilíbrio e limites
Uma chave que concentra toda a carga em uma única partição cria hot spot. Uma chave aleatória distribui, mas pode dificultar consultas por intervalo. Partições que crescem indefinidamente elevam custo de leitura e manutenção.
Apache Cassandra, por exemplo, combina particionamento e replicação com consistência ajustável. Isso não significa “consistência opcional sem consequência”: escolha de níveis, resolução de conflitos, relógios, reparos e modelagem determinam o comportamento observável.
Grafo torna conexões parte central do modelo
Em um grafo de propriedades:
- nós representam entidades;
- relacionamentos conectam nós com direção e tipo;
- ambos podem carregar propriedades;
- consultas expressam padrões e percursos.
Exemplo conceitual:
(Estudante)-[:CONCLUIU]->(Conteúdo)-[:PERTENCE_A]->(Tema)
(Tema)-[:PRE_REQUISITO_DE]->(Tema)
Grafo é forte quando o valor está nos caminhos:
- recomendação por conexões e similaridade estrutural;
- dependências com profundidade variável;
- detecção de comunidades e padrões de fraude;
- impacto em redes de ativos;
- caminhos mínimos e vizinhanças de vários saltos;
- perguntas em que relações são tão importantes quanto entidades.
Ter relacionamentos não basta para exigir um grafo
Todo sistema de negócio possui relações. Um join entre conteúdo e módulo não justifica sozinho uma segunda tecnologia. Pergunte:
- a profundidade do percurso varia?
- novas relações precisam ser exploradas em várias direções?
- a consulta central é um padrão de conexões?
- o mesmo resultado relacional é simples, rápido e mais fácil de operar?
Modelos de grafo também possuem schema, índices, constraints, transações e decisões de particionamento conforme o produto. Eles não removem modelagem; mudam seus elementos principais.
Compare critérios na mesma linguagem
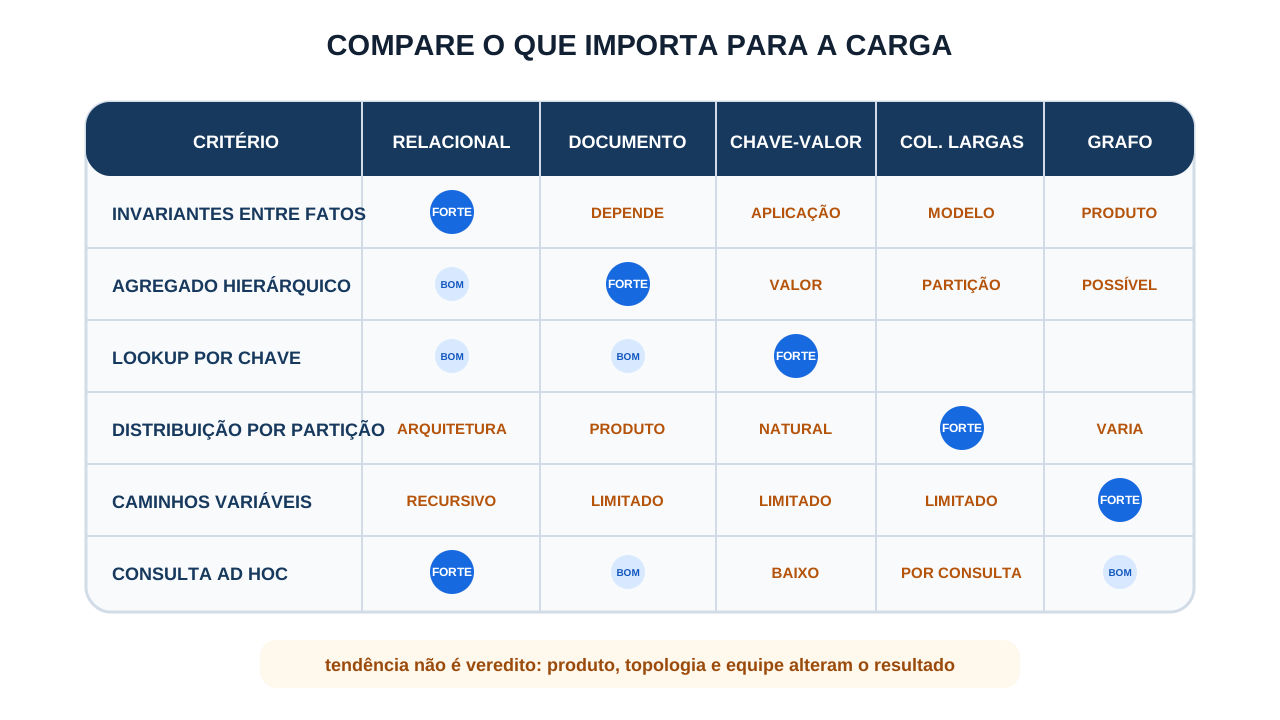
| Critério dominante | Relacional | Documento | Chave-valor | Colunas largas | Grafo |
|---|---|---|---|---|---|
| joins e consultas variadas | forte | depende de embedding/referência | limitado sem estruturas extras | exige modelar por consulta | forte para percursos |
| agregado hierárquico | possível | natural | valor pode conter agregado | possível por partição | possível, não central |
| lookup por chave | forte com índice | forte por identificador | central | central pela partição | índice encontra nó inicial |
| integridade entre entidades | constraints e transações maduras | depende da fronteira e recursos | frequentemente na aplicação | frequentemente desnormalizada | constraints variam por produto |
| profundidade variável | CTE recursiva ou extensão | pouco natural | pouco natural | pouco natural | central |
| consulta ad hoc | linguagem relacional ampla | depende de índices e recursos | baixa | baixa fora do desenho | ampla para padrões de grafo |
| distribuição horizontal | possível, com arquitetura | comum em produtos distribuídos | comum | parte central do modelo | varia bastante |
| custo de duplicação | normalização reduz | embedding pode duplicar | estruturas derivadas duplicam | tabelas por consulta duplicam | propriedades e projeções podem duplicar |
Não transforme a tabela em placar. “Forte” num critério irrelevante não agrega valor. Uma solução simples que atende todos os requisitos é normalmente preferível a uma sofisticada que atende uma hipótese futura.
Consistência possui significados diferentes
Três usos aparecem frequentemente:
- Consistência em ACID: a transação preserva invariantes definidos.
- Consistência de réplicas: quais versões diferentes clientes podem observar e quando convergem.
- Consistência no CAP: propriedade formal semelhante a um único registro atômico/linearizável no modelo estudado.
Misturá-los produz frases enganosas como “NoSQL não tem consistência” ou “ACID impede escala”. Produtos relacionais e não relacionais oferecem combinações distintas de transações, replicação, quóruns, leituras e garantias de sessão.
CAP não é um cardápio permanente de duas letras
O resultado formal de Gilbert e Lynch mostra que, diante de uma partição de rede no modelo assíncrono, não é possível garantir simultaneamente consistência atômica e disponibilidade para todas as requisições segundo as definições do artigo.
Isso não significa:
- escolher livremente “duas de três” em qualquer situação;
- que o sistema fica permanentemente sem consistência ou disponibilidade;
- que latência e operação cotidiana desaparecem da análise;
- que todos os produtos rotulados AP ou CP se comportam igual;
- que replicar por si só torna um banco escalável e correto.
Descreva o comportamento exigido durante falha:
- uma matrícula pode aceitar escrita numa região isolada?
- duas escritas concorrentes podem ser mescladas?
- saldo ou permissão pode operar com dado antigo?
- leitura após a própria escrita precisa ver o valor novo?
- qual conflito será detectado, rejeitado ou resolvido?
“Consistência eventual” só informa que réplicas tendem a convergir quando novas atualizações cessam e a comunicação permite. Ainda faltam limites, garantias de sessão, resolução de conflitos e semântica da operação.
Escala é multidimensional
Registre pelo menos:
- volume total e crescimento;
- leituras e escritas por segundo;
- tamanho e variação dos itens;
- distribuição por tenant, região e chave;
- proporção de leituras e escritas;
- latência p50, p95 e p99;
- picos, sazonalidade e backfill;
- retenção e expiração;
- necessidade de consultas globais;
- disponibilidade e perda tolerável.
Um terabyte com acesso baixo pode ser mais simples que cem gigabytes com milhões de escritas concentradas por segundo. Média esconde hot keys e partições desequilibradas.
Particionar muda as operações possíveis
Quando dados são divididos entre nós, operações dentro de uma partição tendem a ser mais simples que agregações globais, joins distribuídos e transações entre partições. A chave precisa alinhar distribuição e consultas.
Teste:
- maior tenant, não apenas tenant médio;
- chave mais popular;
- crescimento de uma partição ao longo do tempo;
- reequilíbrio ao adicionar ou perder nó;
- consulta que atravessa muitas partições;
- recuperação durante carga;
- custo financeiro de tráfego, armazenamento e réplicas.
NoSQL não remove esses problemas; frequentemente os torna parte explícita da modelagem.
Operação pode decidir mais que o benchmark
Uma tecnologia nova exige:
- provisionamento e atualização;
- autenticação, autorização e auditoria;
- criptografia e gestão de segredos;
- monitoramento, alertas e capacity planning;
- backup, restauração e recuperação pontual;
- teste de falha e procedimento de incidente;
- profissionais capazes de diagnosticar produção;
- drivers, pools, migrações e compatibilidade;
- ambientes de desenvolvimento e teste;
- governança de custo e suporte.
Um benchmark que reduz uma consulta de 20 ms para 5 ms pode não compensar duplicar a superfície operacional. Por outro lado, uma capacidade essencial — como percorrer milhões de relações variáveis ou sustentar escrita distribuída com requisito específico — pode justificar essa complexidade.
Serviço gerenciado transfere tarefas, mas não a responsabilidade por modelagem, limites, custo, segurança, recuperação e dependência do fornecedor.
Persistência poliglota é possível, mas cobra coordenação
O Guia Estudos poderia usar:
- PostgreSQL como fonte de verdade para catálogo, publicação e progresso;
- chave-valor para cache e limite de taxa;
- mecanismo de busca para índice textual;
- grafo para experimentar recomendações por relações.
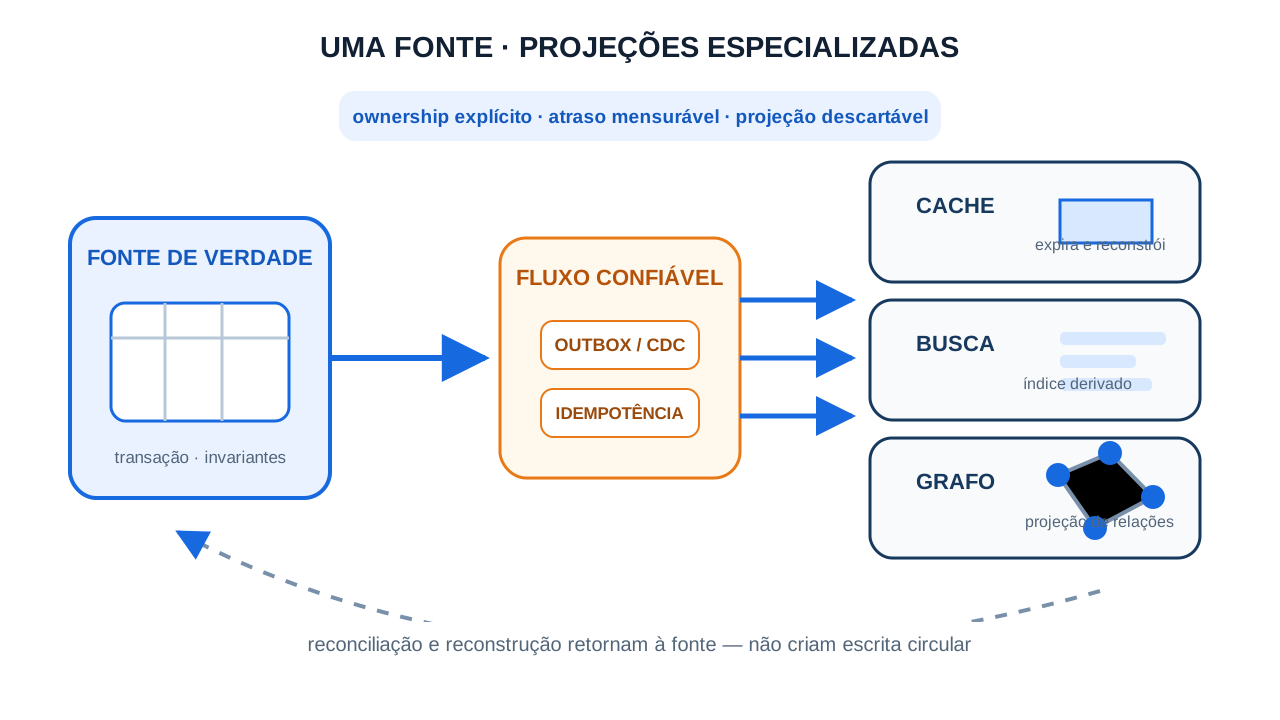
Essa arquitetura só é saudável se responder:
- qual sistema é autoritativo para cada fato?
- quem pode escrever em cada representação?
- como mudanças são publicadas de forma confiável?
- qual atraso é aceitável?
- como eventos duplicados ou fora de ordem são tratados?
- como reconstruir uma projeção do zero?
- como detectar e reconciliar divergência?
- o que acontece quando o destino está indisponível?
Dual write ingênuo cria estados contraditórios
Este fluxo é frágil:
- confirmar publicação no banco relacional;
- atualizar índice documental;
- a segunda chamada falha;
- devolver erro e repetir tudo;
O primeiro commit já ocorreu. A repetição pode duplicar efeitos. Padrões como transactional outbox, captura de mudanças e consumidores idempotentes tornam a sincronização observável, mas ainda exigem atraso, retry, deduplicação e reconciliação.
Não permita escrita bidirecional por conveniência. Se busca ou cache são projeções, devem poder ser descartados e reconstruídos da fonte autoritativa.
Uma prova de conceito precisa tentar derrubar a hipótese
Antes de adotar uma tecnologia, escreva uma decisão provisória:
Contexto: catálogo com 2 milhões de conteúdos e 50 mil leituras/s.
Operação crítica: listar 20 conteúdos publicados por trilha em até 80 ms no p99.
Invariantes: publicação referencia módulo; slug é único por trilha.
Falha: durante partição regional, leitura pode ficar 30 s atrasada; publicação deve parar.
Hipótese: modelo X reduz custo operacional e atende a distribuição.
Alternativa base: PostgreSQL particionado + cache.
Depois teste com:
- distribuição realista, inclusive valores extremos;
- consultas completas, não apenas lookup feliz;
- escrita, atualização, exclusão e expiração;
- concorrência e retry;
- índices e compaction estabilizados;
- nó lento, perda de rede e reequilíbrio;
- backup e restauração medidos;
- alteração de schema com duas versões da aplicação;
- custo de armazenamento, transferência e réplicas;
- observabilidade e diagnóstico por quem ficará de plantão.
Compare contra uma linha de base bem configurada. Um protótipo NoSQL não deve competir com SQL sem índice, nem o contrário.
Critérios de saída evitam uma demonstração infinita
Defina antes:
- metas de latência e throughput;
- resultado correto sob concorrência e falha;
- RPO e RTO;
- limite de custo;
- tempo aceitável de operação e diagnóstico;
- funcionalidades que precisam ser desenvolvidas na aplicação;
- condição que reprova a alternativa.
Registrar apenas média de latência sem falhas, cauda, consistência e custo não valida arquitetura.
Um roteiro de decisão reduz vieses
1. Modele o domínio e os invariantes
Liste entidades, relações, multiplicidades, regras e unidades que mudam juntas. Se muitas regras atravessam entidades e precisam de transação, o relacional merece ser a linha de base.
2. Catalogue padrões de acesso
Para cada operação, registre chave inicial, filtros, ordenação, cardinalidade, frequência e projeção. Documentos e colunas largas dependem especialmente dessas perguntas.
3. Defina consistência por operação
Não use um adjetivo global. Publicação, cache, recomendação e analytics podem aceitar contratos diferentes.
4. Quantifique escala e falhas
Use distribuição, picos, hot keys, regiões e crescimento. Declare comportamento durante partição, indisponibilidade e atraso de réplica.
5. Avalie capacidades existentes
Particionamento, jsonb, índices especializados, cache ou extensão no banco atual podem resolver a necessidade com menos componentes.
6. Calcule o custo total
Inclua pessoas, migração, sincronização, observabilidade, backup, testes, suporte e saída do fornecedor — não apenas preço por armazenamento.
7. Valide e documente
Execute prova de conceito, registre evidências, escolha, alternativas rejeitadas, riscos, mitigação e data de revisão.
Erros comuns
- tratar NoSQL como um produto ou modelo único: famílias possuem contratos muito diferentes;
- escolher pelo volume sem padrão de acesso: tamanho sozinho não determina estrutura;
- afirmar que SQL não escala: falta produto, arquitetura, carga e limite mensurável;
- afirmar que NoSQL não possui transações: capacidades variam e precisam ser verificadas;
- assumir que flexibilidade elimina schema: o contrato migra para aplicação, índices e consumidores;
- incorporar coleções ilimitadas em um documento: tamanho e contenção crescem sem controle;
- usar chave-valor e depois exigir consultas ad hoc: índices derivados aparecem sem planejamento;
- escolher chave de partição pela cardinalidade média: hot keys e maiores tenants dominam o risco;
- duplicar dados sem ownership: versões divergentes não têm regra de reconciliação;
- usar grafo porque existem foreign keys: a consulta central pode continuar simples no relacional;
- interpretar CAP como escolha permanente de duas letras: o resultado formal trata partições e definições específicas;
- chamar eventual de “vai ficar certo”: faltam prazo, conflito e garantia de sessão;
- comparar benchmark artificial com banco atual mal configurado: a linha de base fica inválida;
- medir somente throughput médio: cauda, erro e recuperação podem reprovar a solução;
- adotar persistência poliglota sem fonte de verdade: qualquer sistema pode sobrescrever o outro;
- fazer dual write sem protocolo: commits parciais criam contradição;
- considerar serviço gerenciado sem operação: limites, custos, segurança e restore continuam existindo;
- decidir pelo currículo da equipe sem reconhecer lacuna: familiaridade importa, mas risco precisa ser explícito;
- escolher por tendência ou currículo pessoal: arquitetura passa a servir à tecnologia;
- não definir saída: migração futura pode exigir reescrever dados e comportamento.
Checklist de escolha
- Quais fatos e invariantes são autoritativos?
- Qual é a unidade que precisa de atomicidade?
- Quais relações são centrais e em quais direções são consultadas?
- Quais operações representam 90% da carga?
- Qual chave inicia cada acesso?
- Consultas ad hoc são requisito ou exceção?
- Agregados aninhados têm tamanho limitado?
- Duplicação possui proprietário e estratégia de atualização?
- Qual consistência cada operação precisa observar?
- O que o sistema faz durante uma partição de rede?
- Quais garantias de sessão — read-your-writes, monotonic reads — são necessárias?
- Volume, taxa, picos, hot keys e crescimento foram quantificados?
- A chave de partição distribui o maior caso real?
- O banco atual foi medido e otimizado como linha de base?
- Recursos híbridos do banco atual resolvem o requisito?
- A equipe consegue monitorar, proteger e recuperar a alternativa?
- Backup, restore, RPO e RTO foram testados?
- Migração e evolução de schema funcionam com versões simultâneas?
- O custo inclui réplicas, tráfego, suporte e pessoas?
- Existe dependência proprietária e plano de saída?
- Numa arquitetura poliglota, qual é a fonte de verdade de cada fato?
- Sincronização possui outbox/CDC, idempotência e reconciliação?
- Projeções podem ser reconstruídas?
- A prova de conceito inclui dados extremos e falhas?
- A decisão registra hipóteses, evidências e gatilhos de revisão?
O que você deve guardar
Relacional, documento, chave-valor, colunas largas e grafo são formas de aproximar dados das regras e perguntas do sistema. Nenhuma vence em abstrato. Relacional oferece composição e integridade fortes; documentos favorecem agregados; chave-valor atende acesso direto; colunas largas alinham particionamento e consultas conhecidas; grafos tornam percursos protagonistas.
Consistência, escala e flexibilidade precisam ser descritas por operação. Persistência poliglota pode entregar valor, mas acrescenta sincronização e operação. A decisão mais madura costuma começar pela solução conhecida que atende os requisitos e só adicionar outro modelo quando evidências justificam sua complexidade.
Você concluiu a trilha de Banco de Dados e SQL. Use o checklist desta aula para revisar sistemas reais e retorne às aulas anteriores sempre que a decisão exigir aprofundar modelagem, consultas, transações, desempenho ou operação.
Referências
- ISO — ISO/IEC 9075-2:2023, SQL/Foundation. Acesso em 30 ago. 2026.
- PostgreSQL Global Development Group — JSON Functions and Operators. Acesso em 30 ago. 2026.
- MongoDB — Embedded Data in Your MongoDB Schema. Acesso em 30 ago. 2026.
- MongoDB — Transactions. Acesso em 30 ago. 2026.
- Redis — Redis data types. Acesso em 30 ago. 2026.
- Apache Cassandra — Architecture Overview. Acesso em 30 ago. 2026.
- Neo4j — Graph database concepts. Acesso em 30 ago. 2026.
- Gilbert, Seth; Lynch, Nancy — Brewer's Conjecture and the Feasibility of Consistent, Available, Partition-Tolerant Web Services. ACM SIGACT News, 2002.
- DeCandia et al. — Dynamo: Amazon's Highly Available Key-value Store. SOSP, 2007.
- Chang et al. — Bigtable: A Distributed Storage System for Structured Data. OSDI, 2006.