
Subconsultas, CTEs, operações de conjunto e funções de janela
Consultas avançadas criam camadas sem perder o contrato das linhas
Depois de aprender como agregações resumem conjuntos com GROUP BY e HAVING, surge uma nova necessidade: combinar etapas, comparar resultados e calcular métricas relativas sem destruir o detalhe original.
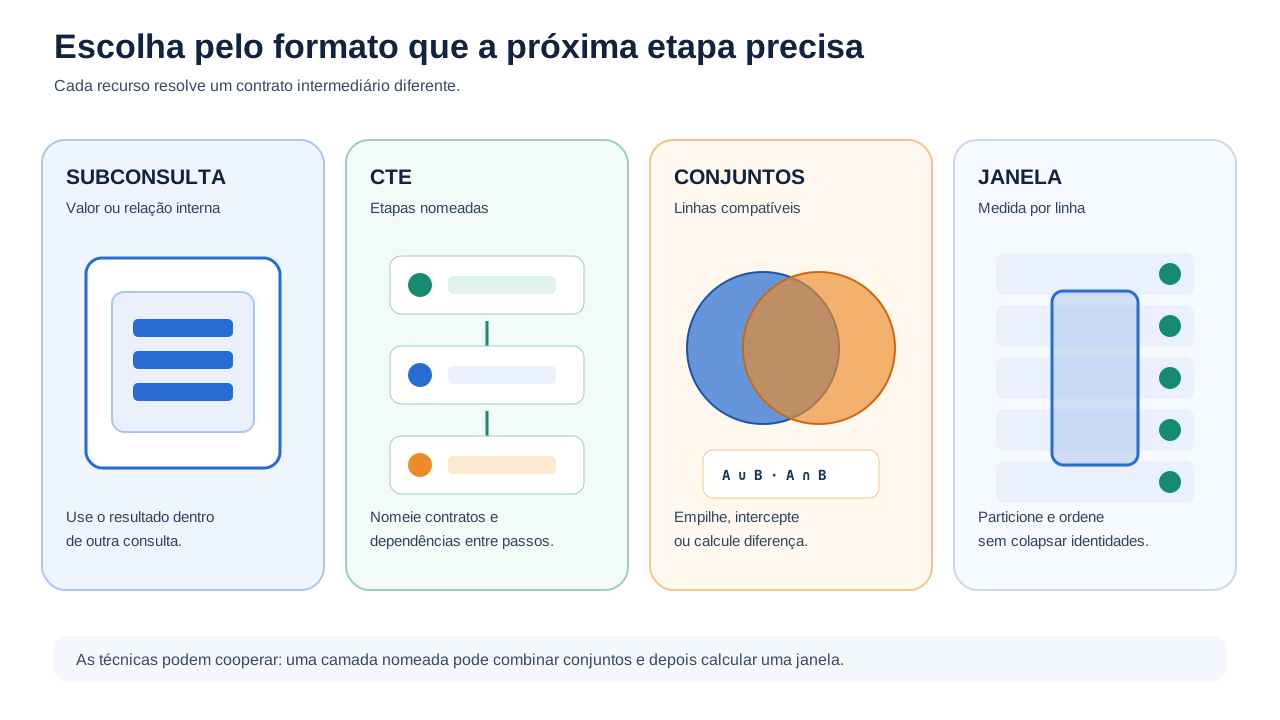
Quatro famílias resolvem problemas diferentes:
| Recurso | Pergunta principal |
|---|---|
| subconsulta | preciso usar o resultado de uma consulta dentro de outra? |
CTE com WITH | vale nomear etapas para tornar o fluxo explícito ou reutilizável? |
UNION, INTERSECT, EXCEPT | quero combinar linhas de resultados compatíveis? |
| função de janela | quero calcular sobre linhas relacionadas sem colapsá-las? |
Subconsulta produz um resultado para outra consulta
Uma subconsulta é um SELECT inserido em uma expressão ou em uma fonte de outra consulta. Seu formato esperado depende do contexto.
Subconsulta escalar deve entregar um valor
SELECT
  titulo,
  duracao_minutos
FROM trilha
WHERE duracao_minutos > (
  SELECT AVG(duracao_minutos)
  FROM trilha
  WHERE situacao = 'publicada'
);
A consulta interna calcula uma linha e uma coluna: a duração média. A externa compara cada trilha com esse valor.
Se uma subconsulta escalar retornar mais de uma linha, o PostgreSQL gera erro; se não retornar linha, o resultado escalar é NULL. Por isso, não use LIMIT 1 para esconder uma cardinalidade incompreendida. Garanta por agregação, chave única ou regra explícita que existe no máximo um valor.
Subconsulta em FROM cria uma relação derivada
SELECT
  resumo.trilha_id,
  resumo.total_matriculas
FROM (
  SELECT trilha_id, COUNT(*) AS total_matriculas
  FROM matricula
  GROUP BY trilha_id
) AS resumo
WHERE resumo.total_matriculas >= 2;
A consulta interna possui sua própria granularidade — uma linha por trilha — e passa a funcionar como uma fonte. O alias resumo torna suas colunas referenciáveis na camada externa.
Esse padrão resolve o problema encontrado na aula anterior: depois de calcular a medida em uma camada, a próxima camada pode filtrá-la, juntá-la ou ordená-la.
EXISTS testa existência sem multiplicar a linha externa
Requisito: listar trilhas que possuem pelo menos uma matrícula ativa.
SELECT t.trilha_id, t.titulo
FROM trilha AS t
WHERE EXISTS (
  SELECT 1
  FROM matricula AS m
  WHERE m.trilha_id = t.trilha_id
    AND m.situacao = 'ativa'
);
Essa é uma subconsulta correlacionada: ela referencia t.trilha_id da consulta externa. Para cada linha externa considerada, pergunta se existe ao menos uma correspondência.
EXISTS depende da presença de uma linha, não das colunas selecionadas. SELECT 1 comunica esse propósito. Mesmo que haja dez matrículas, a trilha aparece uma vez; um JOIN detalhado poderia multiplicá-la.
NOT EXISTS expressa ausência de forma segura
SELECT t.trilha_id, t.titulo
FROM trilha AS t
WHERE NOT EXISTS (
  SELECT 1
  FROM matricula AS m
  WHERE m.trilha_id = t.trilha_id
);
Isso representa um anti-join: trilhas sem matrícula correspondente.
NOT IN (subconsulta) pode produzir UNKNOWN quando o resultado interno contém NULL, eliminando linhas inesperadamente. Quando a intenção é ausência correlacionada, NOT EXISTS costuma tornar a regra de correspondência e a semântica de nulos mais explícitas.
IN, ANY e ALL comparam contra conjuntos
WHERE trilha_id IN (
  SELECT trilha_id
  FROM destaque
)
IN equivale conceitualmente a = ANY. ANY é verdadeiro quando ao menos uma comparação é verdadeira; ALL, quando todas são verdadeiras — inclusive no conjunto vazio. Nulos podem levar o resultado a UNKNOWN. Use essas formas quando a quantificação faz parte da pergunta, não apenas para encurtar uma lista.
CTE nomeia uma ou mais etapas da consulta
Common Table Expression (CTE), ou expressão de tabela comum, é definida por WITH e existe durante aquela instrução.
WITH matriculas_por_trilha AS (
  SELECT
    trilha_id,
    COUNT(*) AS total
  FROM matricula
  WHERE situacao = 'ativa'
  GROUP BY trilha_id
)
SELECT
  t.titulo,
  m.total
FROM matriculas_por_trilha AS m
JOIN trilha AS t
  ON t.trilha_id = m.trilha_id
ORDER BY m.total DESC, t.trilha_id;
A CTE não cria automaticamente uma tabela persistente, view ou índice. Ela dá nome a um resultado intermediário dentro do escopo da instrução.
Use nomes que expliquem o fato produzido
Compare dados1, temp e cte_final com matriculas_ativas_por_trilha. O segundo grupo de nomes descreve fonte, filtro e granularidade. Uma sequência de CTEs deve ser legível como transformação:
WITH matriculas_ativas AS (...),
totais_por_trilha AS (...),
trilhas_elegiveis AS (...)
SELECT ...;
Não divida cada linha de SQL em uma CTE. Nomeie uma etapa quando ela possui contrato próprio, elimina repetição ou torna uma regra verificável isoladamente.
CTE não é sinônimo universal de materialização
No PostgreSQL atual, uma CTE SELECT não recursiva, sem efeitos colaterais e referenciada uma vez pode ser incorporada à consulta externa. CTEs referenciadas várias vezes podem ser materializadas; MATERIALIZED e NOT MATERIALIZED permitem influenciar essa decisão em casos específicos.
Esse comportamento depende do produto e da versão. Não escolha CTE porque “sempre executa uma vez” nem a rejeite porque “sempre impede otimização”. Verifique o plano quando desempenho for uma preocupação real — tema aprofundado na aula de índices e planos de execução.
WITH RECURSIVE percorre relações hierárquicas
Uma CTE recursiva possui um termo inicial e um termo que referencia o próprio resultado, unidos geralmente por UNION ALL:
WITH RECURSIVE pre_requisitos AS (
  SELECT
    conteudo_id,
    pre_requisito_id,
    1 AS profundidade
  FROM conteudo
  WHERE conteudo_id = $1

  UNION ALL

  SELECT
    c.conteudo_id,
    c.pre_requisito_id,
    p.profundidade + 1
  FROM conteudo AS c
  JOIN pre_requisitos AS p
    ON c.conteudo_id = p.pre_requisito_id
  WHERE p.profundidade < 20
)
SELECT *
FROM pre_requisitos
ORDER BY profundidade, conteudo_id;
O termo inicial alimenta uma tabela de trabalho; o termo recursivo gera a próxima rodada até não produzir novas linhas. Hierarquias com ciclos exigem detecção explícita. Um limite de profundidade pode ser defesa adicional, mas não substitui a modelagem e o rastreamento de caminhos.
Operações de conjunto combinam linhas, não colunas
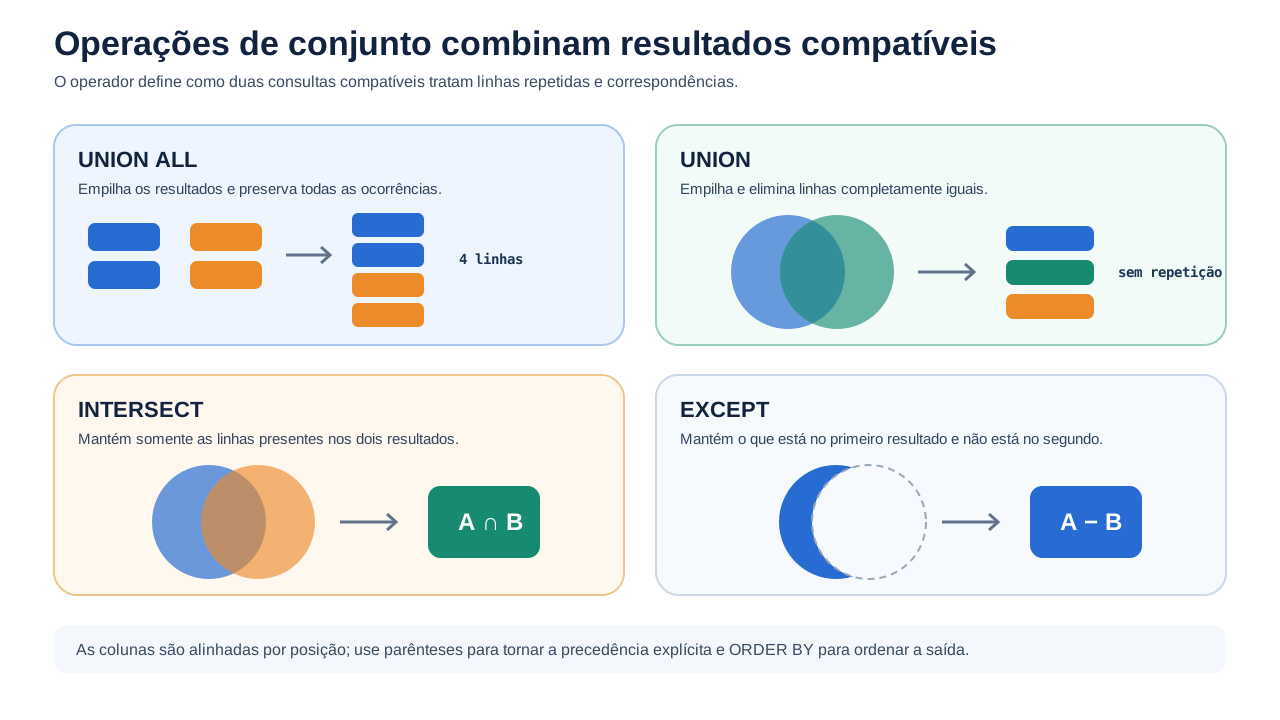
JOINs combinam colunas de linhas relacionadas. Operações de conjunto empilham ou comparam resultados com o mesmo formato.
SELECT estudante_id, 'matricula' AS origem
FROM matricula

UNION ALL

SELECT estudante_id, 'favorito' AS origem
FROM favorito;
As consultas devem ser compatíveis: mesma quantidade de colunas e tipos correspondentes compatíveis. Os nomes da saída são determinados pela primeira consulta; aliases posteriores não mudam o contrato final.
UNION e UNION ALL
UNIONcombina os dois resultados e elimina linhas duplicadas completas;UNION ALLpreserva todas as ocorrências.
Use UNION ALL quando duplicidade tem significado ou quando as fontes já são disjuntas. Não escolha UNION apenas como proteção contra dados incompreendidos: a eliminação possui custo e pode esconder fatos legítimos.
INTERSECT encontra o que está nos dois resultados
SELECT estudante_id
FROM matricula
WHERE situacao = 'ativa'

INTERSECT

SELECT estudante_id
FROM favorito
WHERE favorito = true;
O resultado contém estudantes presentes nos dois conjuntos. Sem ALL, duplicatas são eliminadas.
EXCEPT calcula diferença direcional
SELECT estudante_id
FROM estudante

EXCEPT

SELECT estudante_id
FROM matricula;
O resultado contém estudantes que aparecem na primeira consulta e não na segunda. A direção importa: A EXCEPT B não equivale a B EXCEPT A.
Parênteses deixam precedência e LIMIT inequívocos
No PostgreSQL, INTERSECT tem precedência maior que UNION e EXCEPT; os dois últimos associam da esquerda para a direita. Prefira parênteses quando houver mais de uma operação:
(consulta_a UNION consulta_b)
EXCEPT
consulta_c
Também use parênteses para aplicar ORDER BY ou LIMIT a uma entrada específica. Um ORDER BY final organiza o resultado combinado; a operação por si só não garante ordem.
Função de janela calcula sem colapsar as linhas
Uma agregação comum transforma várias linhas em uma linha por grupo. Uma função de janela calcula sobre linhas relacionadas, mas mantém cada linha individual.
SELECT
  trilha_id,
  estudante_id,
  progresso_percentual,
  AVG(progresso_percentual) OVER (
    PARTITION BY trilha_id
  ) AS media_da_trilha
FROM matricula;
Cada matrícula permanece visível e recebe a média de sua trilha.
PARTITION BY reinicia o cálculo
ROW_NUMBER() OVER (
  PARTITION BY trilha_id
  ORDER BY progresso_percentual DESC, matricula_id
)
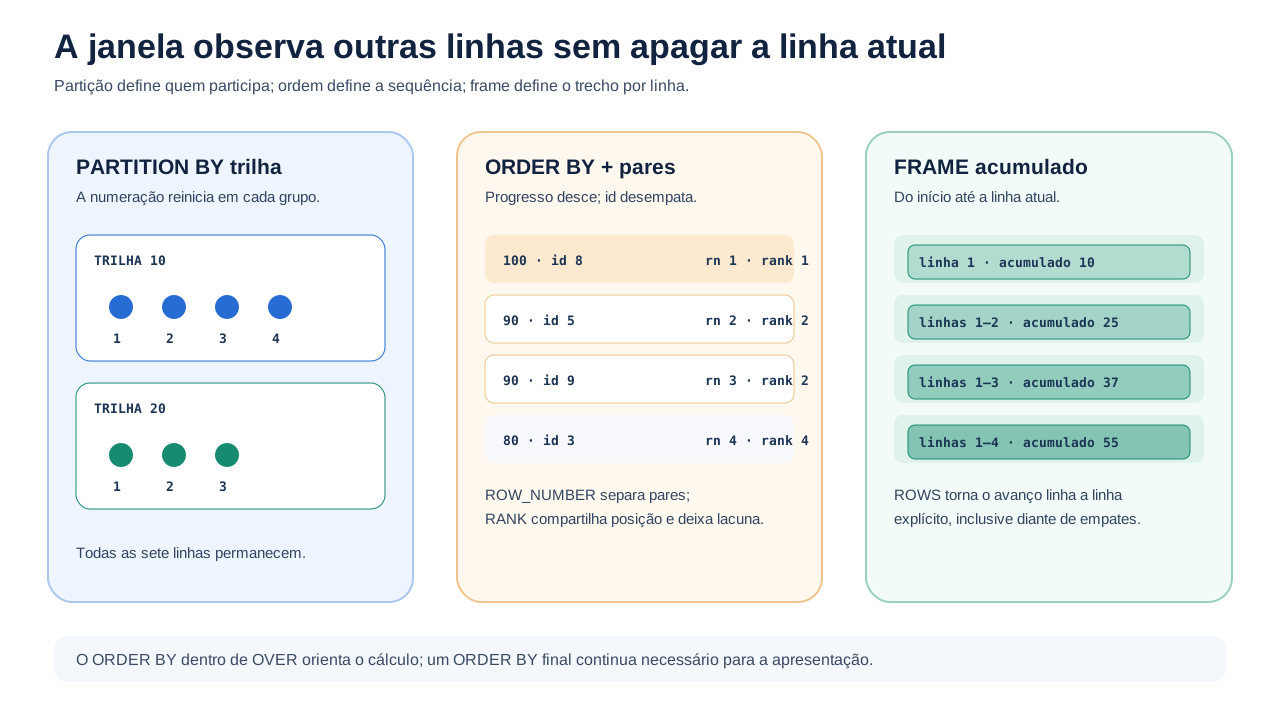
Cada trilha forma uma partição. A numeração reinicia em 1 quando a trilha muda. Sem PARTITION BY, todas as linhas pertencem à mesma partição.
ORDER BY dentro de OVER define sequência analítica
A ordem da janela não garante a ordem de apresentação. Declare ambas quando necessárias:
SELECT
  trilha_id,
  estudante_id,
  ROW_NUMBER() OVER (
    PARTITION BY trilha_id
    ORDER BY progresso_percentual DESC, matricula_id
  ) AS posicao
FROM matricula
ORDER BY trilha_id, posicao;
O identificador único desempata progressos iguais. Sem ele, ROW_NUMBER pode atribuir posições diferentes entre execuções para linhas empatadas.
ROW_NUMBER, RANK e DENSE_RANK tratam empates de modos distintos
Para valores 100, 90, 90, 80:
| valor | ROW_NUMBER | RANK | DENSE_RANK |
|---|---|---|---|
| 100 | 1 | 1 | 1 |
| 90 | 2 ou 3 | 2 | 2 |
| 90 | 3 ou 2 | 2 | 2 |
| 80 | 4 | 4 | 3 |
ROW_NUMBERdistingue todas as linhas e precisa de desempate total;RANKdá a mesma posição aos pares e deixa lacunas;DENSE_RANKdá a mesma posição sem lacunas.
Escolha pela regra do domínio: “duas linhas”, “duas melhores posições com empates” e “dois valores distintos” são perguntas diferentes.
LAG e LEAD acessam linhas vizinhas
SELECT
  matricula_id,
  registrada_em,
  progresso_percentual,
  LAG(progresso_percentual) OVER (
    PARTITION BY estudante_id, trilha_id
    ORDER BY registrada_em, matricula_id
  ) AS progresso_anterior
FROM historico_progresso;
LAG acessa uma linha anterior; LEAD, uma posterior, segundo a ordem da janela. Na primeira linha, LAG retorna NULL se nenhum valor padrão for fornecido.
O frame limita quais linhas participam
Em agregações usadas como janela, o frame pode mudar o resultado:
SUM(minutos_estudados) OVER (
  PARTITION BY estudante_id
  ORDER BY estudado_em, sessao_id
  ROWS BETWEEN UNBOUNDED PRECEDING AND CURRENT ROW
) AS minutos_acumulados
Esse frame produz acumulado desde a primeira sessão até a linha atual. PARTITION BY define o universo do estudante; ORDER BY define a sequência; ROWS ... define o trecho considerado em cada linha.
Com ORDER BY e frame padrão, pares empatados podem ser incluídos juntos. Para acumulados linha a linha, uma ordem total e um frame ROWS explícito deixam o contrato mais claro. last_value também costuma surpreender quando o frame termina na linha atual, e não no fim da partição.
Para filtrar uma janela, crie outra camada
Funções de janela são avaliadas depois de WHERE, GROUP BY e HAVING. Portanto, o alias de uma janela não pode ser filtrado no WHERE da mesma camada no PostgreSQL.
Requisito: selecionar as duas matrículas com maior progresso por trilha.
WITH classificadas AS (
  SELECT
    trilha_id,
    matricula_id,
    estudante_id,
    progresso_percentual,
    ROW_NUMBER() OVER (
      PARTITION BY trilha_id
      ORDER BY progresso_percentual DESC, matricula_id
    ) AS posicao
  FROM matricula
  WHERE situacao = 'ativa'
)
SELECT
  trilha_id,
  matricula_id,
  estudante_id,
  progresso_percentual
FROM classificadas
WHERE posicao <= 2
ORDER BY trilha_id, posicao;
A CTE calcula a janela; a consulta externa filtra o resultado já produzido. Uma subconsulta em FROM funcionaria da mesma forma. Alguns SGBDs oferecem QUALIFY, mas ele não faz parte dessa sintaxe no PostgreSQL atual; não o use sem verificar o produto.
Um exemplo que combina as técnicas com propósito
Requisito: criar uma fila única de atividades recentes, reunindo conteúdos publicados e avaliações, e numerar cada tipo do mais recente para o mais antigo.
WITH atividades AS (
  SELECT
    conteudo_id AS item_id,
    'conteudo' AS tipo,
    publicado_em AS ocorrido_em
  FROM conteudo
  WHERE publicado_em IS NOT NULL

  UNION ALL

  SELECT
    avaliacao_id AS item_id,
    'avaliacao' AS tipo,
    realizada_em AS ocorrido_em
  FROM avaliacao
  WHERE realizada_em IS NOT NULL
),
ordenadas AS (
  SELECT
    item_id,
    tipo,
    ocorrido_em,
    ROW_NUMBER() OVER (
      PARTITION BY tipo
      ORDER BY ocorrido_em DESC, item_id DESC
    ) AS posicao_no_tipo
  FROM atividades
)
SELECT
  item_id,
  tipo,
  ocorrido_em,
  posicao_no_tipo
FROM ordenadas
WHERE posicao_no_tipo <= 10
ORDER BY ocorrido_em DESC, tipo, item_id DESC;
Cada recurso possui uma responsabilidade:
- cada entrada do
UNION ALLentrega o mesmo contrato de três colunas; atividadesnomeia a relação unificada;ROW_NUMBERclassifica sem remover eventos;ordenadascria a camada em queposicao_no_tipoexiste;- a consulta externa limita e ordena a apresentação.
Não haveria benefício em acrescentar uma subconsulta escalar ou recursão apenas para usar mais recursos. Complexidade só se justifica quando expressa um contrato necessário.
Erros comuns
- usar subconsulta escalar que retorna várias linhas: o contexto exige um único valor;
- esconder cardinalidade com
LIMIT 1sem ORDER BY: o valor escolhido é arbitrário; - usar JOIN para testar existência: a linha externa pode ser multiplicada;
- usar
NOT INsem considerar nulos: o resultado pode virarUNKNOWN; - imaginar que CTE cria uma tabela persistente: seu escopo é a instrução;
- supor materialização obrigatória: o comportamento depende do SGBD, versão e número de referências;
- escrever recursão sem término ou detecção de ciclo: a execução pode não terminar;
- usar
UNIONquando duplicatas são fatos legítimos: linhas são eliminadas; - usar
UNION ALLquando o requisito é conjunto distinto: multiplicidades permanecem; - combinar resultados incompatíveis por posição: quantidade ou tipos das colunas não correspondem;
- confundir operação de conjunto com JOIN: uma empilha linhas; o outro combina colunas por correspondência;
- usar janela esperando reduzir linhas: funções de janela preservam identidades;
- não desempatar
ROW_NUMBER: pares recebem ordem instável; - confundir ORDER BY da janela com apresentação: a saída ainda precisa de ordem final;
- ignorar o frame padrão: acumulados e
last_valuepodem surpreender; - filtrar alias de janela na mesma camada: crie uma consulta externa.
Checklist de composição
- Qual relação ou valor cada etapa deve produzir?
- A subconsulta possui a cardinalidade exigida pelo contexto?
- A correlação usa a chave completa?
EXISTSexpressa melhor uma pergunta de presença?- A CTE possui nome e granularidade claros?
- Alguma suposição de materialização depende do produto?
- Uma recursão possui termo inicial, progresso, término e controle de ciclos?
- As entradas de uma operação de conjunto têm colunas e tipos compatíveis?
- As duplicatas devem ser preservadas ou eliminadas?
- Parênteses deixam precedência,
ORDER BYeLIMITclaros? - A janela deve reiniciar por qual partição?
- Qual ordem e desempate determinam pares e posições?
- O frame é toda a partição, acumulado ou intervalo móvel?
- É necessária uma camada externa para filtrar a medida analítica?
- A ordem final de apresentação foi declarada?
O que você deve guardar
Subconsultas criam valores ou relações dentro de outra consulta. CTEs nomeiam etapas e podem expressar recursão, mas não garantem o mesmo comportamento físico em todos os produtos. Operações de conjunto combinam linhas de resultados compatíveis; ALL preserva multiplicidades. Funções de janela anexam cálculos às linhas existentes por meio de partição, ordem e frame.
Na próxima aula, veremos como INSERT, UPDATE e DELETE modificam dados, enquanto constraints e views protegem ou reutilizam contratos no banco.
Referências
- ISO — ISO/IEC 9075-2:2023, SQL/Foundation. Acesso em 30 ago. 2026.
- PostgreSQL Global Development Group — Subquery Expressions. Acesso em 30 ago. 2026.
- PostgreSQL Global Development Group — WITH Queries and CTEs. Acesso em 30 ago. 2026.
- PostgreSQL Global Development Group — Combining Queries with UNION, INTERSECT and EXCEPT. Acesso em 30 ago. 2026.
- PostgreSQL Global Development Group — Window Functions Tutorial. Acesso em 30 ago. 2026.
- PostgreSQL Global Development Group — Window Functions. Acesso em 30 ago. 2026.
- PostgreSQL Global Development Group — Window Function Call Syntax. Acesso em 30 ago. 2026.