
Índices, planos de execução e otimização de consultas
Uma consulta lenta não prova que falta um índice. Ela pode ler linhas demais, estimar cardinalidades incorretamente, ordenar um conjunto enorme, repetir uma operação milhares de vezes ou simplesmente retornar grande parte da tabela — situação em que uma varredura sequencial pode ser a melhor escolha.
Otimizar com segurança começa pelo caminho real da consulta. O PostgreSQL usa estatísticas e um modelo de custos para comparar planos possíveis; índices oferecem novos caminhos, mas também ocupam espaço e acrescentam trabalho a cada escrita.
Na aula anterior, vimos como concorrência, locks e MVCC coordenam transações simultâneas. Agora veremos como localizar e combinar linhas com menos trabalho, sem transformar “criar índice” em resposta automática.
Ao final, você deverá conseguir:
- explicar o papel de um índice e seu custo de manutenção;
- diferenciar varredura sequencial, por índice, somente no índice e por bitmap;
- escolher inicialmente entre B-tree, Hash, GiST, SP-GiST, GIN e BRIN;
- projetar índices compostos a partir de filtros, ordenação e seletividade;
- reconhecer quando índices parciais, por expressão e com
INCLUDEsão apropriados; - ler um plano como árvore e distinguir custo estimado de tempo medido;
- usar
EXPLAIN ANALYZEsem executar alterações acidentalmente; - encontrar erros de cardinalidade e revisar estatísticas;
- organizar uma investigação reproduzível antes de alterar SQL, índice ou configuração;
- medir o efeito global da mudança, inclusive sobre escritas e concorrência.
Índice é uma estrutura de acesso, não uma cópia ordenada da tabela
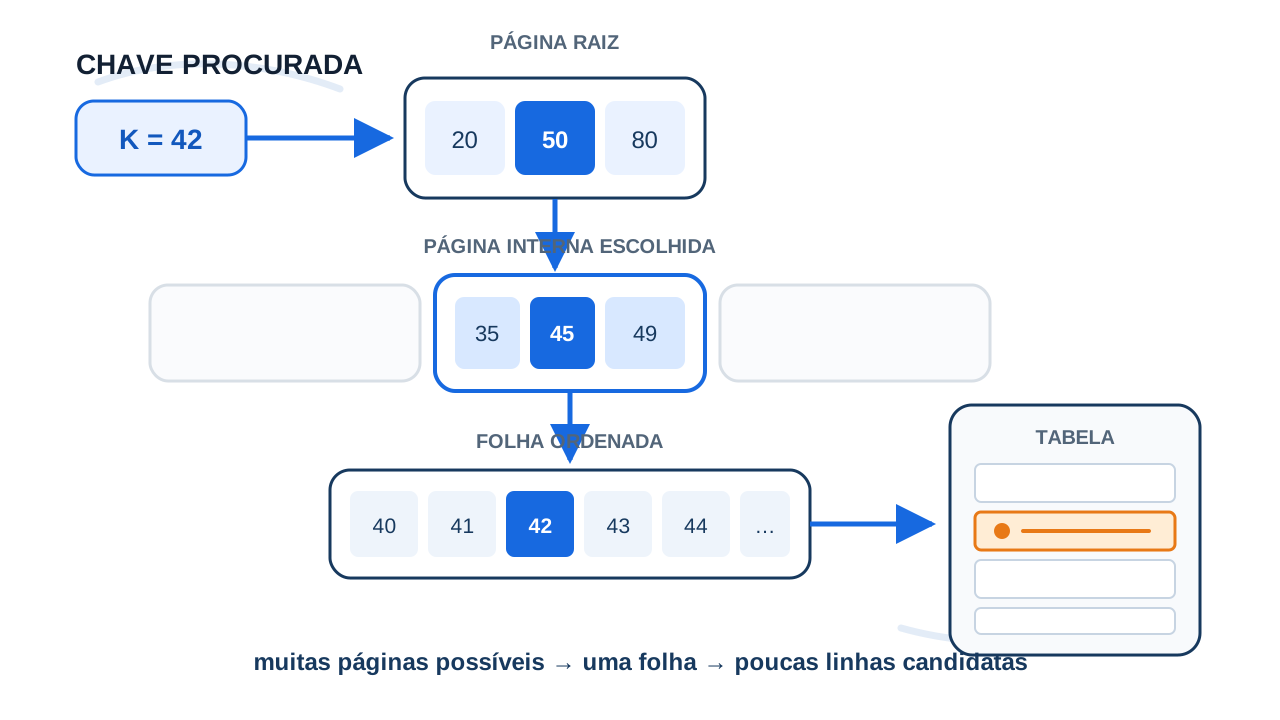
Uma tabela representa os fatos. Um índice mantém chaves derivadas desses fatos em uma estrutura própria, associadas a localizadores das linhas. Quando o predicado e os operadores são compatíveis, o servidor pode navegar por uma parte pequena dessa estrutura e buscar apenas as linhas candidatas.
Considere consultas frequentes por trilha, situação e data:
SELECT conteudo_id, titulo, publicado_em
FROM conteudo
WHERE trilha_id = 10
  AND situacao = 'publicado'
ORDER BY publicado_em DESC
LIMIT 20;
Um índice possível é:
CREATE INDEX idx_conteudo_trilha_situacao_publicacao
ON conteudo (trilha_id, situacao, publicado_em DESC);
Ele organiza entradas primeiro por trilha_id, depois por situacao e, dentro dessas combinações, por publicado_em. O planejador pode usar esse caminho para filtrar e entregar as primeiras linhas já na ordem desejada.
Todo índice possui custo
Para cada índice adicional, o sistema pode precisar:
- armazenar páginas e mantê-las em cache;
- inserir ou remover entradas durante DML;
- atualizar entradas quando uma coluna indexada muda;
- registrar mudanças no mecanismo de recuperação;
- executar manutenção e, em alguns casos, reconstrução;
- considerar mais alternativas durante o planejamento.
Uma chave duplicada em vários índices amplos também aumenta o volume escrito. Portanto, “indexar todas as colunas” troca um possível problema de leitura por custos permanentes de espaço, escrita e operação.
Primary key e UNIQUE normalmente já criam índices
No PostgreSQL, declarar PRIMARY KEY ou UNIQUE cria automaticamente um índice único B-tree para impor a regra. Criar outro índice com a mesma sequência de chaves costuma ser redundante.
Foreign keys não criam automaticamente um índice na coluna que referencia a tabela pai. Esse índice frequentemente é útil para joins e para verificar alterações ou exclusões no lado referenciado, mas deve nascer do uso e da medição — não de uma regra cega.
A pergunta não é “há índice?”, mas “qual caminho custa menos?”
O PostgreSQL estima caminhos possíveis e escolhe o plano de menor custo estimado. Esse custo usa unidades internas relativas; não representa milissegundos.
Sequential Scan lê a tabela como sequência de páginas
Uma varredura sequencial pode ser a melhor escolha quando:
- a consulta precisa de grande parte das linhas;
- a tabela é pequena;
- o predicado tem baixa seletividade;
- ler páginas em sequência custa menos que alternar entre índice e tabela;
- as estatísticas indicam que o índice não reduziria trabalho suficiente.
Ver Seq Scan não é diagnóstico de falha. Se 70% das linhas precisam ser retornadas, navegar por milhões de entradas e visitar quase toda a tabela pode custar mais.
Index Scan alterna entre entradas e linhas da tabela
O índice fornece localizadores; a operação visita a tabela para recuperar colunas e verificar a versão visível. É atraente quando o conjunto candidato é pequeno ou quando a ordem do índice evita um Sort relevante.
Bitmap Scan agrupa localizadores antes de visitar a tabela
O PostgreSQL pode produzir um bitmap com as páginas que contêm candidatos e depois visitá-las numa ordem física mais conveniente. Isso costuma ocupar o meio-termo entre buscar poucas linhas individualmente e varrer toda a tabela. Bitmaps também permitem combinar índices com BitmapAnd ou BitmapOr, mas perdem a ordenação do índice.
Index Only Scan ainda depende da visibilidade
Se todas as colunas necessárias estão disponíveis no índice, o plano pode tentar uma varredura somente no índice. Contudo, o PostgreSQL precisa saber se a versão é visível para o snapshot. Quando a página não está marcada como totalmente visível no visibility map, ainda ocorre acesso à tabela.
Por isso, INCLUDE não garante ausência de leituras da tabela, e cargas com muitas atualizações podem obter menos benefício do que dados mais estáveis.
B-tree é o padrão; outros métodos atendem relações diferentes
O método precisa oferecer os operadores usados pela consulta.
| Método | Relações e dados frequentes | Exemplo de necessidade | Cuidado |
|---|---|---|---|
| B-tree | igualdade, intervalos e ordenação | id = ?, datas entre limites, ORDER BY | é o padrão, mas não resolve qualquer operador |
| Hash | igualdade | token = ? | não oferece ordenação nem intervalos |
| GIN | valores com vários componentes | arrays, jsonb, busca textual | pode ter escrita e manutenção mais custosas |
| GiST | estratégias extensíveis | geometria, faixas e proximidade | comportamento depende da classe de operadores |
| SP-GiST | espaços particionáveis | prefixos, árvores e certos dados espaciais | é adequado apenas às classes suportadas |
| BRIN | resumos de intervalos de páginas | tabela enorme correlacionada com tempo | é pequeno, porém retorna candidatos para rechecagem |
B-tree atende comparações como =, <, <=, >=, >, intervalos e muitos casos de prefixo. GIN é uma escolha comum quando uma linha contém múltiplos valores indexáveis. BRIN não lista cada linha: resume faixas físicas e funciona melhor quando o valor tem correlação com a ordem das páginas, como eventos inseridos aproximadamente por data.
Não escolha pelo tipo da coluna isoladamente. Um jsonb, por exemplo, pode ser consultado por diferentes operadores e exigir classes de operadores distintas.
Índices compostos começam pelo padrão de acesso
Um índice (a, b, c) não equivale a três índices independentes. Em B-tree, restrições de igualdade nas colunas iniciais, seguidas por uma desigualdade na primeira coluna sem igualdade, delimitam a parte contígua principal a ser percorrida. Condições posteriores podem ser verificadas no índice, mas nem sempre reduzem o intervalo visitado na mesma proporção.
Para o índice:
CREATE INDEX idx_matricula_estudante_situacao_data
ON matricula (estudante_id, situacao, matriculado_em DESC);
há boa correspondência com:
WHERE estudante_id = $1
  AND situacao = 'ativa'
ORDER BY matriculado_em DESC
A consulta apenas por situacao, sem restringir estudante_id, tende a aproveitar menos essa ordem. O PostgreSQL atual pode usar skip scan em algumas combinações quando estima vantagem, mas isso não transforma toda coluna intermediária em uma chave inicial equivalente.
Ordem das colunas não vem de uma frase universal
“Coluna mais seletiva primeiro” é insuficiente. Avalie em conjunto:
- predicados de igualdade recorrentes;
- intervalos e operadores usados;
- ordenação solicitada;
- prefixos compartilhados por consultas importantes;
- cardinalidade e distribuição reais;
- volume de escrita e largura das chaves.
No exemplo anterior, situacao pode ter poucos valores, mas faz sentido após estudante_id porque a consulta primeiro localiza as matrículas de uma pessoa e então restringe o estado.
ORDER BY pode ser atendido pelo índice
B-tree pode ser percorrido para frente ou para trás. Um índice simples em uma coluna costuma atender tanto ordem ascendente quanto descendente. Direções explícitas ganham importância em índices compostos com ordem mista:
CREATE INDEX idx_resultado_trilha_nota_data
ON resultado (trilha_id, nota DESC, concluido_em ASC);
Ele pode corresponder a ORDER BY nota DESC, concluido_em ASC dentro de uma trilha. Ainda assim, se a consulta retorna grande volume, uma varredura seguida de ordenação pode ser estimada como mais barata.
Índices especializados devem representar uma necessidade comprovada
Índice por expressão acompanha o predicado
Esta consulta aplica uma função à coluna:
SELECT usuario_id
FROM usuario
WHERE lower(email) = lower($1);
Um índice simples em email não corresponde diretamente à expressão lower(email). É possível criar:
CREATE UNIQUE INDEX uq_usuario_email_normalizado
ON usuario (lower(email));
Agora a expressão indexada coincide com o predicado e também pode impor a unicidade do valor normalizado. As funções de uma expressão de índice precisam ser imutáveis no PostgreSQL, pois a mesma entrada deve continuar representando o mesmo valor.
Índice parcial guarda somente o subconjunto útil
Se a maioria dos conteúdos está arquivada e consultas operacionais buscam os publicados:
CREATE INDEX idx_conteudo_publicado_trilha_data
ON conteudo (trilha_id, publicado_em DESC)
WHERE situacao = 'publicado';
O índice fica menor e evita manter entradas fora do recorte. Para utilizá-lo, o planejador precisa provar que a condição da consulta implica o predicado do índice. A correspondência ocorre no planejamento e não é um provador geral de teoremas; formas equivalentes muito complexas ou parâmetros que não permitem essa prova podem impedir o uso.
Índice parcial também pode impor unicidade apenas a um subconjunto, como um único registro ativo por chave de negócio.
INCLUDE cobre projeções sem mudar a chave
CREATE INDEX idx_conteudo_trilha_data_cobertura
ON conteudo (trilha_id, publicado_em DESC)
INCLUDE (titulo, slug);
titulo e slug podem ser devolvidos por um Index Only Scan, mas não participam da busca nem da unicidade. Colunas largas duplicam dados, aumentam o índice e podem tornar inserções inválidas se a entrada ultrapassar o limite do método. Use cobertura de forma conservadora.
Consultas precisam expor condições aproveitáveis
Um índice só ajuda quando a expressão e o operador são compatíveis. Compare:
-- dificulta o uso de um índice simples em publicado_em
WHERE date(publicado_em) = DATE '2026-08-30'
com um intervalo sobre a coluna original:
WHERE publicado_em >= TIMESTAMP '2026-08-30 00:00:00'
  AND publicado_em <  TIMESTAMP '2026-08-31 00:00:00'
Outro caso clássico:
WHERE titulo LIKE '%banco%'
O curinga inicial impede que uma B-tree comum encontre um prefixo inicial. Isso não significa retirar o curinga e mudar o requisito: pode ser necessário usar busca textual, uma extensão apropriada ou outro desenho de pesquisa.
Conversões implícitas, collations e classes de operadores também influenciam o uso. A solução deve preservar semântica, fuso horário, regras de comparação e tratamento de NULL.
O plano é uma árvore de operações
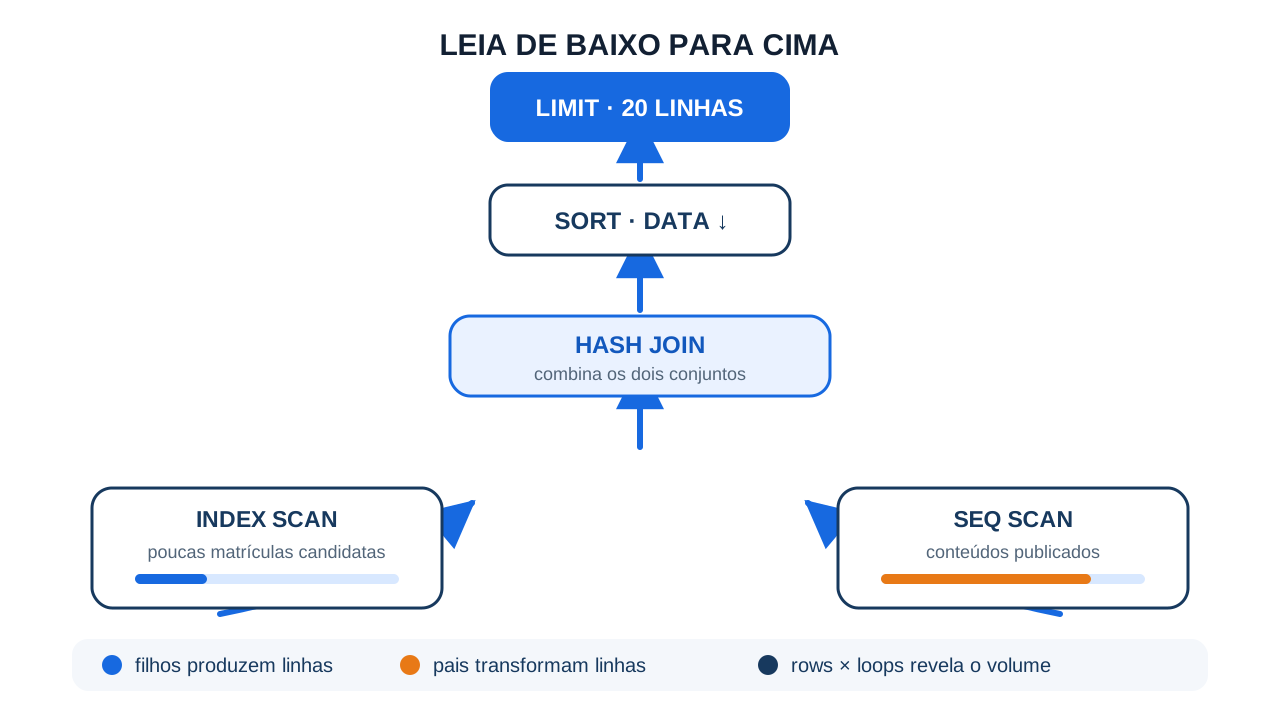
EXPLAIN mostra o plano escolhido sem executar a instrução:
EXPLAIN
SELECT c.titulo, m.progresso
FROM conteudo AS c
JOIN matricula AS m
  ON m.trilha_id = c.trilha_id
WHERE m.estudante_id = 25
  AND c.situacao = 'publicado'
ORDER BY c.publicado_em DESC
LIMIT 20;
Leia pela indentação e comece nos nós inferiores. Eles produzem linhas para seus pais. Um plano pode conter:
- scans para acessar tabelas ou índices;
Nested Loop,Hash JoinouMerge Joinpara combinar relações;SortouIncremental Sortpara ordenar;- agregações por hash ou por grupos ordenados;
Gathere outros nós para trabalho paralelo;Limitpara interromper o consumo quando o resultado está completo.
Não há um nó universalmente melhor. Nested Loop é excelente quando o lado externo retorna poucas linhas e o lado interno tem acesso barato; pode ser desastroso se uma estimativa pequena esconder milhões de iterações. Hash Join pode ser adequado a conjuntos maiores, desde que sua construção e memória façam sentido.
cost, rows e width são estimativas
Um trecho como:
Index Scan ... (cost=0.29..8.31 rows=1 width=48)
indica custo inicial, custo total estimado, linhas emitidas estimadas e largura média estimada. O custo do nó pai inclui o trabalho dos filhos. Não compare o número de cost diretamente com milissegundos nem some todos os custos da árvore.
EXPLAIN ANALYZE executa e mede
EXPLAIN (ANALYZE, BUFFERS, SETTINGS)
SELECT ...;
Além das estimativas, aparecem tempos, linhas reais e loops. Os valores por loop são médias; para compreender o volume total, considere rows × loops. BUFFERS ajuda a distinguir páginas encontradas em cache, lidas ou gravadas, mas cache hit não significa custo zero.
A própria instrumentação adiciona sobrecarga. Teste com dados e parâmetros representativos, em ambiente seguro, e compare várias execuções quando cache ou concorrência influenciam o resultado.
Erro de cardinalidade costuma explicar uma escolha ruim
O planejador precisa estimar quantas linhas cada nó produzirá. Se espera 10 e recebe 1 milhão, decisões posteriores de join, ordenação e memória partem de uma premissa errada.
O comando ANALYZE coleta amostras e registra estatísticas como fração de nulos, valores frequentes, histogramas e correlação física. O autovacuum normalmente o executa, mas uma grande carga ou distribuição incomum pode exigir análise explícita:
ANALYZE conteudo;
Como há amostragem, estimativas podem variar. Aumentar o alvo estatístico de uma coluna pode melhorar detalhes, mas também aumenta coleta, armazenamento e tempo de planejamento:
ALTER TABLE conteudo
ALTER COLUMN trilha_id SET STATISTICS 500;

ANALYZE conteudo (trilha_id);
Colunas relacionadas confundem estimativas independentes
Imagine que situacao = 'publicado' seja muito mais comum em trilhas antigas. Estimar cada condição isoladamente e multiplicar seletividades pode errar a combinação. Estatísticas estendidas podem registrar dependências, valores mais comuns em conjunto ou contagem de valores distintos:
CREATE STATISTICS st_conteudo_trilha_situacao
  (dependencies, mcv)
ON trilha_id, situacao
FROM conteudo;

ANALYZE conteudo;
Elas melhoram estimativas, não criam um caminho de acesso. Um índice e uma estatística resolvem problemas diferentes.
Otimização começa pela carga observada
Uma consulta que demora cinco segundos uma vez por mês pode consumir menos recursos que uma de vinte milissegundos executada milhões de vezes. Latência, frequência e linhas processadas precisam ser analisadas juntas.
Quando habilitada, a extensão pg_stat_statements agrupa estruturas de consultas equivalentes e acumula métricas de planejamento e execução. Uma triagem possível é:
SELECT
  queryid,
  calls,
  total_exec_time,
  mean_exec_time,
  rows
FROM pg_stat_statements
ORDER BY total_exec_time DESC
LIMIT 20;
O acesso ao texto de consultas de outros usuários é restrito por privilégio. Mesmo assim, textos podem conter nomes, comentários ou dados sensíveis; controle acesso, retenção e compartilhamento de planos.
Métricas da aplicação completam a visão: rota, operação de negócio, percentis de latência, timeout, taxa de erro e parâmetros por categoria — sem registrar segredos.
Um processo de diagnóstico evita otimização por palpite
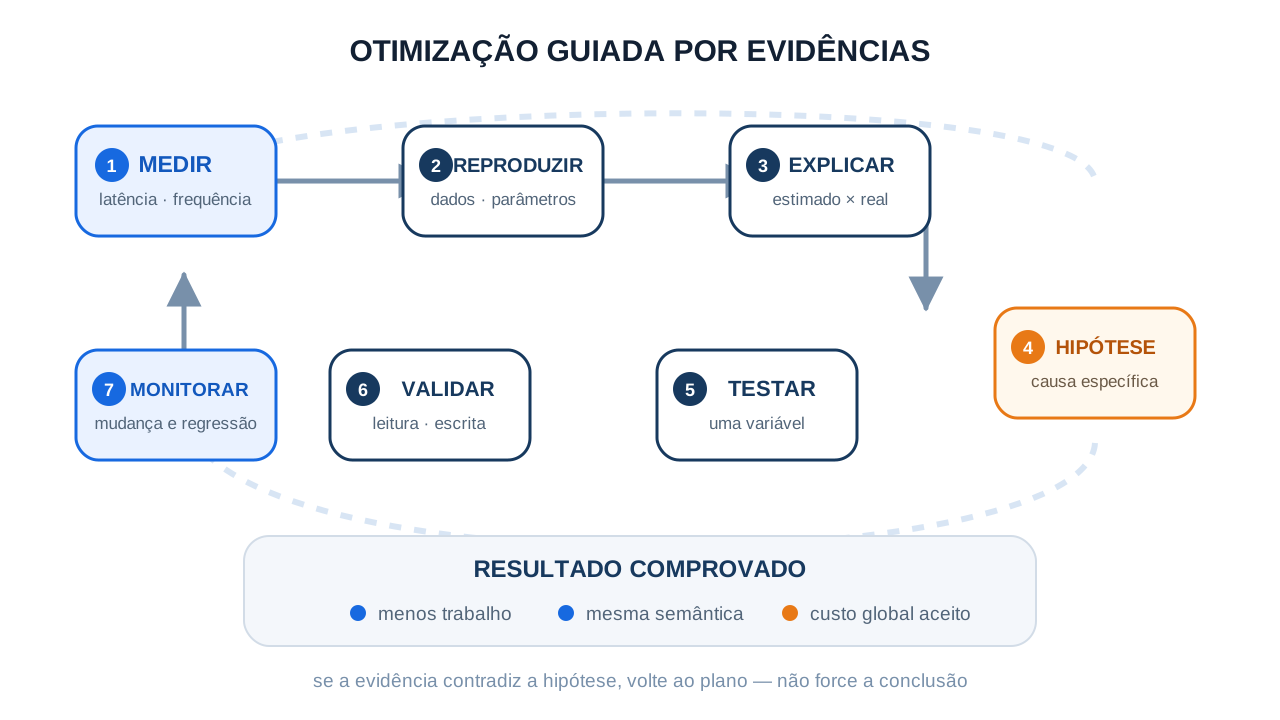
1. Defina o problema mensurável
Registre consulta ou operação, parâmetros representativos, versão do SGBD, volume de dados, concorrência, frequência, percentis e objetivo. “Está lento” não oferece linha de base.
2. Preserve a semântica
Confirme quais linhas, duplicidades, ordenação e NULLs fazem parte do contrato. Uma reescrita mais rápida que devolve outro conjunto está errada.
3. Capture plano estimado e, com segurança, plano real
Compare rows estimadas com reais, observe loops, filtros que removem muitas linhas, ordenações em disco, batches de hash e buffers. Procure o primeiro ponto em que a realidade diverge, não apenas o nó com maior número visual.
4. Formule uma hipótese específica
Exemplos:
- “o predicado aplica uma função e não corresponde ao índice existente”;
- “a combinação de duas colunas está subestimada por correlação”;
- “o índice encontra candidatos, mas a consulta busca 80% da tabela”;
- “o loop interno repete uma busca cara 200 mil vezes”;
- “a ordenação poderia ser evitada por uma chave composta compatível”.
5. Altere uma variável
Reescreva o predicado, atualize estatísticas ou teste um índice. Alterar SQL, três índices e parâmetros do servidor ao mesmo tempo impede atribuir o resultado à causa correta.
6. Valide o sistema, não só a consulta
Meça:
- latência e buffers para parâmetros seletivos e não seletivos;
- custo em
INSERT,UPDATEeDELETE; - tamanho do índice e efeito no cache;
- contenção e duração transacional;
- planos de consultas vizinhas;
- comportamento após crescimento e mudanças de distribuição.
7. Documente e monitore
Registre a hipótese, evidência, DDL, rollback e métricas. O plano pode mudar quando dados, estatísticas, parâmetros ou versão do PostgreSQL mudarem.
Criar índice em produção é uma operação, não só uma linha de DDL
Um CREATE INDEX comum bloqueia escritas concorrentes na tabela durante a construção, embora leituras possam continuar. CREATE INDEX CONCURRENTLY permite INSERT, UPDATE e DELETE, mas executa mais trabalho, demora mais, possui restrições e pode deixar um índice inválido se falhar.
CREATE INDEX CONCURRENTLY idx_conteudo_trilha_publicacao
ON conteudo (trilha_id, publicado_em DESC);
No PostgreSQL, a variante concorrente não pode executar dentro de um bloco de transação. Antes de aplicá-la:
- estime espaço temporário e final;
- verifique duração e impacto de I/O;
- monitore o progresso;
- confira validade e uso depois;
- prepare o procedimento para falha ou cancelamento;
- não suponha que
IF NOT EXISTSvalida equivalência de definição.
Remover índice também exige análise. Contadores de uso podem ter sido reiniciados, uma consulta rara pode ser crítica e índices únicos sustentam integridade. Observe um ciclo representativo e verifique dependências antes de DROP INDEX.
Desempenho e concorrência se encontram no conjunto visitado
Uma consulta que examina muitas linhas permanece mais tempo ativa, usa mais cache e pode ampliar a janela de conflito. Em comandos com lock, um caminho de acesso ruim também pode alcançar e bloquear mais candidatos antes de concluir.
Por outro lado, um novo índice aumenta trabalho de escrita e páginas modificadas. A melhoria de uma leitura pode reduzir duração transacional, mas elevar custo em todos os INSERTs. Esse balanço conecta esta aula à de concorrência, isolamento e locks.
O desenho lógico também importa. Normalização reduz anomalias e esclarece dependências; JOINs e consultas avançadas definem os conjuntos que o planejador precisará combinar. Índice não corrige requisito ambíguo nem cardinalidade produzida por um join incorreto.
Erros comuns
- criar índice para toda consulta lenta: a causa pode ser volume retornado, join ou estimativa;
- considerar Seq Scan um defeito: ele pode ser o caminho mais barato;
- forçar uso de índice para “provar” a solução: flags do planejador servem para investigação, não para validar uma conclusão por si mesmas;
- ler cost como tempo: custo estimado usa unidades relativas;
- somar tempos de todos os nós: pais incluem trabalho dos filhos e loops alteram a leitura;
- executar EXPLAIN ANALYZE em DML de produção: a instrução realmente modifica dados;
- ignorar parâmetros: seletividades distintas podem justificar planos distintos;
- criar
(a, b)e esperar o mesmo efeito para buscas apenas porb: a ordem das chaves participa do caminho; - duplicar índice da primary key ou UNIQUE: a constraint já possui estrutura de suporte;
- criar índice em toda foreign key sem olhar a carga: frequentemente útil não significa universal;
- usar índice parcial cujo predicado a consulta não implica: o planejador não pode escolhê-lo;
- encher INCLUDE com colunas largas: cobertura custa espaço, cache e escrita;
- supor que Index Only Scan nunca visita a tabela: visibilidade MVCC ainda pode exigir heap fetch;
- atribuir toda busca textual à B-tree: operador e classe precisam ser compatíveis;
- atualizar estatísticas e declarar vitória sem medir: o novo plano ainda precisa ser validado;
- alterar vários fatores de uma vez: a causa da melhora ou regressão fica desconhecida;
- otimizar uma consulta isolada e piorar escritas críticas: desempenho pertence à carga completa;
- remover índice por contador zerado: o período observado pode não representar a operação;
- criar índice concorrente sem procedimento de falha: uma construção interrompida pode deixar artefato inválido.
Checklist de índices e planos
- Qual operação, frequência e percentil justificam a investigação?
- Os parâmetros e o volume do teste representam produção?
- A consulta devolve somente colunas e linhas necessárias?
- A semântica de joins,
NULL, duplicidades e ordenação está correta? - Estimativas de linhas se aproximam das linhas reais em cada nó?
loopsfoi considerado no custo total do nó interno?- O predicado é compatível com o método e a expressão do índice?
- A ordem das chaves compostas corresponde aos filtros e à ordenação?
- Um índice existente já cobre o mesmo prefixo?
- Primary key ou
UNIQUEjá criou a estrutura necessária? - Um índice parcial tem predicado estável e demonstrável pela consulta?
- Colunas em
INCLUDEjustificam seu custo e sua largura? - Estatísticas estão atuais e relações entre colunas foram avaliadas?
EXPLAIN ANALYZEserá executado sem efeitos indesejados?- Buffers, ordenação, hash e cardinalidade sustentam a hipótese?
- A mudança melhora parâmetros seletivos e não seletivos relevantes?
- Escritas, armazenamento, cache e concorrência foram medidos?
- A criação em produção possui estratégia de lock, espaço, progresso e rollback?
- A decisão e as evidências foram documentadas?
- Existe monitoramento para detectar mudança de plano ou distribuição?
O que você deve guardar
Índice é um caminho de acesso com benefício e custo. O planejador escolhe entre caminhos a partir de estatísticas e custos estimados; EXPLAIN revela essa hipótese, enquanto EXPLAIN ANALYZE a confronta com a execução real. A diferença entre linhas estimadas e reais frequentemente explica decisões ruins. Índices compostos, parciais, por expressão e de cobertura só são bons quando representam padrões de acesso concretos.
Na próxima aula, veremos como segurança, usuários, papéis, privilégios, backup e recuperação protegem o banco durante a operação e diante de falhas.
Referências
- PostgreSQL Global Development Group — Indexes. Acesso em 30 ago. 2026.
- PostgreSQL Global Development Group — Index Types. Acesso em 30 ago. 2026.
- PostgreSQL Global Development Group — Multicolumn Indexes. Acesso em 30 ago. 2026.
- PostgreSQL Global Development Group — Indexes on Expressions. Acesso em 30 ago. 2026.
- PostgreSQL Global Development Group — Partial Indexes. Acesso em 30 ago. 2026.
- PostgreSQL Global Development Group — Index-Only Scans and Covering Indexes. Acesso em 30 ago. 2026.
- PostgreSQL Global Development Group — Using EXPLAIN. Acesso em 30 ago. 2026.
- PostgreSQL Global Development Group — Statistics Used by the Planner. Acesso em 30 ago. 2026.
- PostgreSQL Global Development Group — ANALYZE. Acesso em 30 ago. 2026.
- PostgreSQL Global Development Group — CREATE INDEX. Acesso em 30 ago. 2026.
- PostgreSQL Global Development Group — pg_stat_statements. Acesso em 30 ago. 2026.