
Atualizações, backup, recuperação e tolerância a falhas
Sistema confiável não é sistema que nunca muda
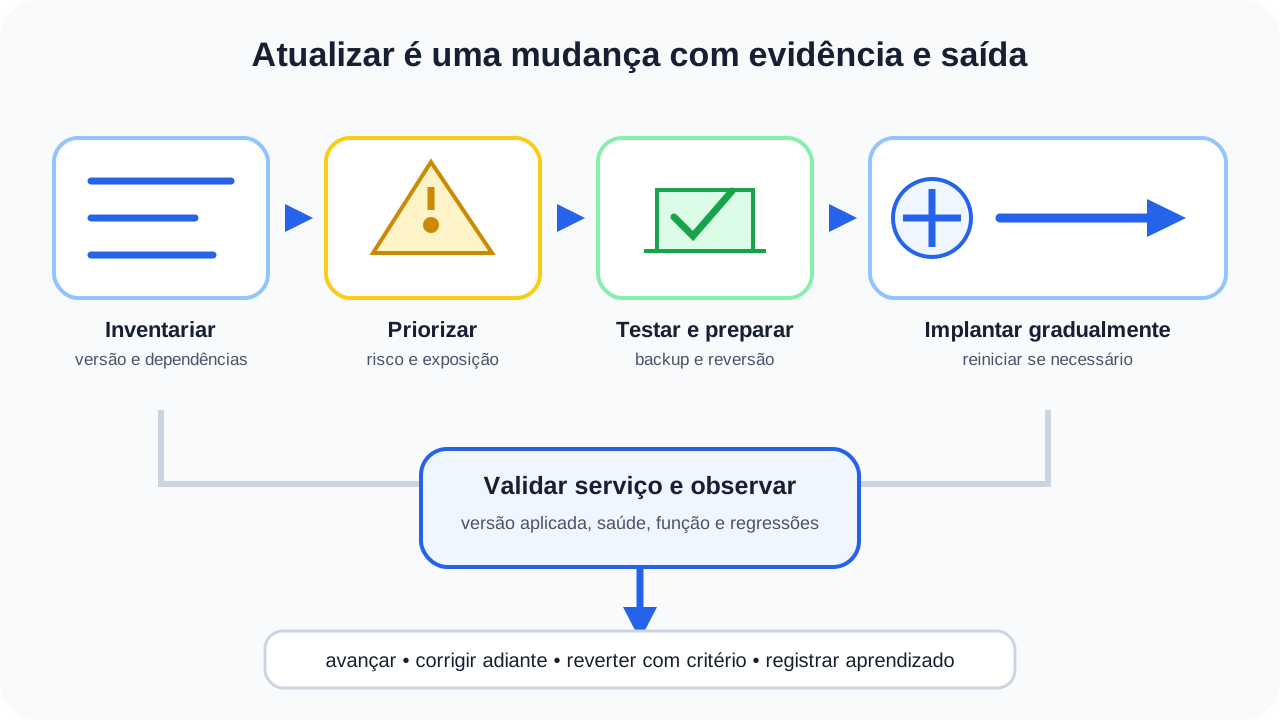
Adiar toda mudança parece preservar estabilidade, mas acumula vulnerabilidades, incompatibilidades e componentes sem suporte. Atualizar sem conhecer dependências também cria indisponibilidade. A operação responsável fica entre esses extremos: inventaria o estado, prioriza riscos, testa, prepara recuperação, muda de forma controlada e verifica o resultado.
Falhas ainda acontecerão. Disco, memória, software, energia, configuração, credenciais e pessoas podem interromper o serviço ou alterar dados. Por isso, confiabilidade combina manutenção preventiva, backup recuperável, restauração ensaiada e tolerância a falhas. Nenhum desses mecanismos substitui os demais.
Esta aula fecha a trilha conectando serviços e registros, diagnóstico de recursos e isolamento por VMs e contêineres. O foco é o ciclo técnico do sistema operacional. Análise de impacto, RPO, RTO e continuidade organizacional permanecem aprofundados em Backup, continuidade e recuperação de desastres.
Atualização começa pelo inventário
Não é possível corrigir de forma consistente o que não se conhece. O inventário precisa relacionar cada sistema ao seu proprietário, finalidade, versão, origem dos pacotes, arquitetura, dependências, exposição, criticidade técnica e situação de suporte. Máquinas desligadas, imagens antigas e equipamentos raramente conectados também fazem parte da superfície.
“Versão do sistema” é apenas uma camada. Um host pode reunir:
- firmware e microcódigo;
- bootloader e kernel;
- bibliotecas e utilitários do sistema;
- drivers e módulos;
- serviços instalados por pacotes;
- runtimes de linguagem e aplicações;
- imagens de máquinas virtuais e contêineres;
- agentes de monitoramento, backup e segurança;
- configurações locais que alteram o comportamento padrão.
Uma correção no repositório oficial não protege uma instância que ainda executa o binário antigo. Atualizar o arquivo no disco também pode não atualizar processos já carregados em memória. Confirme pacote instalado, versão em execução e necessidade de reiniciar serviço, aplicação ou sistema.
Origem importa. Pacotes, imagens e firmware devem vir de canais autenticados e previstos. Adicionar um repositório desconhecido para obter “a versão mais nova” troca um risco de atraso por risco de cadeia de fornecimento. Assinatura ajuda a verificar origem e integridade, mas não prova ausência de vulnerabilidade nem compatibilidade com o ambiente.
Priorizar patch não é ordenar apenas pela severidade
O NIST descreve gerenciamento de patches como identificar, priorizar, adquirir, instalar e verificar patches, atualizações e upgrades. A prioridade operacional combina fatores:
| Fator | Pergunta |
|---|---|
| exploração | há uso ativo conhecido ou caminho público plausível? |
| exposição | o componente é alcançável e a função vulnerável está habilitada? |
| impacto | o que um comprometimento ou falha permitiria? |
| dependência | quais serviços e integrações podem ser afetados pela mudança? |
| mitigação | existe controle temporário eficaz e verificável? |
| suporte | fornecedor ainda publica correções para esta versão? |
| recuperação | a equipe consegue reverter ou reconstruir se o teste falhar? |
Uma pontuação alta merece atenção, mas o contexto define a ordem. Componente vulnerável inacessível pode receber tratamento diferente de serviço explorado na Internet. “Não está exposto” precisa ser evidência, não suposição: interfaces administrativas, usuários internos, arquivos recebidos e cadeias de dependência também abrem caminhos.
Mitigação temporária não encerra o trabalho. Desativar uma função, filtrar acesso ou isolar uma máquina pode reduzir probabilidade enquanto a correção é preparada, porém a exceção precisa de responsável, validade e verificação. Caso contrário, o provisório vira dívida invisível.
Toda atualização precisa de entrada, observação e saída
Antes da mudança, registre o estado que permitirá comparar:
- versão instalada e versão pretendida;
- serviços ativos, falhos e dependências essenciais;
- capacidade de disco e partições necessárias ao boot;
- saúde observada, erros recentes e comportamento funcional;
- configuração local e diferença em relação à fonte versionada;
- backup ou ponto de recuperação aplicável e último teste de restauração;
- critério de sucesso, interrupção prevista e condição para parar.
Teste representativo não significa possuir uma cópia perfeita de produção, mas precisa exercitar arquitetura, volume, configurações e integrações capazes de revelar a regressão. O lote inicial pode ser um grupo pequeno e observável. Avançar em ondas limita o raio de impacto e permite interromper antes que toda a frota receba o defeito.
Durante a mudança, preserve logs, horários, identificadores do pacote e resultado das etapas. Depois, não aceite apenas “comando terminou com sucesso”. Confirme a versão em execução, serviços, operações essenciais, eventos inesperados, consumo de recursos e comportamento durante uma janela adequada.
Reiniciar pode fazer parte da correção
Kernel, bibliotecas e serviços podem permanecer em memória depois que arquivos foram substituídos. Reiniciar somente um serviço reduz impacto quando a dependência permite; trocar kernel ou componentes fundamentais pode exigir novo boot. A decisão precisa considerar processos afetados, sessões, trabalhos em andamento e capacidade de retorno.
Live patching do kernel consegue redirecionar determinadas funções enquanto o sistema permanece ativo. A própria documentação do kernel descreve modelo de consistência e limitações: nem toda função ou mudança de estado pode ser corrigida dessa maneira. Live patch reduz algumas reinicializações urgentes; não elimina manutenção, teste ou reboot futuro.
Alta duração desde o último boot também não prova qualidade. Um sistema pode permanecer ligado e vulnerável ou executar código antigo. Em sentido inverso, reiniciar periodicamente sem motivo não corrige ausência de inventário e pode apenas mascarar vazamentos e falhas que deveriam ser diagnosticados.
Boot é parte do teste. Uma atualização parece funcionar até o próximo reinício e então revela módulo incompatível, montagem ausente ou serviço não habilitado. Quando possível, valide o caminho completo em ambiente controlado e confirme que acesso de recuperação não depende do mesmo serviço que pode falhar.
Rollback é uma hipótese, não uma garantia
Voltar ao pacote anterior pode funcionar quando código e estado permanecem compatíveis. Migrações de formato, firmware, dados ou configuração podem tornar a reversão insegura. Um pacote antigo também pode exigir dependências que já mudaram.
Antes de prometer rollback, responda:
- quais componentes e versões precisam voltar juntos?
- a mudança alterou dados, esquema ou formato persistente?
- o mecanismo foi testado a partir do mesmo estado?
- quanto tempo leva e qual evidência confirma o retorno?
- o retorno reabre a vulnerabilidade que motivou a atualização?
Em alguns casos, corrigir adiante com uma nova versão é mais seguro que restaurar o passado. Em outros, reconstruir uma instância limpa e reanexar dados validados reduz incerteza. A estratégia precisa existir antes da janela, não ser improvisada após a falha.
Snapshot pode acelerar uma reversão local, mas não deve ser a única proteção. Ele pode depender do volume original, compartilhar o mesmo domínio de falha e capturar aplicações em estado inconsistente. A aula anterior separou snapshot, disco, camada gravável e volume; agora essa distinção vira requisito de recuperação.
Backup precisa cobrir mais do que arquivos visíveis
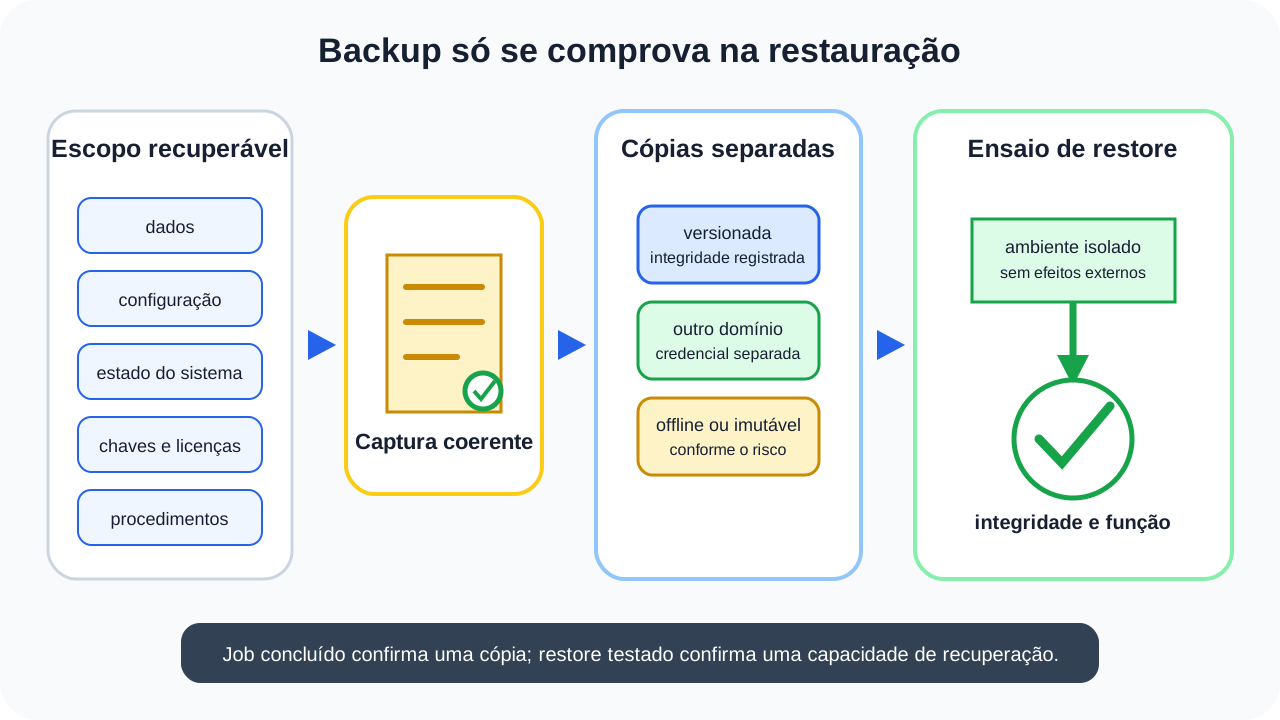
O escopo depende da forma de recuperação. Repor um documento exige menos que reconstruir um host. Uma recuperação do sistema pode precisar de:
- dados e metadados, incluindo permissões, donos, ACLs e atributos;
- configurações do sistema, serviços e rede;
- bootloader, partições, volumes e informações de montagem;
- pacotes, versões, repositórios e artefatos instaláveis;
- certificados, chaves e meios autorizados de recuperá-los;
- contas, identidades ou integrações necessárias;
- licenças, scripts e automações;
- documentação, contatos e ordem das dependências.
Não faça cópia insegura de segredos apenas para “completar o backup”. Defina armazenamento, criptografia, acesso e recuperação das chaves. Backup cifrado cuja chave foi perdida é indisponível; chave guardada no mesmo local e sob a mesma credencial reduz a separação pretendida.
No Windows Server, System State é um conjunto definido pela função da máquina e não inclui automaticamente todo arquivo de usuário. Em Linux, não existe um único objeto universal equivalente: configurações, lista de pacotes, volumes, dados de aplicações e componentes de boot precisam ser definidos conforme a distribuição e o papel do host.
Golden images e infraestrutura declarativa aceleram reconstrução, mas representam uma base, não o estado mais recente dos dados. Mantenha modelos corrigidos, artefatos necessários e procedimento para aplicar configuração e restaurar estado selecionado.
Consistência da cópia depende de quem escreve
Copiar arquivos enquanto uma aplicação altera vários deles pode produzir uma combinação que nunca existiu. Uma cópia crash-consistent aproxima o que o armazenamento apresentaria após interrupção abrupta; o sistema de arquivos e a aplicação ainda executam recuperação. Uma cópia application-consistent coordena a aplicação para que o conjunto represente um ponto válido segundo seu protocolo.
Flush, congelamento, hooks e APIs de snapshot ajudam, mas precisam abranger todos os volumes relacionados. Suspender um sistema de arquivos não coordena automaticamente uma transação distribuída. Para bancos de dados, os mecanismos nativos de dump, backup físico e logs de recuperação continuam explicados na aula específica de backup e recuperação de bancos.
Arquivos abertos não são necessariamente impossíveis de copiar; o problema é o contrato de consistência. Conheça como a aplicação registra mudanças, quais arquivos formam uma unidade e que etapa será executada na restauração.
Completo, incremental e diferencial são relações entre cópias
Um backup completo preserva todo o conjunto definido naquele ponto. Um incremental preserva mudanças desde uma referência anterior, frequentemente o último backup da cadeia. Um diferencial preserva mudanças desde um completo de referência. Produtos podem usar esses nomes de maneira específica; documente a semântica real.
Incrementais reduzem dados transferidos, mas criam dependências. Perder uma parte da cadeia pode inutilizar pontos posteriores. Deduplicação também compartilha blocos entre versões: economiza espaço, porém muda o impacto de corrupção, retenção e coleta de lixo.
Retenção precisa oferecer pontos anteriores ao momento em que um erro foi descoberto. Manter apenas “a versão mais recente” replica silenciosamente exclusões ou corrupção. Em sentido oposto, guardar tudo para sempre aumenta custo, exposição e obrigações. Defina gerações, expiração, proteção contra alteração e descarte verificável.
A cópia deve sobreviver à causa da perda
Backup conectado com a mesma conta administrativa da produção pode ser apagado pelo mesmo erro ou atacante. Cópias precisam atravessar domínios de falha: tecnologia, local, conta, credencial, energia, rede e autoridade administrativa conforme o risco.
Não existe número mágico que resolva todo cenário. Uma estratégia robusta costuma combinar mais de uma cópia, mídia ou sistema diferente e ao menos uma instância isolada, offline ou protegida contra alteração. O guia de ransomware da CISA recomenda backups críticos offline, cifrados e testados porque agentes maliciosos procuram cópias acessíveis para apagá-las ou cifrá-las.
Isolamento precisa ser operacional. Se a mesma credencial pode desabilitar retenção, apagar produção e remover todas as cópias, os destinos diferentes ainda compartilham autoridade. Monitore falha de jobs, redução anormal de volume, expiração, integridade e tentativas de alterar políticas.
Verificar backup e testar restore são controles diferentes
Hash, checksum, manifesto e leitura periódica detectam parte das alterações e falhas de mídia. Ainda assim, um conjunto pode estar íntegro e incompleto, cifrado sem chave recuperável ou incompatível com a versão disponível. Verificação do artefato é necessária, mas não substitui restauração.
Um ensaio técnico deve:
- escolher um ponto real segundo a política de retenção;
- obter software, chaves e documentação sem atalhos pessoais;
- provisionar ambiente isolado com capacidade suficiente;
- restaurar na ordem das dependências;
- impedir envio de mensagens, cobranças ou chamadas à produção;
- validar boot, arquivos, permissões, serviços e logs;
- executar operações representativas e conferir dados;
- medir duração e ponto efetivamente recuperado;
- registrar lacunas com responsável e novo prazo de teste;
- descartar o ambiente de ensaio e seus dados com segurança.
O NIST CSF 2.0 recomenda verificar a integridade dos backups antes do uso e confirmar a integridade dos ativos restaurados e o retorno do serviço. “Restauração terminou” não é critério suficiente se a aplicação não autentica, o relógio está incorreto ou uma chave essencial ficou ausente.
Recuperar pode significar restaurar ou reconstruir
Restaurar repõe dados ou estado a partir de uma cópia. Reconstruir cria novamente um sistema limpo usando imagem, pacotes, configuração declarada e automação. Muitas recuperações combinam os dois: reconstrói-se a plataforma e restauram-se dados que não podem ser derivados.
Essa abordagem evita confiar cegamente em um sistema possivelmente comprometido. Em incidente de segurança, preservar evidência e eliminar persistência pode ser mais importante que voltar rapidamente a um snapshot desconhecido. A coordenação com resposta a incidentes determina quando e de que origem recuperar.
A sequência costuma partir das fundações:
- energia, hardware ou plataforma virtual;
- rede mínima, tempo e resolução necessários;
- identidade, chaves e repositórios confiáveis;
- armazenamento, volumes e sistemas de arquivos;
- sistema operacional e configuração;
- serviços de dados e dependências;
- aplicação, integrações e acesso dos usuários;
- validação, observação e liberação gradual.
Recuperar na ordem errada produz falsos positivos: um serviço aparece ativo, mas não alcança identidade ou dados. Documente pré-requisitos e critérios de prontidão, não apenas uma lista de comandos.
Redundância não é backup
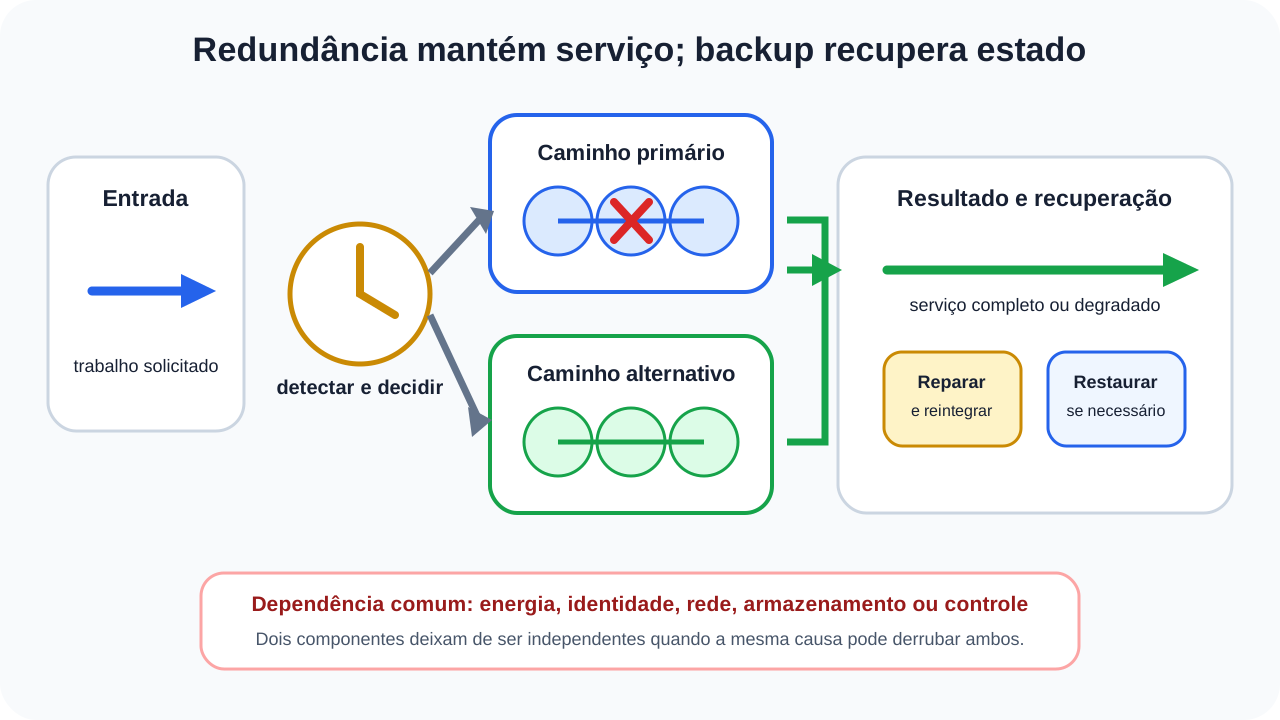
Redundância mantém componentes alternativos capazes de assumir trabalho quando ocorre uma falha prevista. Espelhamento de discos, fontes duplicadas, múltiplas interfaces, nós de serviço e réplicas são exemplos. Eles podem reduzir interrupção, mas normalmente propagam o estado atual — inclusive exclusões e corrupção.
Backup conserva versões para restauração. Redundância busca continuidade. Um sistema precisa frequentemente de ambos. RAID pode manter acesso após falha de um disco compatível com seu desenho; não recupera arquivo apagado, ransomware, falha do controlador, incêndio ou erro replicado.
Tolerância a falhas é a capacidade de continuar entregando a função, talvez em nível reduzido, quando determinados componentes falham. Ela exige detectar, isolar, mudar de caminho e reintegrar. A cobertura é sempre limitada: tolerar uma fonte defeituosa não garante tolerância a perda do prédio ou a configuração inválida distribuída para todos os nós.
Domínios de falha revelam redundância apenas aparente
Dois servidores no mesmo circuito elétrico, switch, rack, volume, conta ou plano de controle compartilham uma causa. Redundância verdadeira precisa da independência correspondente ao cenário que pretende tolerar.
Mapeie pontos únicos:
- alimentação e refrigeração;
- rede física, roteamento e resolução de nomes;
- identidade, certificados e chaves;
- armazenamento e metadados de volume;
- configuração, repositório e automação de implantação;
- monitoramento e mecanismo que decide o failover;
- pessoas, credenciais de emergência e fornecedores.
Separar tudo é impossível e caro. O projeto escolhe falhas cobertas segundo impacto e probabilidade, registra riscos aceitos e testa a resposta. A topologia desenhada não basta; caminhos “distintos” podem usar o mesmo duto, região ou provedor.
Failover também pode falhar
Failover transfere a função para um componente alternativo. Pode ser automático ou autorizado por uma pessoa. Automação reduz tempo quando o sinal é confiável, mas uma verificação de saúde ruim pode retirar um nó saudável, oscilar entre caminhos ou ativar dois escritores incompatíveis.
Defina:
- qual falha é detectada e por qual observador;
- quantas confirmações evitam reação a um pico curto;
- quem possui autoridade sobre o estado;
- como impedir operações concorrentes incompatíveis;
- que capacidade e dados existem no alternativo;
- como clientes encontram o novo caminho;
- como verificar a função depois da troca;
- como reparar e realizar failback sem nova interrupção.
Degradação controlada pode ser melhor que parada total. A plataforma de estudos pode manter leitura de conteúdos e suspender temporariamente progresso ou publicação, desde que o estado e a comunicação sejam coerentes. Essa decisão pertence ao desenho funcional; o sistema operacional apenas oferece mecanismos.
Um exercício fecha o ciclo
Considere uma atualização de kernel no servidor da plataforma. O inventário confirma versão, módulos, espaço em /boot, serviços e console de recuperação. A equipe testa a versão com carga representativa, valida drivers e prepara o kernel anterior como opção conhecida. Um backup recente de configurações e dados já foi restaurado em ensaio separado.
O primeiro host do lote recebe a mudança, reinicia e passa pelos testes de boot, montagem, rede, identidade, aplicação e observação. Um módulo de armazenamento falha ao carregar. A regra de parada impede ampliar o lote; registros e versão exata são preservados. Como o formato dos dados não mudou, o host retorna ao kernel anterior pelo procedimento ensaiado.
O serviço continua em outro nó, mas isso não é o backup. O nó redundante preserva disponibilidade; as cópias isoladas preservam recuperação histórica; o kernel anterior oferece reversão específica. Depois, a causa é corrigida, o teste inclui aquele módulo e uma nova onda é executada.
O cenário demonstra quatro controles independentes: implantação gradual contém o raio; redundância mantém parte do serviço; rollback trata uma mudança compatível; backup oferece reconstrução se o sistema ou os dados forem perdidos.
Erros comuns
- “Não mudar é mais seguro.” Componentes antigos acumulam vulnerabilidades e incompatibilidades.
- “Severidade decide sozinha a prioridade.” Exploração, exposição, impacto e mitigação alteram o risco real.
- “Pacote instalado significa correção ativa.” Processos ou kernel antigos podem continuar em memória.
- “Live patch elimina reboot.” A técnica cobre mudanças específicas e possui limitações.
- “Atualizou sem erro, então funcionou.” É preciso validar versão em execução e função do serviço.
- “Rollback sempre volta ao estado anterior.” Dados, formatos, firmware e dependências podem impedir reversão.
- “Snapshot é backup.” Dependência da origem e consistência precisam ser avaliadas.
- “Copiar arquivos abertos é sempre consistente.” A aplicação pode exigir coordenação própria.
- “Incremental é uma cópia independente.” Pontos posteriores podem depender de toda uma cadeia.
- “Checksum comprova recuperação.” Integridade do arquivo não comprova escopo, chave, compatibilidade ou função.
- “Backup no mesmo domínio já basta.” A mesma falha ou credencial pode alcançar origem e cópia.
- “Réplica é backup.” Exclusões e corrupção podem ser propagadas.
- “RAID protege contra perda de dados.” Ele cobre falhas específicas de dispositivo, não versões históricas.
- “Failover automático é infalível.” Detecção, autoridade e capacidade alternativa também falham.
- “Dois componentes são redundantes.” Dependências comuns podem derrubar ambos.
- “Restore termina quando os arquivos voltam.” Boot, permissões, serviços, dados e operações precisam ser validados.
O que você deve guardar
Atualização é manutenção preventiva: inventariar, priorizar, adquirir de fonte prevista, testar, preparar recuperação, implantar gradualmente e verificar. Reinício pode ser parte necessária da ativação; live patching e rollback possuem escopos e limites.
Backup protege um conjunto definido de dados, configuração, estado e meios de reconstrução. Captura precisa ser coerente, cópias devem sobreviver à mesma causa da perda e restauração precisa ser exercitada em ambiente isolado. Snapshot, réplica, redundância e backup resolvem problemas relacionados, mas diferentes.
Tolerância a falhas depende de detectar, conter e mudar para caminhos realmente independentes. Failover mantém função para cenários cobertos; recuperação recompõe estado confiável; observação e exercícios revelam o que o desenho não mostrou.
Com isso, a trilha percorreu o sistema operacional da interface entre aplicações e hardware até processos, memória, E/S, arquivos, proteção, observabilidade, virtualização e recuperação. Use o catálogo como sequência de estudo e retorne às páginas canônicas sempre que uma camada precisar ser aprofundada.
Referências
- NIST — SP 800-40 Rev. 4: Guide to Enterprise Patch Management Planning. Acesso em 5 set. 2026.
- NIST — SP 800-34 Rev. 1: Contingency Planning Guide for Federal Information Systems. Acesso em 5 set. 2026.
- NIST — Cybersecurity Framework 2.0. Acesso em 5 set. 2026.
- NIST — SP 800-53 Rev. 5.1, controle CP-9: System Backup. Acesso em 5 set. 2026.
- CISA — StopRansomware Guide. Acesso em 5 set. 2026.
- Linux Kernel — Livepatch. Acesso em 5 set. 2026.
- Linux Kernel — Livepatch System State Changes. Acesso em 5 set. 2026.
- Microsoft Learn — Windows Server Backup module. Acesso em 5 set. 2026.
- Microsoft Learn — System State recovery with wbadmin. Acesso em 5 set. 2026.