
Escalonamento de CPU: prioridades, filas e algoritmos
Escalonar é escolher quem usa a CPU agora
Quando existem mais threads prontas do que processadores disponíveis, o sistema precisa decidir qual executará, por quanto tempo e o que acontece quando chega trabalho mais urgente. Escalonamento de CPU é o conjunto de políticas e mecanismos que organiza essa disputa.
O escalonador escolhe uma unidade pronta segundo a política. O dispatcher aplica a escolha: realiza as mudanças necessárias de contexto e entrega o processador. Em explicações introdutórias, falamos em “escalonar processos”, mas sistemas modernos normalmente escalonam threads ou entidades equivalentes.
Na aula anterior, diferenciamos threads, concorrência, paralelismo e assincronia. Agora o foco é a escolha entre threads que já podem executar. O estado e o contexto preservado de uma execução continuam sendo a base para interromper uma e retomar outra.
A fila de prontos reúne trabalhos elegíveis
Uma thread pronta possui condições para avançar, mas aguarda CPU. Ela pode ter acabado de ser criada, ter perdido o processador por preempção ou ter despertado após um evento. Threads bloqueadas por I/O, temporizador ou sincronização não deveriam disputar CPU até a condição de espera terminar.
A expressão fila de prontos é um modelo. Uma implementação pode manter várias filas por CPU, prioridade ou classe, árvores ordenadas e estruturas auxiliares. O conceito importante é o conjunto de unidades elegíveis entre as quais uma decisão precisa ser tomada.
O intervalo contínuo em que uma thread usa CPU antes de bloquear, terminar ou ser interrompida é chamado de CPU burst. Cargas interativas costumam alternar pequenos bursts e esperas; cálculos intensivos podem manter bursts maiores. O sistema não recebe antecipadamente uma ficha perfeita com a duração futura.
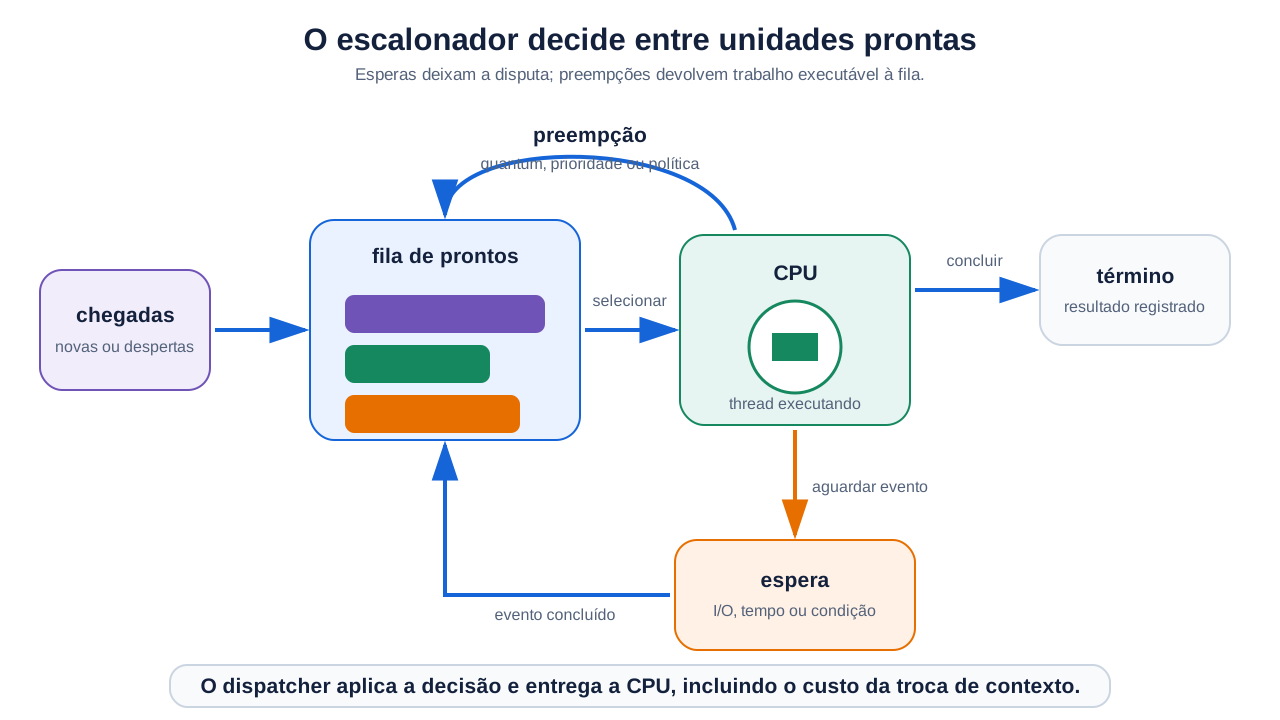
Decisões podem ocorrer quando a thread termina, bloqueia, desperta, esgota sua fatia de tempo ou é superada por trabalho de prioridade maior. Em multiprocessadores, migração e balanceamento acrescentam escolhas sobre qual CPU, não apenas sobre quando executar.
Preempção permite retirar a CPU
Uma política não preemptiva deixa a unidade escolhida executar até terminar seu burst ou ceder voluntariamente ao bloquear. Isso simplifica parte do raciocínio, mas um trabalho longo pode atrasar todos os demais.
Uma política preemptiva permite ao sistema interromper a thread mesmo que ela ainda possa continuar. O motivo pode ser o fim do quantum, a chegada de uma unidade mais prioritária ou outra regra da classe de escalonamento.
Preempção melhora capacidade de resposta, mas não é gratuita. Salvar e restaurar contexto consome tempo; alternância também pode afetar caches e TLB. Um quantum extremamente curto distribui oportunidades rapidamente e aumenta trabalho administrativo. Um quantum muito longo reduz trocas e aproxima o comportamento do FCFS.
Mudança de contexto não é a política. O escalonador decide; o dispatcher efetiva. Uma política pode escolher manter a mesma thread e evitar uma troca desnecessária.
Métricas revelam objetivos em conflito
Para uma tarefa, considere:
- tempo de chegada: quando se torna disponível;
- tempo de primeira execução: quando recebe CPU pela primeira vez;
- tempo de conclusão: quando termina;
- tempo de resposta: primeira execução menos chegada;
- turnaround: conclusão menos chegada;
- tempo de espera: soma dos períodos pronta sem executar.
Em um exemplo puramente limitado por CPU, sem bloqueios, turnaround = espera + duração de CPU. Com I/O e outras esperas, essa igualdade simples precisa incluir os demais períodos. Declare sempre o modelo usado no exercício.
No sistema como um todo, outras métricas importam:
- vazão: quantidade concluída por intervalo;
- utilização: proporção em que o processador permanece ocupado;
- justiça: distribuição de oportunidades segundo o contrato;
- latência de despacho: tempo entre ficar pronta e executar;
- previsibilidade: variação e cumprimento de limites ou deadlines.
Manter a CPU ocupada não prova que o usuário está bem atendido. Um trabalho em lote pode elevar utilização e fazer uma interação simples esperar. Reduzir a resposta de todos pode aumentar trocas e diminuir vazão. Não existe uma política vencedora sem carga e objetivo.
FCFS respeita a ordem de chegada
First-Come, First-Served atende a fila pela ordem em que o trabalho ficou pronto. Na forma não preemptiva, a thread selecionada usa CPU até terminar o burst ou bloquear.
A política é simples e evita ultrapassagem dentro da mesma fila, mas sofre com o efeito comboio: uma tarefa longa à frente mantém várias tarefas curtas esperando. Imagine que A precisa de 7 unidades de CPU, B de 3 e C de 1, todas disponíveis no instante zero. FCFS na ordem A, B, C produz esperas 0, 7 e 10; a média é 5,67.
Chegar primeiro não significa ser mais importante nem mais curto. FCFS pode funcionar em lotes homogêneos e ambientes simples, mas oferece resposta ruim quando bursts variam bastante.
SJF favorece o menor burst conhecido
Shortest Job First escolhe, entre os trabalhos prontos, aquele com menor próximo burst estimado. No exemplo, a ordem C, B, A gera esperas 0, 1 e 4; média 1,67. Sob premissas específicas e durações conhecidas, SJF minimiza a espera média para o conjunto disponível.
O problema prático está em “conhecidas”. O próximo burst não costuma ser fornecido com exatidão. Sistemas podem estimar comportamento passado, mas uma previsão errada altera o resultado. Favorecer continuamente tarefas curtas também pode adiar trabalho longo.
Shortest Remaining Time First, SRTF, é a variante preemptiva: se chega um trabalho com tempo restante estimado menor, o atual pode perder a CPU. Isso melhora resposta para curtos em algumas cargas e adiciona preempções e dependência de estimativa.
SJF não significa “menor arquivo”, “menor processo” nem “menor prioridade numérica”. A grandeza é a duração de CPU prevista para a decisão modelada.
Round Robin divide o tempo em rodadas
Round Robin, RR, organiza a fila e oferece a cada unidade até um quantum. Se ela não terminar nem bloquear nesse intervalo, é preemptada e volta ao fim da fila aplicável.
Com quantum 2, a carga A=7, B=3 e C=1 pode executar assim: A, B, C, A, B e A, considerando cada bloco até duas unidades. Todas recebem sua primeira oportunidade até o instante 4. A espera média, porém, é 4,33 — maior que a do SJF nesse exemplo.
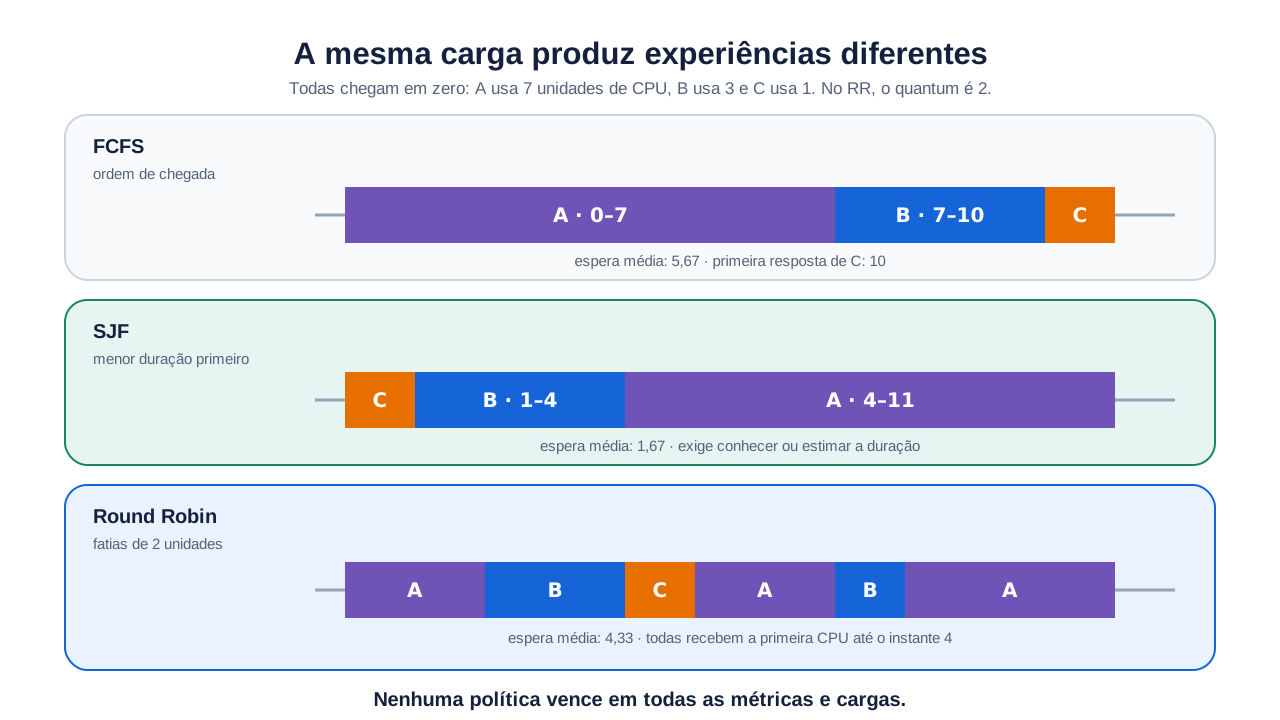
O quantum define um compromisso. Se A, B e C têm bursts menores que o quantum, RR se comporta como FCFS para aquela rodada. Se o quantum é pequeno perto do custo de troca, parte relevante da CPU é gasta administrando alternâncias.
Round Robin não garante tempos iguais de conclusão. Threads bloqueiam, despertam, chegam em momentos diferentes e podem pertencer a classes ou prioridades distintas. A garantia depende do contrato completo, não apenas do nome do algoritmo.
Prioridade define quem vence a disputa
Uma política por prioridade seleciona trabalho segundo um nível de precedência. A prioridade pode ser fixa ou dinâmica e refletir deadline, interatividade, classe de serviço, importância do sistema ou decisões internas.
Não existe convenção universal sobre o número. Em uma API, valor maior pode significar maior prioridade; em outra interface, um número menor pode receber mais CPU. Compare somente dentro da política e da plataforma documentadas.
Se trabalhos prioritários chegam continuamente, um trabalho de baixa prioridade pode permanecer pronto sem executar. Essa espera indefinida é starvation, ou inanição. Justiça não significa necessariamente parcelas idênticas, mas a política precisa declarar se e como garante progresso.
Aging aumenta gradualmente a prioridade efetiva de quem espera. Assim, uma tarefa antiga ganha oportunidade mesmo sob fluxo de novas tarefas. O método reduz starvation, mas não substitui reserva de capacidade ou garantias temporais quando o requisito exige prazo.
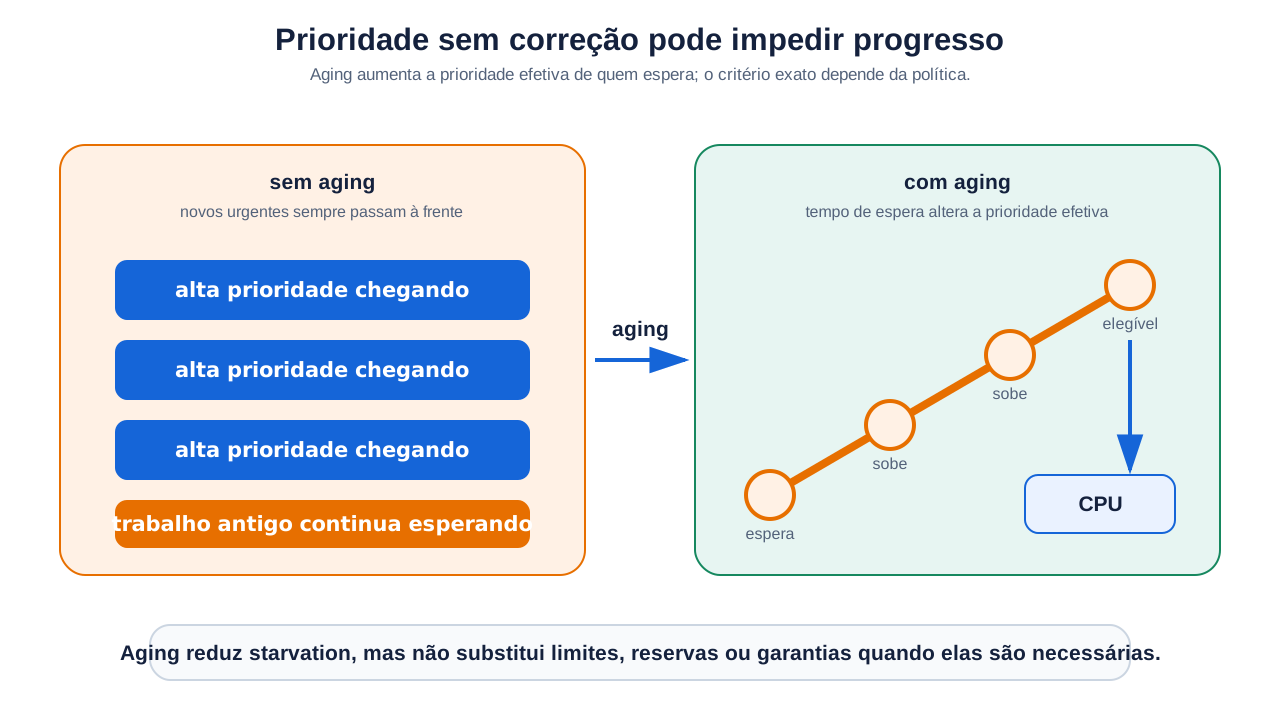
Prioridade excessiva também pode prejudicar o próprio sistema. Uma thread mal comportada em classe de tempo real pode impedir trabalho essencial de menor prioridade. Alterar prioridade sem conhecer política, privilégios e carga não é um ajuste seguro de desempenho.
Filas multinível separam classes de trabalho
Uma fila multinível agrupa trabalhos por classe, como interativo, lote ou tempo real. Cada fila pode possuir política própria, e outra regra decide como as filas compartilham a CPU. Se uma classe sempre vence, as inferiores precisam de limites para não sofrer starvation.
Uma fila multinível com realimentação, MLFQ, permite mover tarefas entre níveis conforme o comportamento observado. Unidades que consomem todo o quantum podem descer; trabalhos que bloqueiam cedo ou esperam muito podem receber tratamento diferente. O objetivo é aproximar responsividade e justiça sem conhecer previamente cada burst.
Essas regras são família de projeto, não receita única. Quantidade de filas, quantum, promoções e rebaixamentos mudam completamente o comportamento.
Tempo real busca previsibilidade, não apenas velocidade
Em sistemas de tempo real, o resultado precisa chegar dentro de uma restrição temporal. Tempo real rígido trata perder o deadline como falha inaceitável; tempo real flexível tolera perdas com degradação de valor. Uma prioridade alta em um sistema comum não cria automaticamente garantia de deadline.
POSIX define políticas como SCHED_FIFO e SCHED_RR para o modelo de escalonamento previsto pelo padrão. Em prioridades iguais, SCHED_FIFO segue ordem FIFO e não aplica a mesma divisão temporal de RR; SCHED_RR adiciona quantum. Trabalho de prioridade maior prevalece segundo as regras documentadas.
Essas políticas exigem projeto do sistema inteiro: duração máxima, bloqueios, interrupções, recursos compartilhados e prioridade dos componentes. A aula seguinte mostrará por que um lock pode até provocar inversão de prioridade, quando uma thread importante depende de outra menos prioritária.
Multiprocessadores acrescentam afinidade e balanceamento
Com várias CPUs, o sistema pode executar threads simultaneamente e distribuir filas. Uma fila global simplifica parte da justiça, mas pode concentrar contenção. Filas por CPU reduzem disputa e exigem balanceamento de carga para evitar um núcleo sobrecarregado enquanto outro fica ocioso.
Mover uma thread tem custo porque caches e memória podem estar mais próximos de determinado processador. Afinidade expressa preferência ou restrição de CPUs. Preservá-la pode melhorar localidade; mantê-la rigidamente pode deixar capacidade livre sem uso.
Em arquiteturas NUMA, memória possui custos diferentes conforme o nó. A decisão passa a equilibrar CPU disponível, dados próximos, energia e migração. Por isso, o diagrama de uma fila e uma CPU é base conceitual, não retrato literal de uma máquina moderna.
Sistemas reais combinam políticas
Algoritmos didáticos isolam efeitos. Sistemas de propósito geral precisam atender aplicações interativas, serviços, lotes, tarefas do kernel e classes de tempo real na mesma máquina.
A documentação atual do Linux descreve a transição do escalonamento comum para EEVDF. Ele usa tempo virtual, atraso relativo (lag), elegibilidade e deadlines virtuais para distribuir CPU e favorecer responsividade de fatias menores. Isso não significa que todo trabalho Linux usa a mesma classe nem que os exemplos FCFS e RR se tornaram inúteis; eles continuam explicando propriedades fundamentais.
No Windows, o dispatcher escolhe threads prontas por prioridade e divide tempo entre threads de mesma prioridade, com ajustes dinâmicos em situações documentadas. Classe do processo, prioridade da thread, afinidade, estado e quantum participam da decisão.
Evite afirmar “Linux usa apenas CFS” ou “Windows é somente Round Robin”. Implementações evoluem e combinam classes. A regra evergreen é consultar documentação da versão e observar a carga real.
Uma fotografia de CPU não revela a política
No PowerShell, esta consulta somente leitura mostra processos com maior tempo acumulado de CPU:
Get-Process |
  Sort-Object CPU -Descending |
  Select-Object -First 5 Id, ProcessName, CPU
CPU é tempo acumulado observado para o processo, não percentual instantâneo, tamanho da fila, latência ou prioridade efetiva de cada thread. Um processo antigo pode aparecer no topo sem estar ativo agora. Use séries temporais e ferramentas de rastreamento para investigar escalonamento.
Em qualquer plataforma, diferencie:
- uso alto porque existe trabalho útil;
- fila alta porque falta capacidade;
- latência alta por bloqueio fora da CPU;
- trocas excessivas por contenção ou quantum;
- limitação imposta por cota, afinidade ou contêiner.
O escalonador não corrige algoritmo ineficiente nem dependência bloqueada. Antes de alterar prioridade, confirme que CPU é realmente o recurso limitante.
Erros comuns
- “O escalonador escolhe processos, nunca threads.” Sistemas modernos normalmente despacham threads ou entidades equivalentes.
- “Pronto e esperando são a mesma fila.” Pronto disputa CPU; esperando aguarda outro evento.
- “Preemptivo significa executar em paralelo.” Preempção pode intercalar threads em uma única CPU.
- “FCFS é sempre justo.” Preserva ordem, mas um burst longo pode atrasar muitos curtos.
- “SJF conhece o futuro.” Implementações precisam estimar duração; erro de previsão altera a escolha.
- “Round Robin termina todos juntos.” Ele distribui oportunidades, não iguala duração nem chegada.
- “Quantum menor sempre melhora resposta.” Trocas demais podem consumir capacidade e piorar o sistema.
- “Prioridade alta garante deadline.” Garantia temporal depende da política e de todo o caminho de recursos.
- “Aging torna todos iguais.” Ele corrige espera acumulada segundo uma regra; classes ainda podem diferir.
- “100% de CPU prova eficiência.” Pode haver trabalho inútil, fila crescente ou latência ruim.
- “Um algoritmo didático descreve sozinho Linux ou Windows.” Sistemas reais combinam classes, heurísticas e estruturas próprias.
O que você deve guardar
O escalonador escolhe entre unidades prontas; o dispatcher efetiva a escolha. Políticas preemptivas podem retirar CPU, e cada troca possui custo. Resposta, espera, turnaround, vazão, justiça e previsibilidade medem objetivos diferentes.
FCFS favorece ordem e pode criar comboio. SJF reduz espera média sob premissas e previsões adequadas; SRTF adiciona preempção. Round Robin distribui fatias e depende do quantum. Prioridades expressam precedência, mas podem causar starvation; aging promove trabalho que espera.
Filas multinível, afinidade e balanceamento respondem a cargas e máquinas complexas. POSIX, Linux e Windows apresentam políticas concretas que não devem ser reduzidas a um único algoritmo escolar. Antes de ajustar o sistema, identifique o gargalo e a métrica desejada.
Na próxima aula, veja como condições de corrida, mutexes, semáforos e monitores se relacionam para preservar invariantes compartilhadas.
Referências
- The Open Group — POSIX.1-2024: Process Scheduling and Thread Scheduling. Acesso em 4 set. 2026.
- The Open Group — POSIX.1-2024: Scheduling Policy. Acesso em 4 set. 2026.
- The Open Group — POSIX.1-2024 Rationale: Scheduling. Acesso em 4 set. 2026.
- Linux Kernel Documentation — EEVDF Scheduler. Acesso em 4 set. 2026.
- Linux Kernel Documentation — CFS Scheduler. Acesso em 4 set. 2026.
- Microsoft Learn — Scheduling. Acesso em 4 set. 2026.
- Microsoft Learn — Scheduling Priorities. Acesso em 4 set. 2026.
- Microsoft Learn — CPU Analysis: processes, threads and context switches. Acesso em 4 set. 2026.
- ACM, IEEE-CS e AAAI — CS2023: Operating Systems. Acesso em 4 set. 2026.