
Serviços, daemons, systemd e registros do sistema
Serviço é uma função; daemon é um processo em segundo plano
Um servidor pode estar ligado e aceitar login enquanto a aplicação esperada continua indisponível. O kernel, a rede e o armazenamento podem funcionar, mas o processo que atende requisições não iniciou, perdeu uma dependência ou entrou em falha. Operar o sistema exige enxergar essa camada entre o boot e a entrega do serviço.
Serviço é uma função oferecida pelo sistema, como sincronizar o relógio, resolver nomes, receber conexões ou executar uma aplicação. Daemon é um processo que roda em segundo plano para supervisionar o sistema ou fornecer funcionalidade a outros processos. Os termos se sobrepõem em muitos contextos Unix, mas não são sinônimos perfeitos: uma unidade de serviço pode executar uma tarefa curta e terminar, enquanto uma função pode ser composta por mais de um processo.
A aula sobre inicialização do computador acompanhou a cadeia até o primeiro processo de usuário e localizou o systemd como uma implementação frequente de PID 1 no Linux. Agora o foco deixa de ser “como o computador chegou aqui?” e passa a ser “como uma função é ativada, supervisionada e investigada durante toda a operação?”.
Daemons tradicionais se destacavam do terminal
No modelo Unix tradicional, um daemon costumava criar outro processo com fork, abrir uma nova sessão com setsid, ajustar diretório, máscara, sinais e descritores, redirecionar entradas e gravar um PID file. O objetivo era tornar a execução independente do terminal e do usuário que a iniciou.
Esse modelo nasceu quando o próprio programa precisava preparar boa parte de sua vida em segundo plano. Ele ainda existe, mas um gerenciador moderno pode oferecer o ambiente e acompanhar diretamente o processo. Sob systemd, é comum o daemon permanecer em primeiro plano, manter saída padrão conectada e deixar que o gerenciador cuide de identificação, agrupamento, encerramento e registros.
Executar em primeiro plano não transforma o daemon em aplicativo interativo. Significa apenas evitar uma separação desnecessária do supervisor. O serviço continua sem depender de uma janela de terminal e pode usar conta própria, diretório de trabalho, variáveis e limites fornecidos pelo gerenciador.
Essa mudança também melhora diagnóstico. O PID do processo principal e os descendentes podem permanecer associados à unidade por cgroup; saídas podem chegar ao journal; falha e término são observados pelo mesmo componente que iniciou o trabalho. Um PID file, por outro lado, pode ficar desatualizado, ser reutilizado ou apontar para o processo errado se o protocolo for mal implementado.
systemd administra unidades, não apenas processos
No systemd, uma unit representa um recurso conhecido pelo gerenciador. O sufixo do nome indica o tipo. Entre os exemplos mais frequentes estão:
| Tipo | Representa | Uso comum |
|---|---|---|
.service | processo ou ação supervisionada | daemon, aplicação ou tarefa de preparação |
.socket | socket de IPC ou rede | ativar o serviço quando surge comunicação |
.timer | evento baseado em tempo | disparar trabalho periódico ou agendado |
.path | caminho observado | ativar uma unidade diante de alteração |
.mount | ponto de montagem | representar dependência de armazenamento |
.device | dispositivo exposto pelo kernel | relacionar trabalho à disponibilidade do hardware |
.target | agrupamento e ponto de sincronização | reunir unidades de um estado operacional |
Um serviço, portanto, participa de um grafo maior. O socket pode ser preparado antes do processo que o atenderá; uma montagem pode ser requisito; um timer pode iniciar uma tarefa somente quando necessário. Ativação não acontece exclusivamente durante o boot nem precisa manter todo daemon ocioso desde a inicialização.
Targets não são caixas que executam todas as unidades internamente. Eles agrupam dependências e criam marcos úteis. A analogia com runlevels do SysV ajuda na migração, mas não descreve todo o grafo nem as ativações possíveis durante a operação.
Um arquivo de unidade descreve o contrato
Uma unidade de serviço pode reunir seções com responsabilidades distintas:
[Unit]
Description=Aplicação de exemplo
Wants=network-online.target
After=network-online.target dados.mount

[Service]
Type=notify
User=aplicacao
ExecStart=/opt/aplicacao/bin/servidor
Restart=on-failure

[Install]
WantedBy=multi-user.target
O trecho é didático, não uma receita pronta. Diretivas suportadas, usuário, caminho, dependências, prontidão e política de reinício precisam corresponder ao programa e à distribuição.
[Unit]documenta a unidade e suas relações;[Service]define como o processo é iniciado e supervisionado;[Install]informa relações que ferramentas podem materializar ao habilitar a unidade.
ExecStart= não passa automaticamente por um shell completo. Expansão, encadeamento e redirecionamentos não devem ser presumidos como em uma linha interativa. Se a execução realmente exige shell, isso precisa ser explícito e seguro; muitas vezes é melhor fornecer o executável e seus argumentos diretamente.
A identidade configurada em User= e Group= conecta esta aula à anterior sobre usuários, permissões, ACLs e menor privilégio. Executar com conta dedicada reduz o alcance de uma falha. Outras diretivas podem restringir arquivos, chamadas, dispositivos, capabilities e namespaces, mas cada barreira precisa ser compatível com o serviço e testada.
Dependência e ordenação são eixos separados
Um dos erros mais persistentes é imaginar que After= significa “inicie esta outra unidade”. No systemd, relações de requisito e de ordenação são independentes:
Wants=inclui outra unidade como requisito fraco; a unidade atual ainda pode prosseguir se a desejada falhar;Requires=cria uma relação mais forte, embora seus efeitos exatos dependam também da transação e da ordenação;Before=eAfter=organizam a sequência quando ambas as unidades possuem trabalhos na transação;Conflicts=representa unidades que não devem ficar ativas juntas.
Assim, After=rede.service sozinho não puxa rede.service para a transação. E Wants=rede.service sem uma relação de ordem permite que ambas iniciem em paralelo. Quando inclusão e sequência são necessárias, as duas ideias aparecem juntas.
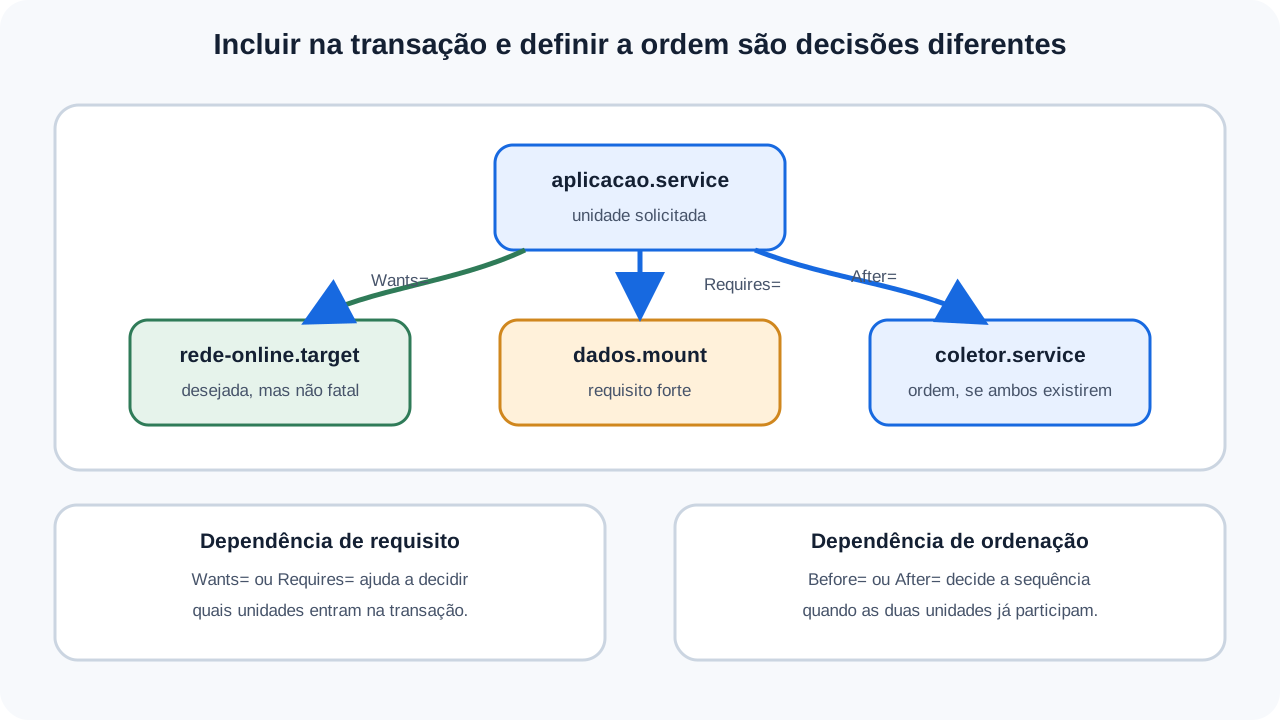
Dependência também não é verificação funcional. network-online.target representa um marco definido pela configuração da rede, não uma garantia de que um endpoint externo específico responderá. Declarar After=banco.service apenas aguarda o marco de inicialização que o tipo daquele serviço reporta; não executa uma consulta na base.
Grafos permitem paralelismo. Unidades sem relação de ordem podem avançar ao mesmo tempo. Isso reduz espera, mas revela dependências ocultas: se uma aplicação funcionava somente porque outra sempre terminava primeiro por acaso, a inicialização concorrente torna o defeito visível.
Habilitar e iniciar respondem a momentos diferentes
systemctl start exemplo.service solicita ativação agora. systemctl enable exemplo.service cria relações para que a unidade seja puxada em uma ativação futura, geralmente por um target; habilitar não implica necessariamente iniciar imediatamente. Da mesma forma, uma unidade pode estar ativa sem estar habilitada porque foi iniciada manualmente, por socket, timer, dependência ou outro gatilho.
Os estados também pertencem a dimensões diferentes:
- loaded: a definição foi localizada e carregada sem erro essencial;
- enabled: existem relações de instalação para ativação futura;
- active: a unidade atingiu o estado ativo conforme seu tipo;
- failed: a unidade terminou em uma condição registrada como falha;
- masked: sua ativação foi bloqueada por uma máscara, normalmente um vínculo para
/dev/null.
Perguntar “o serviço está ligado?” mistura configuração de próxima inicialização, estado atual e saúde. Um diagnóstico melhor pergunta: a definição foi carregada? deveria ser ativada por quê? qual estado atual? qual processo está associado? a função responde corretamente?
Unidades estáticas podem não oferecer instruções de instalação e ainda ser ativadas como dependência. Ativação por socket ou timer também enfraquece a expectativa de que todo serviço útil apareça simplesmente como enabled.
O tipo de serviço define quando a inicialização termina
Criar um processo é diferente de ter uma aplicação pronta. A diretiva Type= define o protocolo pelo qual o gerenciador considera concluída a inicialização:
simple: o processo é disparado e o gerenciador não aguarda prontidão interna; unidades posteriores podem avançar cedo;exec: o início ao menos alcança com sucesso a execução do binário, mas isso ainda não prova que a aplicação terminou de se preparar;notify: o serviço coopera e envia uma notificação de prontidão depois de inicializar;dbus: a aquisição de um nome D-Bus funciona como marco;forking: acompanha o protocolo tradicional no qual o processo inicial se bifurca e termina, frequentemente com PID file;oneshot: aguarda uma ou mais ações terminarem, sem exigir um processo permanente.
Um oneshot bem-sucedido pode voltar a inactive se RemainAfterExit= não estiver ativo. Isso não significa necessariamente falha: a função era executar uma ação. Em sentido inverso, active (running) para um serviço simple pode significar apenas que o processo não terminou; a porta pode não estar aberta ou a dependência externa pode estar indisponível.
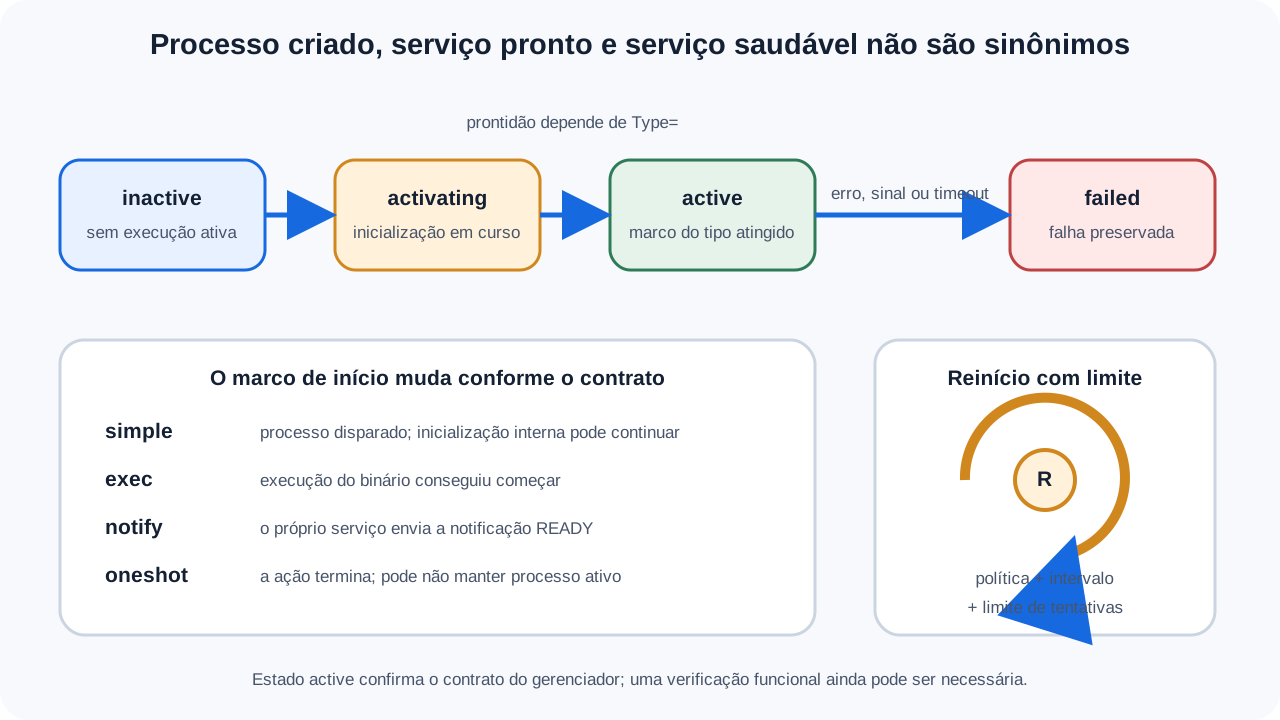
Prontidão e vivacidade também não são iguais. READY=1 declara que a inicialização terminou naquele instante. Um watchdog cooperativo pode exigir notificações periódicas e detectar que o processo parou de responder ao contrato, mas não valida sozinho todas as funções de negócio.
Reinício automático precisa de limite e evidência
Restart= pode pedir nova execução depois de falha, término anormal ou outras condições. Isso ajuda a recuperar erros transitórios, mas não corrige configuração inválida, credencial ausente, arquivo incompatível ou recurso permanentemente indisponível.
Um laço rápido de reinício consome CPU, pressiona dependências e multiplica registros. O systemd aplica limitação de frequência de partidas por unidade. Ao exceder a janela configurada, novas tentativas podem ser recusadas e o estado de falha fica visível. Atrasos e limites devem equilibrar tempo de recuperação com proteção contra tempestades.
Reiniciar também altera evidências: PIDs mudam, buffers desaparecem, conexões são encerradas e mensagens podem girar. Antes da ação, registre estado, horário, motivo do término, código ou sinal, quantidade de tentativas e eventos correlatos. “Voltou depois de reiniciar” descreve recuperação temporária, não causa raiz.
Não configure Restart=always como reflexo universal. Uma tarefa oneshot concluída com sucesso pode não precisar repetir; um erro permanente merece intervenção; um término solicitado durante manutenção não deve necessariamente ressuscitar o processo. A política depende do contrato operacional.
Processos de uma unidade formam um grupo supervisionado
Identificar o serviço somente pelo PID principal pode esconder trabalhadores e subprocessos. O systemd usa cgroups para agrupar processos da unidade, aplicar recursos e encerrar o conjunto segundo política. Se o processo principal cria trabalhadores, o gerenciador ainda pode associá-los ao mesmo serviço.
Isso não transforma qualquer filho em saudável nem impede que o programa delegue trabalho externamente. O modelo de processos precisa ser compatível com Type=, PIDFile=, ExitType= e o modo de encerramento. Uma aplicação que se bifurca quando a unidade espera permanência em primeiro plano pode parecer iniciar e morrer imediatamente.
O estado de saída também carrega significado. Terminar com código zero costuma indicar sucesso; código não zero ou sinal pode indicar falha. Unidades podem declarar exceções, mapear resultados e executar etapas antes ou depois. Scripts que escondem o código real com exit 0 tornam a supervisão menos confiável.
Registros são eventos, não a realidade inteira
Um log é um registro produzido por algum componente sobre um evento observado. Ele pode conter horário, origem, prioridade, mensagem, PID, unidade, boot e campos adicionais. Isso oferece evidência, mas não uma reprodução perfeita do sistema.
Um programa pode falhar antes de registrar, omitir contexto, usar relógio incorreto ou emitir uma conclusão enganosa. Ausência de erro não prova saúde; mensagem de erro não prova que o usuário foi afetado. Diagnóstico combina logs com estado, métricas, configuração e teste da operação esperada.
O syslog tradicional organiza mensagens por facility e severidade e permite encaminhamento a um daemon de registro. O systemd-journald coleta mensagens de várias fontes, incluindo streams de serviços, syslog, kernel e sua interface nativa, e acrescenta metadados estruturados. Um syslog daemon pode receber mensagens encaminhadas ou ler o journal; os mecanismos podem coexistir.
Persistência depende da configuração e do armazenamento disponível. O journal pode ser volátil em /run/log/journal, persistente em /var/log/journal, encaminhado ou limitado por políticas de espaço e rotação. Se o boot anterior não aparece, isso não prova que nada aconteceu: os dados podem não ter sido persistidos, já ter expirado ou exigir outra origem.
Consulte primeiro; filtre depois
Comandos somente de leitura ajudam a preservar o cenário. Substitua exemplo.service pela unidade já identificada:
systemctl status exemplo.service --no-pager
systemctl show exemplo.service --property=LoadState,ActiveState,SubState,Result,MainPID,ExecMainCode,ExecMainStatus,NRestarts
systemctl cat exemplo.service
systemctl list-dependencies exemplo.service --all
systemctl is-enabled exemplo.service
systemctl is-active exemplo.service
status resume estado e eventos recentes para pessoas; show expõe propriedades adequadas a inspeção e automação; cat mostra os fragmentos e drop-ins conhecidos pelo gerenciador; list-dependencies exibe relações. Nenhum comando isolado confirma saúde funcional.
Para o journal:
journalctl --list-boots --no-pager
journalctl -u exemplo.service -b --since '30 minutes ago' --no-pager
journalctl -u exemplo.service -b -1 --no-pager
journalctl -k -b --priority=warning --no-pager
journalctl -u exemplo.service -b -o verbose --no-pager
-u filtra eventos associados à unidade e mensagens do gerenciador sobre ela; -b seleciona um boot; --since limita tempo; -k consulta mensagens do kernel; --priority limita severidade; -o verbose revela campos estruturados. Acesso depende das permissões e da política local.
Evite começar com journalctl -f e esperar indefinidamente por uma repetição. Primeiro delimite o intervalo em que o sintoma ocorreu. Acompanhar ao vivo é útil depois, durante uma reprodução segura e controlada.
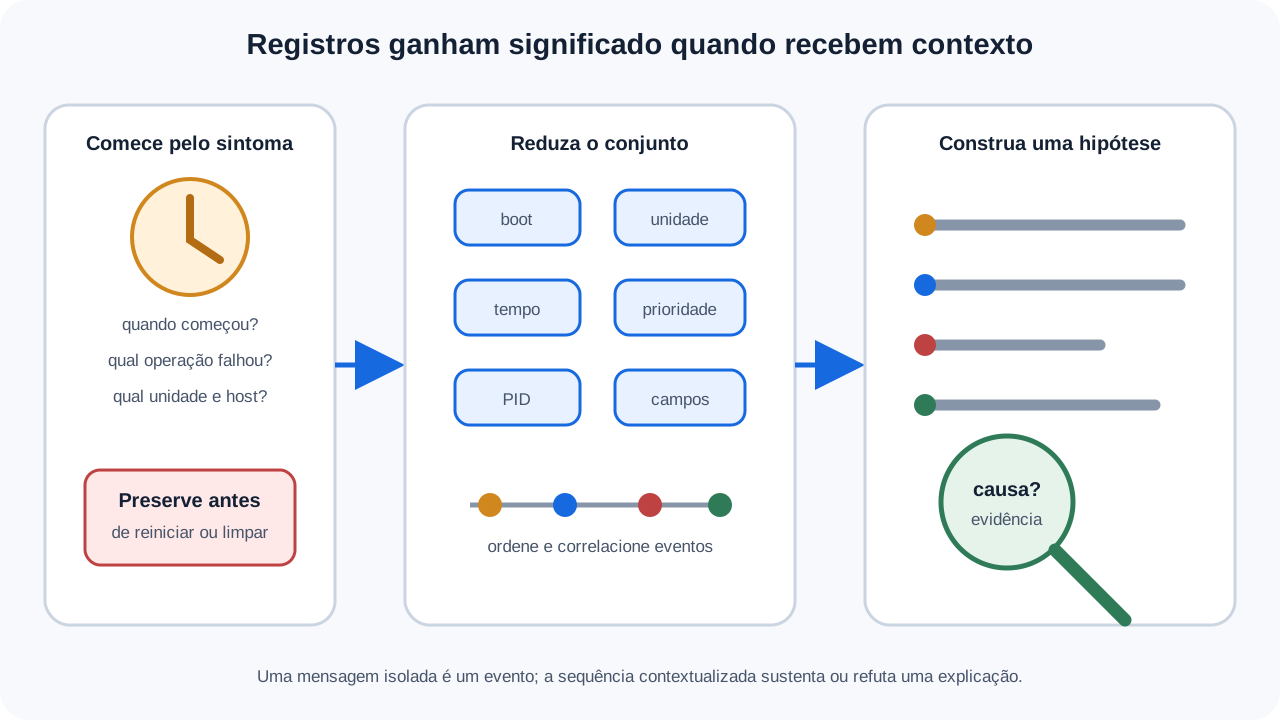
Uma investigação começa no sintoma
Considere uma aplicação que parou de responder às 14h12. Uma sequência prudente é:
- registrar operação, horário, host e impacto percebido;
- confirmar unidade, estado, resultado e PID principal;
- capturar fragmentos e drop-ins carregados, sem editar;
- consultar a janela do journal antes e depois do sintoma;
- correlacionar eventos de dependências, kernel, montagem, rede e aplicação;
- identificar a primeira divergência, não apenas a última mensagem;
- formular uma hipótese que explique estado e cronologia;
- definir teste seguro, mudança, validação e reversão.
Se o serviço falhou ao ler um segredo, a última linha pode dizer apenas “processo terminou”. A causa útil pode estar algumas linhas antes, no erro de permissão. Se a unidade iniciou antes de a montagem esperada estar pronta, o grafo e os horários ajudam a distinguir dependência ausente de arquivo inexistente.
Campos estruturados permitem associar eventos por _SYSTEMD_UNIT, _PID, _BOOT_ID, prioridade e origem. PIDs podem ser reutilizados ao longo do tempo; combinar PID com boot e janela temporal reduz ambiguidades. Em sistemas distribuídos, relógios, fusos e atraso de transporte também precisam ser considerados.
Logs precisam de retenção, acesso e proteção
Registros consomem espaço e podem conter caminhos, nomes, identificadores, parâmetros e dados pessoais. Uma política de logs define finalidade, campos permitidos, acesso, retenção, rotação, transporte e descarte. “Guardar tudo para sempre” não é observabilidade responsável.
O acesso de leitura também é sensível. O journal do sistema não deve ficar aberto a qualquer conta apenas por conveniência. A aula anterior mostrou como grupos e ACLs podem conceder leitura sem permitir escrita direta nos arquivos. Encaminhar registros para outro host pode melhorar preservação contra falha local, mas acrescenta rede, autenticação, disponibilidade e proteção de dados ao projeto.
Rotação evita crescimento ilimitado, porém pode remover justamente a janela necessária para investigar um problema raro. Capacidade e retenção devem ser dimensionadas com base na taxa real, nos requisitos e no tempo típico até a detecção. Alertas de espaço e falhas de encaminhamento fazem parte da própria operação do registro.
Windows oferece responsabilidades equivalentes, não comandos iguais
No Windows, o Service Control Manager mantém a base de serviços, inicia programas, envia controles e recebe estados reportados. Um serviço passa por estados como START_PENDING, RUNNING, STOP_PENDING e STOPPED. O programa precisa informar corretamente suas transições para que ferramentas não confundam inicialização longa com travamento.
O Visualizador de Eventos e as APIs de Windows Event Log reúnem registros por canais e provedores. Isso não equivale campo a campo ao journal nem torna systemctl aplicável ao Windows. A comparação útil está nas responsabilidades: configuração, ativação, estado, identidade, recuperação e evidência.
Para observação somente de leitura no PowerShell:
Get-Service -Name 'NomeDoServico' | Format-List Name,DisplayName,Status,StartType
Get-CimInstance Win32_Service -Filter "Name='NomeDoServico'" |
  Select-Object Name,State,StartMode,StartName,ProcessId,ExitCode
Get-WinEvent -FilterHashtable @{ LogName='System'; StartTime=(Get-Date).AddMinutes(-30) } -MaxEvents 100
Consulte um canal e provedor específicos quando conhecidos para reduzir ruído. A leitura de alguns eventos exige privilégios. Assim como no Linux, reiniciar antes de preservar o estado pode apagar sintomas e mudar o contexto.
Erros comuns
- “Serviço e daemon são exatamente a mesma coisa.” Serviço é a função; daemon é um processo em segundo plano que pode implementá-la.
- “Daemon precisa se bifurcar duas vezes.” Esse protocolo é tradicional; supervisores modernos preferem frequentemente acompanhar o processo em primeiro plano.
- “systemd gerencia somente
.service.” Sockets, timers, paths, mounts, devices e targets também são unidades. - “
After=inicia a dependência.” Ordenação não inclui sozinha uma unidade na transação. - “
Requires=define a ordem.” Requisito e sequência são eixos separados. - “Enabled significa rodando.” Habilitação trata ativação futura; active descreve estado atual.
- “Active significa aplicação saudável.” O estado confirma o contrato de início configurado, não toda função de negócio.
- “Oneshot inativo falhou.” Uma ação concluída pode retornar corretamente ao estado inativo.
- “PID principal representa todo o serviço.” Trabalhadores podem pertencer ao cgroup da unidade.
- “Reinício automático corrige a causa.” Ele recupera alguns sintomas e pode também criar um laço de falhas.
- “
statusmostra todo o histórico.” A saída é um resumo; consulte o journal com intervalo e filtros. - “Sem mensagem, não houve erro.” O componente pode não ter conseguido registrar ou a retenção pode ter expirado.
- “Prioridade error significa causa raiz.” Severidade é um atributo emitido; a cronologia ainda precisa ser analisada.
- “Journal substitui backup e monitoramento.” Ele registra eventos; não preserva todo estado nem mede sozinho a experiência do usuário.
- “Limpar logs libera espaço sem consequência.” A ação destrói evidência e exige política, não improviso.
O que você deve guardar
Serviço é uma função operacional e daemon é um processo em segundo plano que pode oferecê-la. Um gerenciador moderno supervisiona unidades, não apenas PIDs. No systemd, tipos diferentes representam serviços, sockets, timers, caminhos, montagens, dispositivos e agrupamentos.
Dependências de requisito decidem quais unidades entram em uma transação; dependências de ordenação decidem a sequência. Habilitar não é iniciar, active não é sinônimo de saudável e o marco de prontidão muda conforme Type=. Reinício automático precisa de atraso, limite e evidência.
Logs registram eventos com contexto, mas não constituem verdade completa. Uma investigação parte do sintoma e do tempo, preserva o estado, filtra por boot e unidade, correlaciona dependências e somente então testa uma hipótese. A aula sobre monitoramento e diagnóstico de CPU, memória, disco e processos amplia esse método para localizar contenção e gargalos entre recursos.
Referências
- systemd —
systemd.service. Acesso em 5 set. 2026. - systemd —
systemd.unit. Acesso em 5 set. 2026. - systemd —
systemctl. Acesso em 5 set. 2026. - systemd —
journalctl. Acesso em 5 set. 2026. - systemd —
systemd-journald.service. Acesso em 5 set. 2026. - systemd —
daemon(7). Acesso em 5 set. 2026. - Linux man-pages —
syslog(3). Acesso em 5 set. 2026. - Microsoft Learn — About Services. Acesso em 5 set. 2026.
- Microsoft Learn — Service State Transitions. Acesso em 5 set. 2026.