
Deadlock, starvation e livelock
Progresso é uma propriedade diferente de correção
Um programa concorrente pode preservar todos os dados e mesmo assim deixar de entregar resultados. Nenhum saldo fica incorreto, nenhuma estrutura é corrompida, porém as threads param, uma delas nunca recebe oportunidade ou todas repetem ações inúteis. Esses são problemas de vivacidade: dizem respeito à capacidade de continuar avançando.
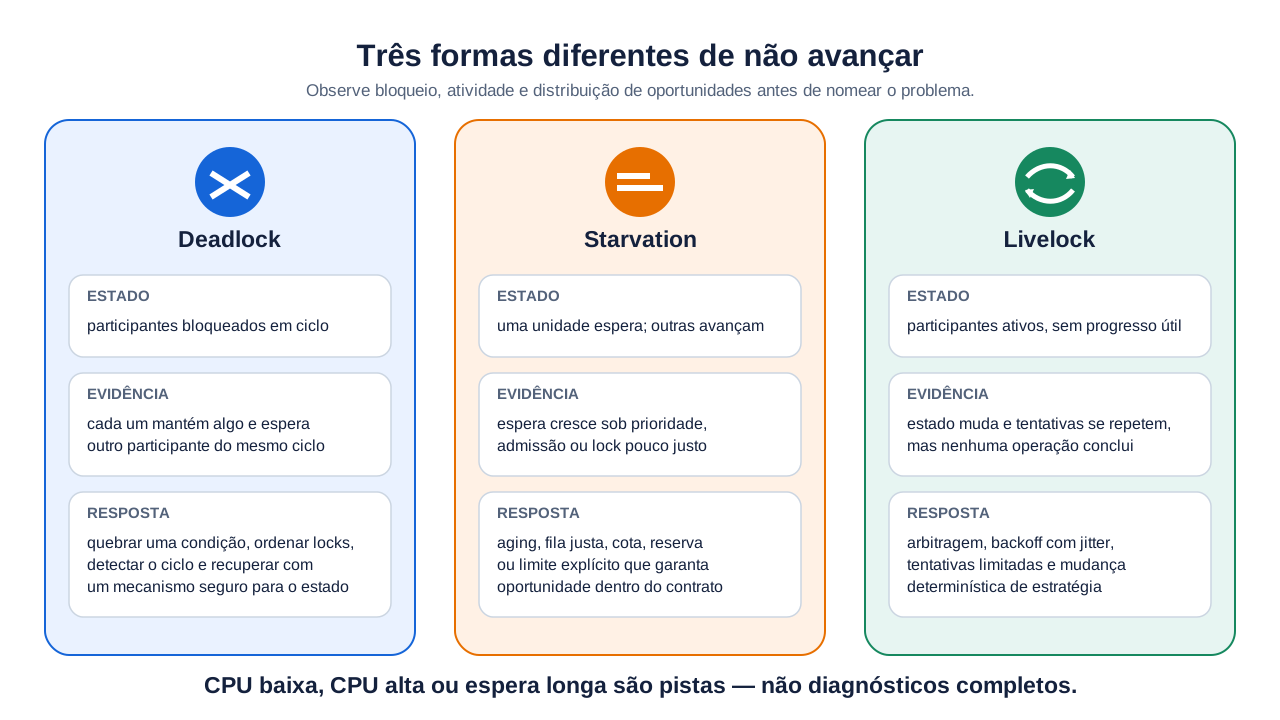
Deadlock, starvation e livelock descrevem falhas diferentes de progresso:
- no deadlock, participantes ficam bloqueados por dependências que formam um ciclo sem saída;
- no starvation, o sistema continua avançando, mas uma unidade é continuamente preterida;
- no livelock, participantes permanecem ativos e respondem uns aos outros, porém não concluem trabalho útil.
A aula anterior explicou condições de corrida e mecanismos de sincronização. Agora veremos como aquisições, prioridades e tentativas de recuperação podem impedir o progresso. A política de escalonamento continua relevante, mas CPU disponível não resolve uma dependência circular.
Espera normal, timeout e hang não são sinônimos
Uma thread bloqueada não está necessariamente com defeito. Ela pode aguardar uma resposta de rede, um item em uma fila, um temporizador ou a liberação normal de um mutex. Se o evento ocorre e a thread continua, houve espera, não deadlock.
Um timeout é uma política que limita quanto a operação aceita esperar. Seu vencimento informa que o prazo terminou; não identifica sozinho a causa. O recurso pode apenas estar lento, o proprietário pode estar executando, pode haver starvation ou pode existir um ciclo real.
Hang é um sintoma percebido: a aplicação parece não responder. A causa pode ser deadlock, loop infinito, I/O sem prazo, saturação, pausa longa do runtime ou trabalho pesado na thread responsável pela interface. Nomear o sintoma como diagnóstico leva a correções erradas.
Antes de concluir que existe deadlock, pergunte:
- quem está esperando;
- qual recurso ou evento cada participante espera;
- quem pode produzir esse evento ou liberar o recurso;
- se esse produtor também está esperando;
- se a cadeia termina em alguém capaz de executar.
Deadlock forma uma dependência circular
Considere dois mutexes, A e B:
thread T1                    thread T2
adquire A                    adquire B
tenta adquirir B             tenta adquirir A
espera T2                    espera T1
T1 não libera A porque está parada antes do trecho de liberação. T2 não libera B pela mesma razão. Nenhuma mudança de quantum ou aumento geral de CPU desfaz o ciclo: cada thread espera uma ação que somente a outra poderia executar.
Um grafo de espera representa threads como nós e cria uma seta T1 → T2 quando T1 depende de T2. Com recursos de instância única e proprietários conhecidos, um ciclo identifica deadlock. Em modelos com várias instâncias equivalentes, um ciclo em um grafo de alocação pode indicar risco sem ser suficiente; a disponibilidade de outra instância pode permitir progresso.
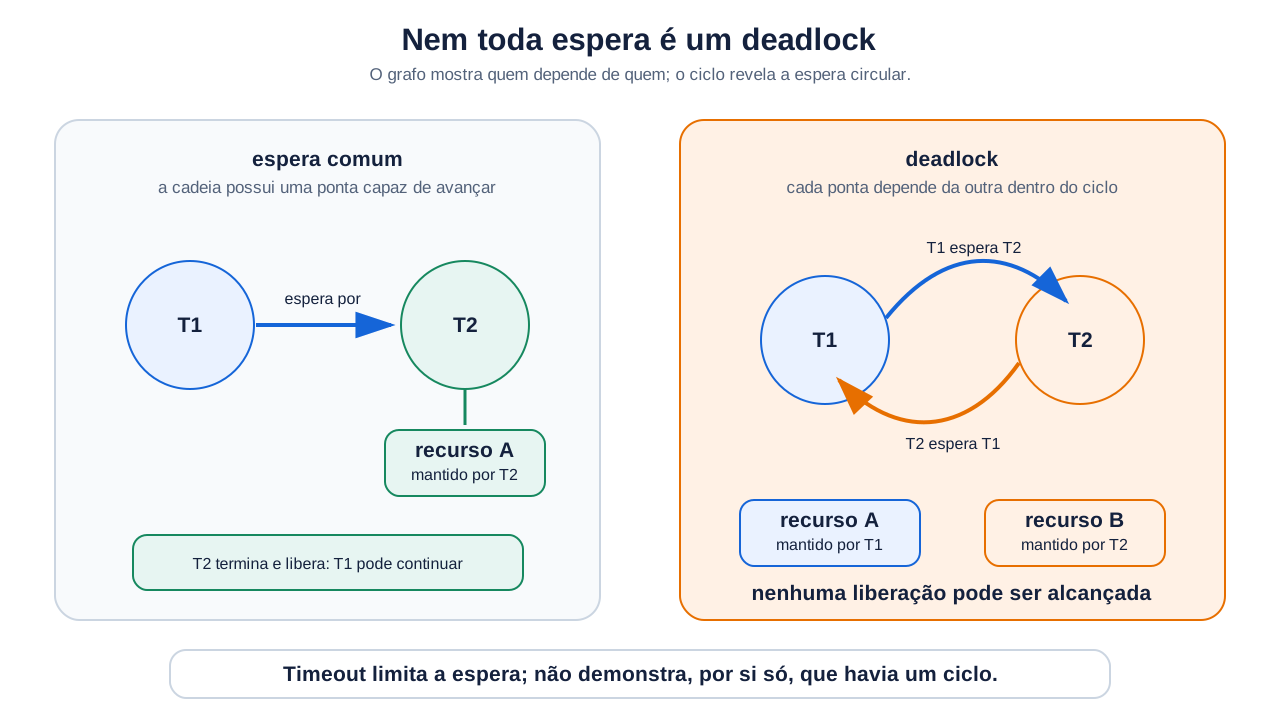
O ciclo pode envolver mais de duas threads e recursos que não parecem locks: slots de conexão, buffers, filas limitadas, callbacks síncronos, mensagens entre processos ou operações que aguardam conclusão umas das outras.
Quatro condições tornam o deadlock possível
O modelo clássico associado a Coffman, Elphick e Shoshani identifica quatro condições necessárias que coexistem em um deadlock de recursos reutilizáveis:
- exclusão mútua: ao menos um recurso não pode ser usado simultaneamente pelos participantes;
- posse e espera: alguém mantém recursos enquanto solicita outros;
- ausência de preempção: o recurso não pode ser retirado com segurança; precisa ser liberado pelo proprietário;
- espera circular: existe um ciclo em que cada participante espera por recurso mantido pelo próximo.
A presença das quatro condições cria a possibilidade; não significa que toda execução necessariamente chegará ao ciclo. No exemplo, se T1 adquirir A e B antes de T2 adquirir qualquer um, ambas podem terminar normalmente. O interleaving determina se a configuração perigosa é alcançada.
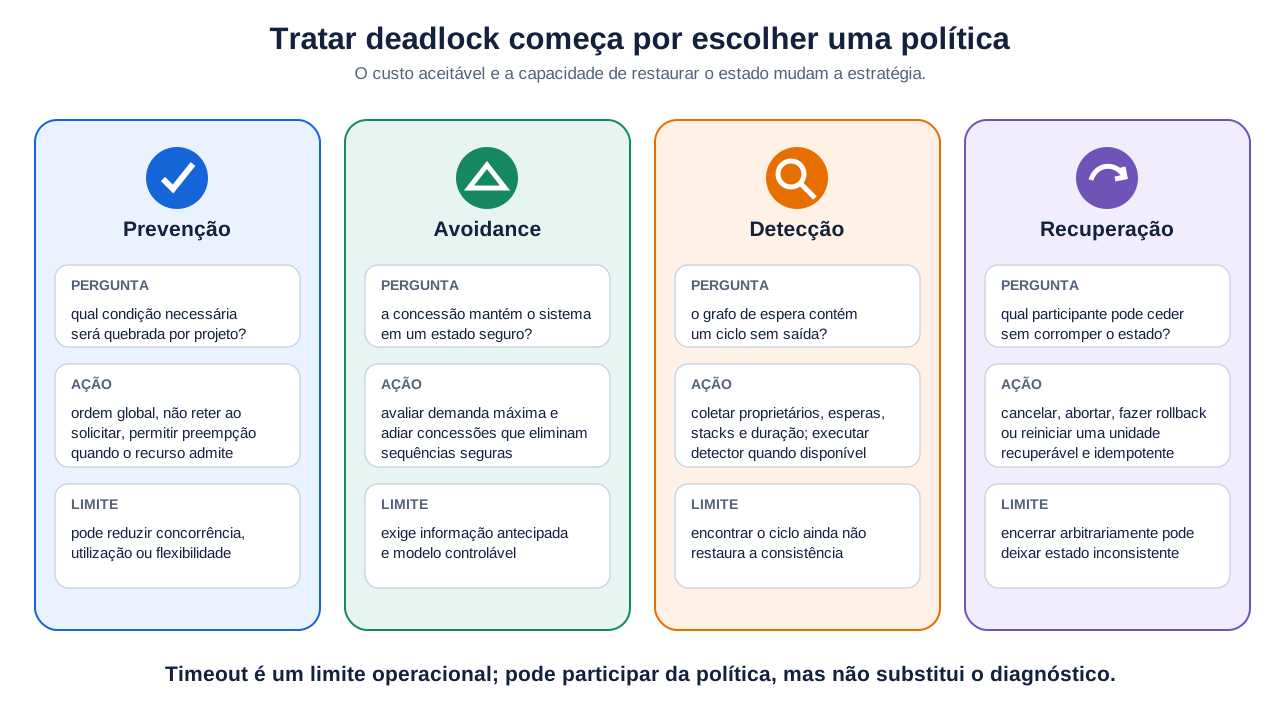
Essa formulação oferece uma estratégia poderosa: prevenir deadlock é garantir que pelo menos uma condição não possa ocorrer dentro do protocolo relevante.
Ordem global quebra a espera circular
Uma regra comum atribui ordem total aos locks e exige que todos os caminhos os adquiram nessa ordem. Se A < B, qualquer operação que precise dos dois adquire A antes de B. Uma thread nunca mantém B enquanto espera A; o ciclo desse par deixa de ser possível.
Para duas contas, ordenar por um identificador estável evita que transferências opostas escolham ordens diferentes:
primeiro = conta com menor identificador
segundo  = conta com maior identificador

adquirir(primeiro)
try
    adquirir(segundo)
    try
        transferir preservando a invariante
    finally
        liberar(segundo)
finally
    liberar(primeiro)
A chave de ordenação precisa ser única, estável e aplicada em todos os caminhos. Empate mal resolvido, comparação mutável ou método antigo que usa ordem diferente reintroduzem o risco.
Também é possível quebrar posse e espera solicitando todos os recursos antes de iniciar. Isso simplifica dependências, mas pode reter itens ainda sem uso e reduzir concorrência. Liberar tudo ao falhar e tentar depois evita espera bloqueada, porém pode criar livelock se todos repetirem em sincronia.
Quebrar ausência de preempção funciona somente quando o estado pode ser devolvido com segurança. CPU e memória podem ser remanejadas pelo sistema sob certos contratos; um arquivo parcialmente gravado ou dispositivo no meio de uma operação pode não admitir retirada simples.
Eliminar exclusão mútua é possível para recursos compartilháveis, dados imutáveis ou leituras compatíveis. Não é uma escolha válida quando a própria invariante exige uso exclusivo.
Evitação concede recursos somente em estado seguro
A evitação de deadlock (deadlock avoidance) não proíbe todas as quatro condições. Antes de conceder um recurso, avalia se o sistema permanecerá em um estado seguro: ainda existe alguma sequência em que todos os participantes podem obter o restante necessário e terminar.
O algoritmo do banqueiro é o exemplo didático clássico. Ele precisa conhecer recursos disponíveis, alocações atuais e demandas máximas declaradas. Uma concessão pode ser fisicamente possível agora e ainda ser adiada porque removeria todas as sequências seguras.
Estado inseguro não é deadlock atual. Significa que o sistema perdeu a garantia de uma sequência de conclusão e pode entrar em deadlock dependendo das próximas solicitações. Essa diferença costuma aparecer em exercícios e concursos.
Na prática, demandas máximas nem sempre são conhecidas, recursos mudam e o custo de avaliação pode ser inadequado. Por isso, muitos sistemas preferem prevenção localizada, detecção ou componentes de alto nível com protocolos já testados.
Detectar exige observar proprietários e esperas
Outra política permite que esperas ocorram, constrói o grafo e procura ciclos. Detectar é apropriado quando prevenção custaria muito, deadlocks são raros e existe forma segura de recuperar.
A frequência de detecção também tem custo. Verificar a cada solicitação reduz tempo até reação e aumenta overhead. Verificar periodicamente economiza análise, mas prolonga indisponibilidade. Um gatilho por espera anormal pode equilibrar os dois, desde que não confunda lentidão com ciclo.
As evidências mais úteis incluem:
- stack de cada thread;
- estado e duração da espera;
- objeto solicitado e seu proprietário;
- ordem em que locks foram adquiridos;
- identificador da requisição e operação de negócio;
- séries de progresso, fila e conclusão;
- dump coletado antes de reiniciar.
Na JVM, um comando como o seguinte imprime stacks e informações de locks de uma aplicação Java específica:
jcmd 1234 Thread.print -l
O PID é apenas exemplo. A documentação classifica o impacto como médio, portanto colete com critério em produção. No Windows, a API Wait Chain Traversal permite que depuradores acompanhem uma sequência alternada de threads e objetos de sincronização para diagnosticar hangs e deadlocks.
Uma fotografia isolada pode mostrar espera legítima. Deteção confiável combina estrutura do ciclo, duração e conhecimento do contrato.
Recuperar exige uma fronteira consistente
Depois de detectar um ciclo, o sistema precisa quebrá-lo. Possibilidades incluem cancelar uma operação, abortar um participante, retirar um recurso recuperável, realizar rollback ou reiniciar um componente.
A escolha de uma vítima pode considerar trabalho já realizado, prioridade, recursos mantidos, número de dependentes, custo de repetição e impacto ao usuário. Escolher sempre o participante mais barato pode causar starvation se ele for repetidamente abortado.
Encerrar uma thread arbitrariamente é perigoso. Ela pode possuir outros locks, ter atualizado metade de uma estrutura ou estar dentro de código que não tolera interrupção. Recuperação precisa de uma fronteira que restaure consistência: transação, mensagem idempotente, checkpoint ou processo isolado.
Em bancos, o SGBD costuma abortar uma transação do ciclo e desfazer seus efeitos. Esse comportamento é aprofundado em concorrência, isolamento, locks e MVCC. Um mutex comum dentro de um processo não oferece rollback equivalente.
Starvation permite progresso para os outros
Na starvation, ou inanição, uma thread permanece elegível ou tenta obter um recurso, mas outras recebem continuamente a oportunidade. Não precisa existir ciclo. O sistema pode apresentar boa vazão global enquanto uma requisição envelhece sem concluir.
Exemplos incluem:
- fluxo constante de alta prioridade ultrapassa trabalho de baixa prioridade;
- lock sem garantia de justiça favorece repetidamente os mesmos concorrentes;
- leitores chegam sem cessar e um escritor nunca encontra janela, conforme a política;
- fila é reordenada sempre pelo menor trabalho e itens longos ficam atrás;
- recuperação escolhe sempre a mesma vítima barata.
As respostas dependem do contrato: aging, fila justa, limite de ultrapassagens, alternância entre classes, cota, reserva de capacidade ou prioridade efetiva crescente. Justiça estrita pode reduzir vazão ou localidade; é uma propriedade a ser definida, não uma configuração universal.
Métricas agregadas escondem starvation. Além de média, observe percentis altos, idade máxima da fila e quantidade de operações que excederam o objetivo. Se cem tarefas rápidas terminam e uma espera para sempre, a média pode parecer saudável.
Livelock mantém atividade sem trabalho útil
No livelock, participantes não estão necessariamente bloqueados. Eles mudam estado em resposta uns aos outros, mas essas mudanças impedem conclusão. Dois agentes educados que desviam para o mesmo lado, percebem o conflito e desviam juntos para o outro ilustram a ideia.
Em software, imagine duas threads que tentam adquirir A e B sem bloquear:
adquire A
se B estiver ocupado
    libera A
    tenta imediatamente de novo
Se ambas executam o mesmo protocolo no mesmo ritmo, cada uma adquire um recurso, falha no outro, libera e repete. Há CPU, logs e aquisições; não há operação concluída.
Backoff insere espera crescente entre tentativas. Jitter adiciona variação aleatória para que concorrentes não acordem juntos. Limite de tentativas impede repetição infinita e transfere a decisão para fila, erro controlado ou arbitragem. Somente aleatoriedade não oferece garantia formal de progresso, mas reduz sincronização acidental em muitos protocolos.
Uma tempestade de retries é parente operacional do livelock: falha temporária faz muitos clientes repetirem ao mesmo tempo, elevando a carga e prolongando a falha. Backoff exponencial com jitter, orçamento de tentativas e idempotência ajudam a estabilizar o sistema.
Inversão de prioridade é outra relação
Na inversão de prioridade, uma thread importante espera por recurso mantido por outra de prioridade menor. Uma terceira, de prioridade intermediária, pode preemptar a proprietária e prolongar indiretamente a espera da mais importante.
Isso não é necessariamente deadlock: quando a proprietária de baixa prioridade volta a executar, pode liberar o recurso. Também não é automaticamente starvation, embora uma inversão sem limite possa impedir progresso pelo prazo relevante.
Protocolos de herança ou teto de prioridade podem limitar o problema em plataformas compatíveis. Eles precisam ser considerados junto ao escalonamento de CPU e às classes de prioridade, não como substitutos para ordem de locks e regiões críticas curtas.
Projetar para progresso reduz a investigação posterior
Algumas decisões evitam famílias inteiras de falhas:
- prefira primitivas e coleções concorrentes consolidadas;
- minimize locks aninhados e documente uma ordem global;
- não faça I/O, callback desconhecido ou espera longa enquanto mantém mutex;
- use timeout onde exista resposta segura para o vencimento;
- limite retries e aplique backoff com jitter;
- projete operações repetíveis ou compensáveis quando recuperação exigir repetição;
- monitore idade máxima e conclusões, não apenas uso de CPU;
- reduza estado mutável compartilhado por imutabilidade, partição ou transferência de propriedade;
- preserve evidências antes de reiniciar o componente.
Timeout não deve apenas ocultar o problema. Se a operação abandona a espera mas deixa o recurso adquirido, cria novo defeito. Se todos expiram e repetem juntos, pode converter contenção em livelock. Toda saída precisa liberar recursos e manter a invariante.
Um roteiro de diagnóstico evita conclusões apressadas
Quando uma aplicação parece parada:
- confirme o impacto e o intervalo sem progresso;
- meça se alguma operação semelhante ainda conclui;
- diferencie threads executando, bloqueadas e aguardando eventos externos;
- colete stacks e proprietários mais de uma vez;
- construa a cadeia de espera;
- procure ciclo, preterição contínua ou repetição de estado;
- verifique mudanças recentes em ordem de locks, limites, prioridades e retries;
- preserve dump, logs e correlação antes de recuperar;
- aplique a correção na causa e adicione teste ou detector proporcional.
Se todas as threads relevantes exibem stacks idênticas aguardando os mesmos proprietários, há pista forte. Se stacks mudam rapidamente, CPU está alta e nenhuma operação termina, considere livelock. Se o restante avança e uma idade de fila cresce, investigue starvation.
Nenhum desses sinais isolados prova o diagnóstico. O modelo de dependências completa a análise.
Erros comuns
- “Toda espera longa é deadlock.” I/O lento, timeout ausente e saturação também causam espera.
- “Deadlock exige somente dois locks.” Ciclos podem envolver muitos participantes e tipos de recurso.
- “Um ciclo sempre prova deadlock.” Em grafos de recursos com múltiplas instâncias, outra instância pode permitir progresso.
- “As condições de Coffman garantem que haverá deadlock.” Elas tornam a configuração possível; a execução precisa alcançar o ciclo.
- “Timeout detecta deadlock.” Ele apenas encerra uma espera segundo um prazo.
- “Reiniciar corrige o problema.” Restaura serviço temporariamente e apaga evidência se não houver coleta.
- “Tentar de novo sempre resolve.” Retries sincronizados podem criar livelock e sobrecarga.
- “CPU alta exclui problema de vivacidade.” Livelock pode consumir CPU sem concluir trabalho.
- “CPU baixa prova deadlock.” A aplicação pode aguardar I/O legítimo.
- “Starvation e inversão de prioridade são iguais.” Uma descreve falta persistente de oportunidade; a outra, dependência de prioridade invertida.
- “Matar qualquer thread é recuperação.” Interrupção sem fronteira consistente pode corromper estado.
- “Deadlock do banco é igual a mutex local.” O SGBD possui transações, detector e rollback próprios.
O que você deve guardar
Deadlock é uma espera circular sem caminho interno para liberação. Exclusão mútua, posse e espera, ausência de preempção e espera circular coexistem no modelo clássico. Prevenção quebra uma dessas condições; evitação preserva estados seguros; detecção encontra ciclos; recuperação precisa restaurar consistência.
Starvation ocorre quando outros avançam e um participante é continuamente preterido. Livelock mantém atividade e mudanças, mas não conclusão. Aging, filas justas e reservas tratam oportunidade; arbitragem, backoff com jitter e tentativas limitadas tratam reações repetitivas.
Diagnóstico confiável observa stacks, proprietários, duração, grafo e progresso. Timeout é parte de um contrato operacional, não explicação causal. A melhor correção torna a propriedade de progresso explícita no desenho e mantém evidência suficiente para verificá-la.
Com esta aula, concluímos o módulo de Processos e concorrência. O próximo módulo começa pela relação entre memória física, endereços usados por programas e o espaço de memória isolado de cada processo.
Referências
- Coffman, Elphick e Shoshani — “System Deadlocks”, ACM Computing Surveys, 1971. Acesso em 5 set. 2026.
- The Open Group — POSIX.1-2024: Definitions of Mutex and Priority Inversion. Acesso em 5 set. 2026.
- The Open Group — POSIX.1-2024: Thread Mutexes and Scheduling. Acesso em 5 set. 2026.
- The Open Group — POSIX.1-2024:
pthread_mutex_lock. Acesso em 5 set. 2026. - Oracle — Java Tutorials: Liveness. Acesso em 5 set. 2026.
- Oracle — Java Tutorials: Starvation and Livelock. Acesso em 5 set. 2026.
- Oracle —
jcmdCommand:Thread.print. Acesso em 5 set. 2026. - Microsoft Learn — Wait Chain Traversal. Acesso em 5 set. 2026.
- Microsoft Learn — Deadlock Detection for Windows Drivers. Acesso em 5 set. 2026.
- SEI CERT — LCK07-J: Avoid deadlock by requesting and releasing locks in the same order. Acesso em 5 set. 2026.
- ACM, IEEE-CS e AAAI — CS2023: Operating Systems. Acesso em 5 set. 2026.