
Máquinas virtuais e contêineres: isolamento e compartilhamento
Virtualizar é apresentar outra visão de um recurso
Virtualização cria uma representação controlada de algo físico ou global: processadores, memória, dispositivos, rede, armazenamento ou o próprio ambiente do sistema operacional. Duas técnicas podem parecer iguais para quem executa uma aplicação e ainda estabelecer fronteiras muito diferentes por baixo.
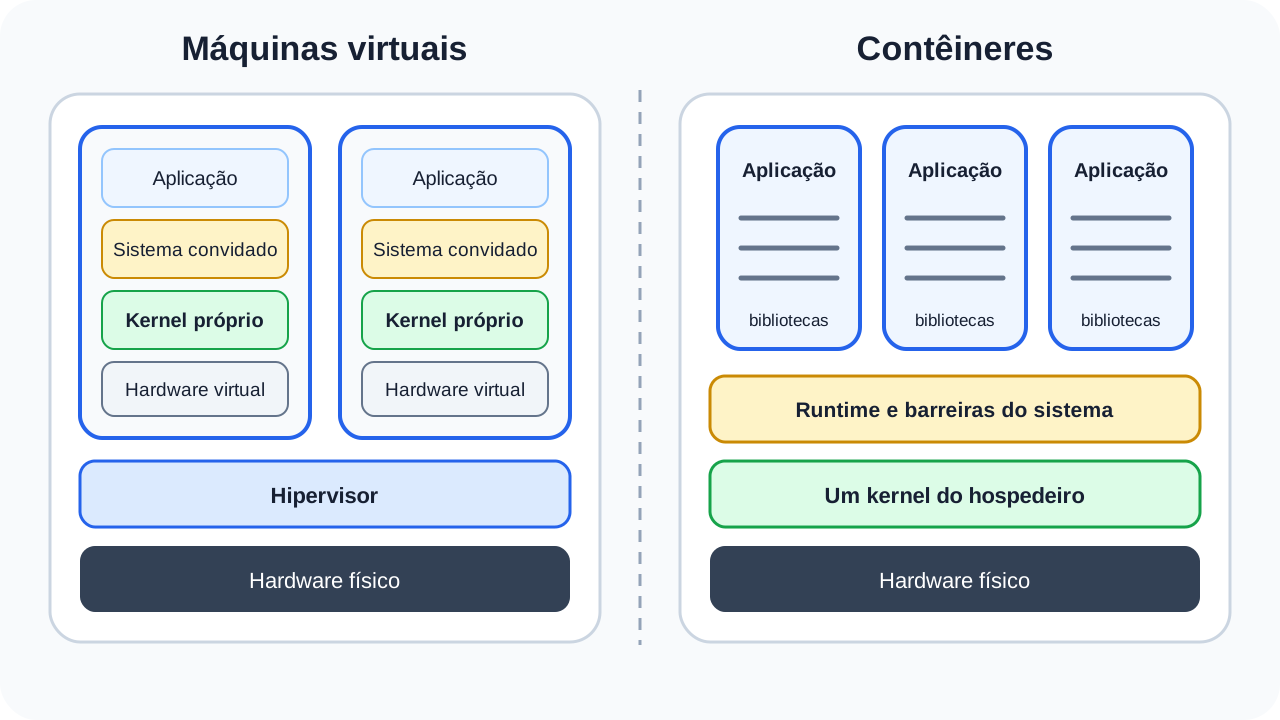
Uma máquina virtual, ou VM, recebe hardware virtual sobre o qual executa um sistema operacional convidado com kernel próprio. Um contêiner de sistema operacional reúne processos cuja visão e consumo de recursos são separados por mecanismos do kernel hospedeiro. No modelo mais comum de contêiner Linux, não existe um segundo kernel Linux escondido na imagem.
Esta aula compara arquiteturas. Ela não ensina uma plataforma específica de nuvem ou orquestração. Os conceitos de kernel, espaço de usuário e chamadas de sistema, processos e memória virtual formam a base para entender o que cada técnica separa e o que compartilha.
A máquina virtual começa pelo hardware virtual
O hipervisor, também chamado Virtual Machine Monitor, arbitra o acesso das VMs ao processador, à memória e aos dispositivos. Cada VM observa processadores virtuais, regiões de memória e dispositivos como controladores de disco e interfaces de rede. Sobre essa plataforma, o convidado inicializa firmware virtual, kernel, drivers, serviços e aplicações.
O processador moderno oferece extensões para executar código convidado e devolver controle ao hipervisor quando ocorre uma operação que precisa ser mediada. A memória exige outra tradução: o endereço virtual do processo é traduzido pelo kernel convidado para uma visão física do convidado, que por sua vez precisa corresponder à memória do hospedeiro. Recursos de tradução assistida por hardware reduzem o custo desse caminho.
E/S pode ser emulada, apresentando um dispositivo conhecido pelo convidado, ou paravirtualizada, usando drivers conscientes da plataforma virtual para cooperar com o hospedeiro. Em Hyper-V, por exemplo, partições filhas usam dispositivos virtuais e canais VMBus; no ecossistema KVM, um monitor de máquina virtual em espaço de usuário costuma complementar a interface oferecida pelo kernel. “Hipervisor” não designa necessariamente todo o conjunto de gerenciamento, emulação e armazenamento.
Classificações como hipervisor “tipo 1” e “tipo 2” ajudam a distinguir implantação direta sobre a plataforma de hardware de uma solução hospedada sobre outro sistema. Arquiteturas reais, porém, podem dividir funções entre hipervisor, kernel, partição privilegiada e processos de usuário. É mais preciso perguntar onde ficam drivers, gerenciamento e mediação do que concluir tudo pelo número do tipo.
Cada VM mantém seu próprio kernel
A fronteira de uma VM envolve um sistema convidado completo. Duas VMs no mesmo host podem executar kernels, versões e configurações diferentes, desde que a plataforma suporte a arquitetura e os dispositivos apresentados. Atualizar o kernel de uma não atualiza automaticamente o da outra.
Essa independência tem custo. Memória do kernel, serviços básicos, estruturas de página e armazenamento do sistema convidado aparecem em cada VM. Inicializar a instância inclui o boot daquele sistema. Técnicas de compartilhamento, ballooning, páginas esparsas e cache podem reduzir consumo físico, mas não tornam a sobrecarga nula nem garantem a capacidade prometida sob disputa.
Ao mesmo tempo, o kernel separado amplia a fronteira. Uma falha dentro do kernel convidado normalmente permanece naquela VM, salvo vulnerabilidade ou configuração que atravesse o hipervisor, dispositivos compartilhados ou plano de gerenciamento. Isso não torna a VM “segura por definição”: o hipervisor possui alto privilégio, imagens podem estar vulneráveis e redes, discos, credenciais e interfaces administrativas ainda precisam de proteção.
Um contêiner é formado por processos do hospedeiro
Quando um runtime inicia um contêiner Linux, ele cria ou associa processos a namespaces, cgroups e outras políticas, prepara o sistema de arquivos e executa o comando configurado. Esses processos continuam sendo escalonados pelo mesmo kernel que atende o restante do host. Ferramentas no hospedeiro podem vê-los, embora a visão de dentro seja deliberadamente diferente.
O termo runtime abrange o componente que transforma uma configuração e um sistema de arquivos em processos isolados e acompanha seu ciclo de vida. Uma ferramenta de desenvolvimento, um daemon de alto nível, um runtime compatível com OCI e o kernel cumprem responsabilidades diferentes. Dizer que “o Docker é o contêiner” mistura produto, formato, gerenciamento e instância.
O contêiner não precisa carregar um sistema operacional completo, mas sua imagem normalmente contém bibliotecas, executáveis, arquivos de configuração e uma árvore de arquivos esperada pela aplicação. Uma distribuição presente na imagem fornece espaço de usuário; o kernel continua sendo o do hospedeiro. Por isso, ver arquivos de uma distribuição dentro do contêiner não prova que seu kernel também está ali.
Namespaces mudam o que os processos enxergam
Um namespace envolve um recurso global em uma abstração que parece própria aos processos participantes. O Linux oferece namespaces para diferentes dimensões, entre elas:
| Namespace | Visão que pode ser separada | O que ele não resolve sozinho |
|---|---|---|
| PID | identificadores e árvore de processos | consumo de CPU ou memória |
| mount | montagens e árvore de arquivos | permissões sobre os objetos montados |
| network | interfaces, rotas, sockets e portas | política externa de tráfego |
| IPC | mecanismos de comunicação entre processos | toda comunicação por rede ou arquivo |
| UTS | hostname e nome de domínio | identidade de segurança |
| user | mapeamento de usuários, grupos e capabilities | limites de recursos |
| cgroup | visão da posição na hierarquia de cgroups | os limites definidos pelos controladores |
| time | determinados relógios por namespace | relógio físico e todas as fontes de tempo |
Namespaces são combináveis e podem ser compartilhados seletivamente. Se uma configuração omite um tipo, o processo pode herdar a visão do runtime. Portanto, “está em um contêiner” não informa sozinho quais fronteiras existem. Compartilhar o namespace de rede ou PID pode ser intencional, mas muda o modelo de isolamento e precisa ser tratado explicitamente.
Um namespace de usuário permite mapear uma identidade privilegiada dentro do ambiente para uma identidade sem privilégio fora dele. “Root no contêiner” e root no host podem então ser credenciais diferentes. Sem esse mapeamento, ou com privilégios e dispositivos excessivos, o impacto potencial aumenta.
Cgroups controlam quanto um grupo pode consumir
Namespaces tratam principalmente de visão e identidade. Control groups, ou cgroups, organizam processos hierarquicamente para contabilizar e controlar recursos. No cgroup v2, controladores podem regular CPU, memória, E/S, quantidade de processos e outros recursos conforme o suporte do sistema.
Um limite de CPU não cria processadores. Ele restringe o tempo que o grupo pode receber; sob capacidade ociosa, políticas de peso podem permitir uso flexível. Um limite de memória também não reserva necessariamente todos os bytes antecipadamente. Pressão, recuperação de páginas e encerramento por falta de memória dependem dos limites e da carga real.
Dois erros opostos são comuns: iniciar contêineres sem limites e presumir que o isolamento visual impedirá exaustão; ou configurar um limite e tratá-lo como garantia de desempenho. Limite reduz o máximo permitido. Reserva, prioridade, afinidade, capacidade física e disputa respondem perguntas diferentes.
A aula de monitoramento e diagnóstico de recursos mostrou por que processos de um serviço devem ser observados como grupo. Em ambientes com contêineres, métricas do host, do cgroup e de dentro da instância podem discordar porque medem escopos diferentes.
O kernel compartilhado aplica várias barreiras
Contêiner seguro não nasce de um único mecanismo. Além de namespaces e cgroups, uma configuração Linux pode combinar:
- identidade não privilegiada e namespace de usuário;
- conjunto mínimo de capabilities, dividindo poderes tradicionalmente associados ao superusuário;
- filtro seccomp para reduzir chamadas de sistema permitidas;
- políticas de Linux Security Modules, como SELinux ou AppArmor;
- sistema de arquivos somente leitura onde possível;
- montagens, dispositivos e segredos estritamente necessários;
- opção que impede ganhar novos privilégios durante
exec; - correções no kernel, runtime e componentes de gerenciamento.
Essas camadas não são intercambiáveis. Seccomp reduz superfície de syscall, mas não limita memória. Cgroups limitam recursos, mas não decidem quais arquivos podem ser abertos. Namespace de montagem muda a visão, mas uma montagem ampla do host pode reintroduzir acesso sensível.
Um modo “privileged”, capabilities amplas, dispositivos do host, socket do gerenciador ou diretórios críticos montados dentro da instância podem atravessar barreiras que o leitor imaginava existir. O risco não se resume à aplicação: o daemon e a API de gerenciamento possuem autoridade para criar ambientes e merecem proteção equivalente.
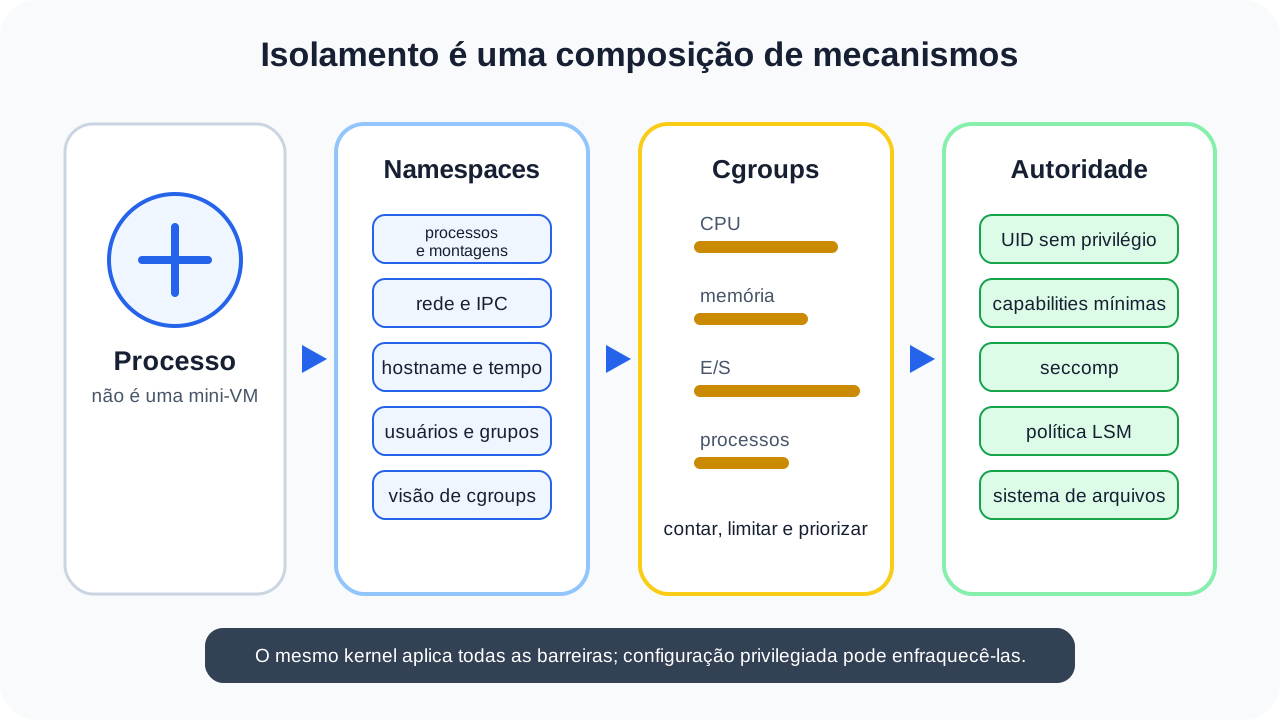
Imagem e contêiner não são a mesma coisa
Segundo a especificação OCI, uma imagem reúne manifesto, configuração e camadas do sistema de arquivos. As camadas registram adições, alterações e remoções em relação às anteriores; a configuração informa parâmetros como executável, argumentos, ambiente, usuário e diretório de trabalho. Conteúdo identificado por digest muda de identidade quando seus bytes mudam.
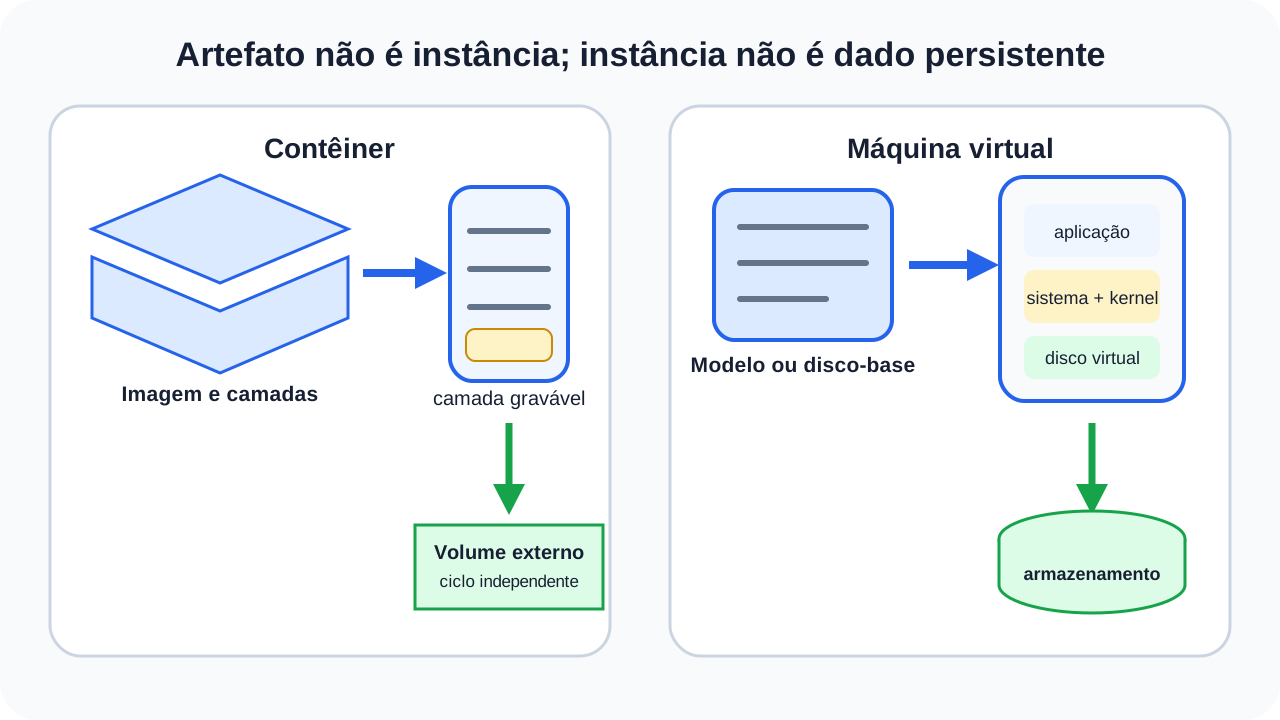
A imagem é um artefato usado para criar instâncias. O contêiner é a execução preparada a partir desse artefato e de uma configuração concreta. Vários contêineres podem partir da mesma imagem e ainda receber redes, limites, segredos e volumes diferentes.
Uma tag legível pode ser movida para outro manifesto; um digest identifica conteúdo específico. Para reprodutibilidade, saber exatamente qual imagem foi verificada é mais forte do que confiar apenas em um nome mutável. Isso não garante que o conteúdo seja seguro: procedência, assinatura, inventário, atualização e análise continuam necessários.
“Imagem imutável” também exige precisão. As camadas referenciadas são tratadas como conteúdo fixo; a instância normalmente ganha uma camada gravável e pode alterar seu estado durante a execução. Descartar o contêiner pode remover essa camada. Dados que precisam sobreviver devem usar armazenamento com ciclo de vida deliberado e backup compatível.
Disco virtual, camada gravável e volume têm ciclos diferentes
Uma VM costuma enxergar um ou mais discos virtuais. Eles podem ser arquivos, volumes ou dispositivos fornecidos por outra camada, mas o convidado os trata como dispositivos de bloco e mantém seus próprios sistemas de arquivos. Clonar um disco-base, criar snapshot ou anexar outro volume são operações da plataforma e não substituem backup consistente da aplicação.
No contêiner, a raiz pode ser composta por camadas da imagem mais uma camada gravável da instância. Um volume ou montagem externa liga dados cujo ciclo não deve depender daquele contêiner. Apagar a instância e criar outra da mesma imagem não recupera automaticamente dados que estavam apenas na camada descartada.
Persistência não define sozinha a arquitetura. Há contêineres com volumes duráveis e VMs descartáveis. A pergunta correta é: qual estado existe, quem o possui, onde é persistido, como é protegido e como será restaurado? A aula sobre atualizações, backup, recuperação e tolerância a falhas trata esse ciclo de forma canônica.
Rede virtual continua sendo rede
VMs e contêineres podem receber interfaces virtuais conectadas a bridges, switches virtuais, roteamento, tradução de endereços ou redes sobrepostas. A fronteira de execução não elimina conceitos de endereço, porta e rota. Eles continuam canônicos na trilha de Redes de Computadores.
Um namespace de rede dá à instância sua própria visão de interfaces e sockets, mas conectividade surge da configuração feita ao redor. Publicar uma porta normalmente instala algum caminho entre a rede externa e o processo; não copia a porta nem transforma automaticamente o serviço em seguro. Da mesma forma, uma interface virtual de VM ainda depende do switch virtual, das políticas e do caminho físico.
Portabilidade depende de kernel, arquitetura e ambiente
Uma imagem de contêiner empacota o espaço de usuário e seus padrões de execução, mas não leva qualquer kernel para qualquer destino. O manifesto possui plataforma, sistema operacional e arquitetura. O runtime e o host precisam oferecer ABI e recursos compatíveis. Dispositivos, capabilities, módulos, montagem e políticas podem variar.
Uma VM transporta um ambiente mais completo, inclusive kernel convidado, mas ainda depende de arquitetura suportada, formato de disco, firmware, dispositivos virtuais e recursos do hipervisor. Migrar entre plataformas pode exigir conversão ou drivers. Emulação de outra arquitetura é uma técnica distinta e pode impor custo relevante.
Assim, “funciona em qualquer lugar” deve significar “o artefato e seus requisitos foram declarados e validados nos destinos suportados”, não ausência de dependências. Quanto mais a aplicação exige características específicas do host, menor a portabilidade prática.
Leveza e velocidade são resultados, não definições
Contêineres frequentemente iniciam mais rápido e ocupam menos memória porque não precisam inicializar outro kernel e podem compartilhar camadas de imagem. Essa tendência não garante menor consumo para qualquer aplicação. Um processo pesado continua pesado, a camada de rede pode adicionar custo e limites mal ajustados podem causar contenção.
VMs carregam mais componentes, mas oferecem kernel próprio, compatibilidade com outro sistema convidado e uma fronteira útil para cargas com requisitos diferentes. A aceleração por hardware e drivers paravirtualizados pode entregar desempenho próximo do nativo em muitos cenários, sem torná-lo idêntico em toda operação.
Compare com medidas que representem a carga: tempo de inicialização, memória residente, latência, vazão, densidade, interferência entre vizinhos, tempo de atualização e recuperação. Um benchmark sem versão, configuração e condição de disputa não decide a arquitetura.
VMs e contêineres podem trabalhar juntos
A escolha não precisa ser exclusiva. É comum executar contêineres dentro de VMs: o hipervisor separa grupos ou locatários com kernels próprios; dentro de cada convidado, contêineres padronizam aplicações e controlam processos. Essa composição adiciona camadas de observação, rede, armazenamento e atualização, mas pode corresponder melhor ao risco e à operação.
Uma decisão responsável considera:
| Necessidade | Tendência a favorecer | Condição a verificar |
|---|---|---|
| kernel ou sistema operacional diferente | VM | arquitetura e suporte do hipervisor |
| alta densidade de processos semelhantes | contêiner | limites e compatibilidade com o kernel |
| fronteira entre cargas pouco confiáveis | VM ou sandbox reforçado | modelo de ameaça e tecnologia concreta |
| distribuição reproduzível da aplicação | imagem de contêiner | procedência, plataforma e configuração externa |
| dispositivo ou driver específico | depende | forma de exposição e impacto no isolamento |
| combinação de locatários e microsserviços | contêineres em VMs | custo e responsabilidade de cada camada |
Não escolha apenas pela popularidade. Identifique a fronteira de confiança, o kernel necessário, o estado persistente, a capacidade, o tempo de inicialização e quem atualizará cada camada.
Observe a fronteira antes de confiar nela
No Linux, consultas somente de leitura ajudam a reconhecer namespaces e cgroups do processo atual:
readlink /proc/self/ns/*
cat /proc/self/cgroup
cat /proc/self/status
cat /proc/self/mountinfo
Entradas de namespace exibem identificadores; o arquivo de cgroup mostra a posição visível na hierarquia; status inclui identidades e conjuntos de capabilities em formato codificado; mountinfo descreve a visão de montagens. Acesso, campos e interpretação dependem do kernel e das permissões.
Essas saídas não certificam isolamento. Elas ajudam a confirmar o que o processo vê. A avaliação completa exige também a configuração externa do runtime, limites efetivos, montagens, dispositivos, rede, políticas de segurança e autoridade do plano de gerenciamento.
Erros comuns
- “Contêiner é uma VM pequena.” No modelo de sistema operacional, ele é um conjunto de processos isolados sobre o kernel hospedeiro.
- “A imagem contém seu próprio kernel.” Imagens comuns carregam espaço de usuário; o kernel vem do host.
- “Namespace limita CPU e memória.” Visão e controle de consumo são responsabilidades diferentes; cgroups cumprem a segunda.
- “Cgroup reserva desempenho.” Limite, peso, reserva e capacidade física não são sinônimos.
- “Root dentro sempre é root fora.” Namespace de usuário pode mapear identidades, mas isso depende da configuração.
- “Contêiner impede qualquer acesso ao host.” Privilégios, devices, capabilities e montagens podem enfraquecer a fronteira.
- “VM é invulnerável porque tem kernel próprio.” Hipervisor, gerenciamento, imagens e integrações também possuem risco.
- “Tag identifica conteúdo imutável.” Tags podem mudar; digest identifica o conteúdo referenciado.
- “Apagar um contêiner não afeta dados.” Estado na camada gravável pode desaparecer; volumes têm outro ciclo.
- “Snapshot é backup.” Ele pode depender da origem e capturar estado inconsistente; recuperação precisa ser planejada e testada.
- “Contêiner sempre é mais rápido.” O resultado depende da carga, configuração e recurso medido.
- “VM e contêiner são alternativas incompatíveis.” Eles podem formar camadas complementares.
O que você deve guardar
Máquinas virtuais recebem uma plataforma virtual e executam sistemas convidados com kernels próprios. Contêineres de sistema operacional executam processos sobre um kernel compartilhado, combinando namespaces para separar visões, cgroups para controlar consumo e políticas adicionais para reduzir autoridade.
Imagem é artefato; contêiner é instância. Disco-base é artefato; VM é instância. Camadas graváveis, discos e volumes possuem ciclos de persistência diferentes. Nem a imagem nem o isolamento substituem procedência, atualização, limites, monitoramento e backup.
Referências
- Linux man-pages —
namespaces(7). Acesso em 5 set. 2026. - Linux man-pages —
user_namespaces(7). Acesso em 5 set. 2026. - Linux Kernel — Control Group v2. Acesso em 5 set. 2026.
- Linux Kernel — KVM API. Acesso em 5 set. 2026.
- Open Container Initiative — Runtime Specification. Acesso em 5 set. 2026.
- Open Container Initiative — Linux Container Configuration. Acesso em 5 set. 2026.
- Open Container Initiative — Image Format Specification. Acesso em 5 set. 2026.
- Open Container Initiative — Image Configuration. Acesso em 5 set. 2026.
- Docker Docs — Docker Engine security. Acesso em 5 set. 2026.
- Microsoft Learn — Arquitetura do Hyper-V. Acesso em 5 set. 2026.
- NIST SP 800-125 — Guide to Security for Full Virtualization Technologies. Acesso em 5 set. 2026.