
Sistemas de arquivos: arquivos, diretórios, metadados e links
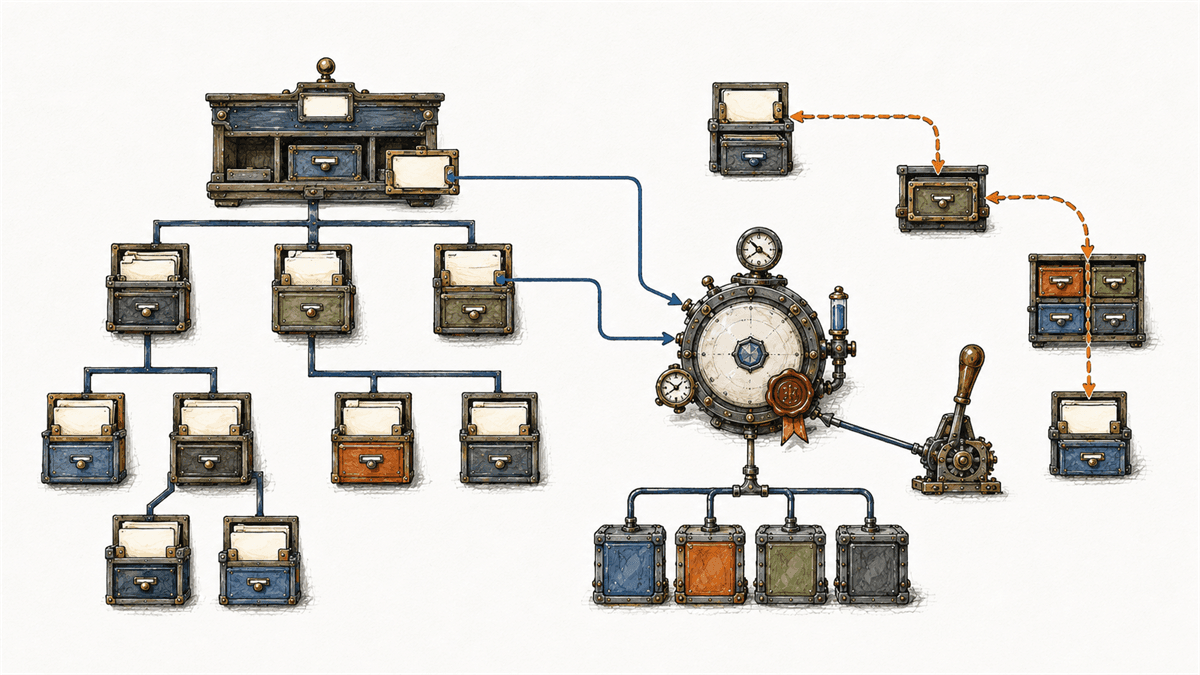
Sistema de arquivos transforma armazenamento em objetos nomeados
Um dispositivo de armazenamento oferece unidades nas quais bytes podem ser lidos e gravados. Aplicações, porém, normalmente não querem administrar posições físicas. Elas trabalham com arquivos, diretórios, caminhos, metadados e identificadores abertos. O sistema de arquivos define como esses objetos são representados, encontrados, protegidos e associados ao espaço disponível.
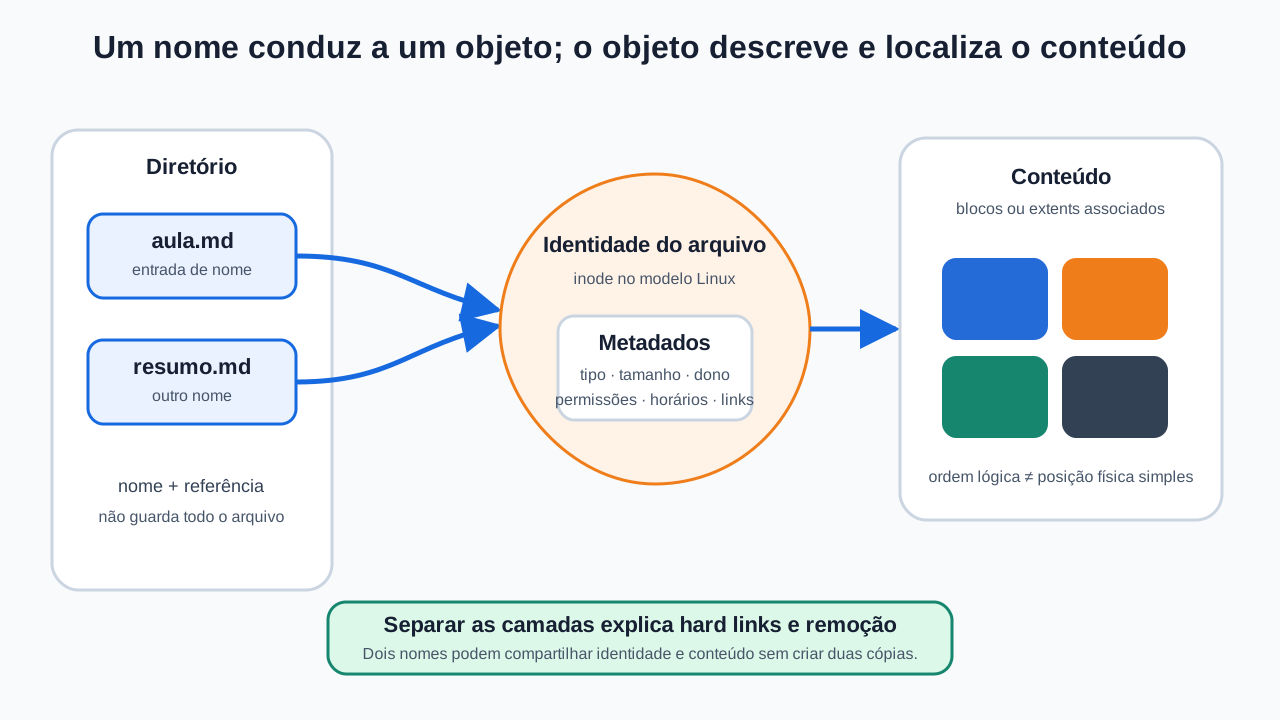
Um arquivo regular pode ser entendido como uma sequência de bytes acompanhada por metadados. O nome não precisa fazer parte do objeto: ele costuma existir em uma entrada de diretório que associa um componente de caminho à identidade interna do arquivo. Essa separação explica por que dois nomes podem designar o mesmo arquivo e por que remover um nome nem sempre elimina imediatamente seu conteúdo.
A aula anterior mostrou como drivers, controladores, interrupções e DMA realizam entrada e saída. Aqui subimos um nível: o foco é a organização lógica vista pelo kernel e pelas aplicações. Discos, partições, volumes, montagem e journaling serão tratados na próxima aula.
Arquivo não é sinônimo de nome nem de extensão
O arquivo regular oferece conteúdo acessível por posições. Uma aplicação pode começar no primeiro byte, avançar pelo fluxo ou, quando a interface e o tipo permitem, posicionar-se em outro deslocamento. O sistema de arquivos relaciona esse conteúdo a tamanho, proprietário, permissões, horários e outros atributos.
O sufixo depois de um ponto, como .txt ou .png, é uma convenção de nome útil para pessoas e programas. Ele não transforma por si só os bytes nem garante seu formato. Um sistema ou aplicativo pode considerar extensão, assinatura interna, metadados ou contexto para decidir como interpretar o conteúdo.
Também existem outros tipos de objeto. Em sistemas Unix-like, a mesma interface de nomes pode representar diretórios, links simbólicos, FIFOs, sockets e arquivos especiais de dispositivo. Isso não significa que todos aceitem as mesmas operações: tentar posicionar um fluxo de pipe, por exemplo, não equivale a buscar um deslocamento em arquivo regular.
É útil separar três ideias:
- nome: componente registrado em um diretório;
- objeto: identidade e metadados administrados pelo sistema de arquivos;
- conteúdo: bytes ou estrutura associados ao objeto.
Em Linux e em sistemas de arquivos como ext4, o inode representa a identidade e guarda metadados e referências ao conteúdo, enquanto a entrada de diretório relaciona um nome a um número de inode. Inode é um termo de implementação importante, mas não deve ser tratado como formato universal de todos os sistemas de arquivos.
Diretórios organizam nomes em uma hierarquia
Um diretório mantém entradas que associam nomes a objetos. Como diretórios podem conter nomes de outros diretórios, forma-se uma hierarquia navegável. No caminho /cursos/so/aula.md, a resolução começa na raiz, procura cursos, depois so e por fim aula.md.
Do ponto de vista lógico, essa estrutura nem sempre é uma árvore pura. Links físicos permitem que várias entradas apontem para o mesmo arquivo; o POSIX descreve a hierarquia como um grafo direcionado por esse motivo. Restrições sobre links físicos para diretórios evitam ciclos difíceis de administrar em implementações comuns.
Um diretório não é apenas uma decoração da interface gráfica. Criar, renomear ou remover um arquivo altera entradas nos diretórios envolvidos. Por isso, permissão de escrita no arquivo e permissão para modificar o diretório respondem a perguntas diferentes: uma controla mudanças no conteúdo; a outra participa do controle sobre os nomes daquela pasta.
Em ext4, uma entrada de diretório registra ao menos o número do inode, o tamanho do registro e o nome; formatos atuais também podem guardar uma indicação de tipo para tornar a travessia mais eficiente. Outros sistemas usam estruturas distintas, como árvores indexadas, tabelas ou registros próprios. O princípio duradouro é a associação entre nome e objeto.
Caminho é uma instrução de busca componente por componente
Um pathname, ou caminho, descreve como localizar uma entrada. Em POSIX, um caminho que começa com / é absoluto e parte da raiz do processo. Um caminho relativo parte do diretório atual apresentado no estudo sobre terminal e shell ou, em interfaces específicas, de um diretório representado por um descritor.
Os componentes têm significado no contexto do diretório anterior. O nome relatorio dentro de /equipe/a é uma entrada diferente de relatorio dentro de /equipe/b, mesmo que ambos contenham bytes iguais. Os componentes especiais . e .. representam, respectivamente, o diretório atual e uma referência ao contexto pai segundo as regras de resolução.
Durante a busca, o sistema precisa:
- escolher raiz, diretório atual ou diretório-base;
- analisar o próximo componente;
- verificar que o objeto corrente pode ser pesquisado como diretório;
- consultar cache ou implementação do sistema de arquivos;
- atravessar pontos de montagem e links simbólicos conforme as regras da operação;
- repetir até o componente final.
No Linux, o VFS mantém uma dentry cache, ou dcache, para acelerar a tradução de nomes em objetos. Uma dentry em memória relaciona nome, diretório pai e inode, inclusive podendo registrar temporariamente que determinado nome não existe. Cache não muda o contrato: ele evita repetir trabalho quando a informação continua válida.
Sistemas de arquivos remotos precisam considerar que outro computador pode alterar o namespace. Por isso, entradas em cache podem exigir revalidação. Latência de abertura não depende apenas do tamanho do arquivo: um caminho profundo, cache frio, permissões, links, rede e concorrência nos diretórios também influenciam a resolução.
Abrir separa a resolução do nome do uso posterior
Ao chamar uma operação como open(), o processo atravessa a interface de chamadas de sistema do kernel fornecendo um caminho e opções. O kernel resolve o nome, verifica condições e, se tiver sucesso, devolve um descritor de arquivo: um inteiro pequeno usado pelo processo em chamadas posteriores como read(), write() e close().
O descritor não é o arquivo nem o caminho. Ele indexa uma tabela do contexto mantido para o processo e conduz a uma descrição de arquivo aberta, que mantém estado como deslocamento atual e flags de status. Descritores obtidos por duplicação ou herdados em certas situações podem compartilhar essa descrição e, portanto, o deslocamento.
Depois da abertura, a aplicação não precisa resolver novamente o caminho para cada leitura. Isso também explica um comportamento importante em POSIX: se o último nome for removido enquanto o arquivo permanece aberto, o namespace deixa de encontrá-lo, mas o conteúdo pode continuar acessível pelos descritores existentes até que a última referência seja fechada.
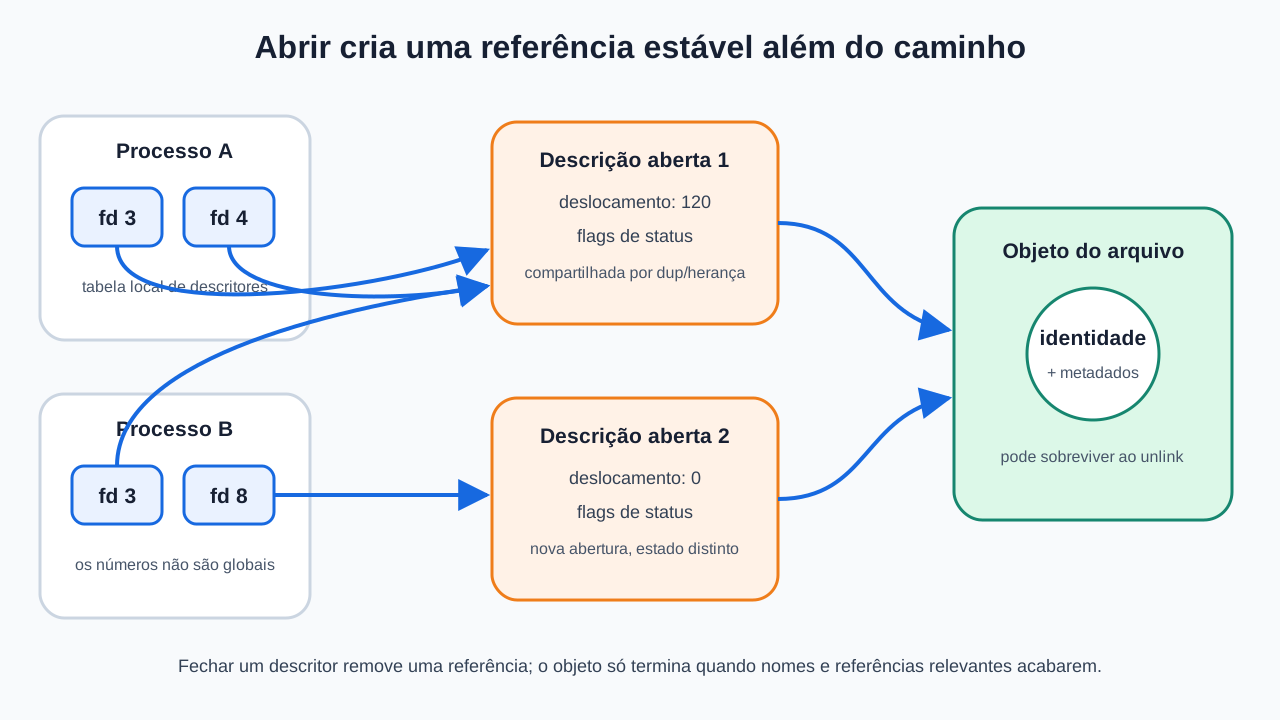
Esse modelo evita confusões frequentes. O descritor 3 de um processo não identifica necessariamente o mesmo recurso que o descritor 3 de outro. Renomear um caminho não muda automaticamente o identificador já aberto. E fechar um descritor libera aquela referência, não necessariamente o objeto, pois outras referências podem existir.
Metadados descrevem o objeto e seu uso
Metadados são dados sobre o objeto. O conjunto exato depende do sistema de arquivos e da interface, mas pode incluir:
- tipo do objeto;
- tamanho lógico e espaço alocado;
- proprietário e grupo;
- bits de permissão ou listas de controle de acesso;
- contagem de links físicos;
- identificador interno;
- horários de acesso, modificação de conteúdo e mudança de estado;
- atributos estendidos;
- flags específicas da implementação.
Em sistemas Unix-like, os nomes atime, mtime e ctime aparecem com frequência. mtime representa modificação dos dados; ctime, mudança no estado ou nos metadados do arquivo — não é “creation time”; atime registra acesso segundo a política configurada. Atualizações podem ser adiadas, agrupadas ou reduzidas para evitar custo, então não se deve inferir uma linha do tempo forense perfeita apenas desses campos.
Alguns sistemas expõem um horário de criação, chamado às vezes de birth time. Sua presença e semântica não são universais. Da mesma forma, tamanho lógico e espaço ocupado podem divergir por causa de arquivos esparsos, compressão, compartilhamento de blocos ou tamanho das unidades de alocação.
O comando stat consulta o estado do objeto resolvido; interfaces como lstat() permitem examinar o próprio link simbólico em vez do alvo. No Windows, atributos, horários, identidade e informações de links são expostos por outras APIs. O conceito é portátil, mas nomes de campos e garantias devem ser atribuídos à plataforma.
Link físico acrescenta outro nome ao mesmo arquivo
Um link físico, ou hard link, é outra entrada de diretório para o mesmo objeto de arquivo. Não existe necessariamente “original” e “atalho”: os nomes têm o mesmo status em relação à identidade compartilhada. Alterar o conteúdo por um deles é observado pelo outro porque não há duas cópias.
Em sistemas de arquivos Unix-like, as entradas compartilham o número de inode e a contagem de links aumenta. Em NTFS, links físicos também permitem que vários caminhos no mesmo volume representem o mesmo arquivo. Eles normalmente não atravessam sistemas de arquivos ou volumes porque a identidade referenciada pertence à estrutura local.
Remover um dos nomes decrementa a contagem, mas não apaga os dados enquanto restar outro link ou uma referência aberta relevante. Copiar um arquivo é diferente: a cópia cria outro objeto e alterações posteriores deixam de ser compartilhadas.
Link simbólico guarda um caminho para ser resolvido
Um link simbólico, ou symlink, é um objeto distinto cujo conteúdo representa um caminho. Quando uma operação o segue, a resolução incorpora esse caminho e continua até o alvo. Por isso, o link pode atravessar sistemas de arquivos e pode apontar para algo que ainda não existe ou deixou de existir — nesse caso, fica quebrado.
O caminho armazenado pode ser absoluto ou relativo. Um alvo relativo é interpretado em relação ao diretório que contém o link, não ao diretório atual de quem o acessa. Mover o link ou o alvo pode mudar o resultado; planejamento de estrutura importa.
Operações diferem quanto a seguir o link final. Abrir um link normalmente alcança o alvo; consultar com lstat() examina o link; remover o link remove o próprio objeto simbólico, não o alvo. Interfaces modernas oferecem flags e variantes baseadas em descritores para controlar resolução e reduzir condições de corrida em programas privilegiados.
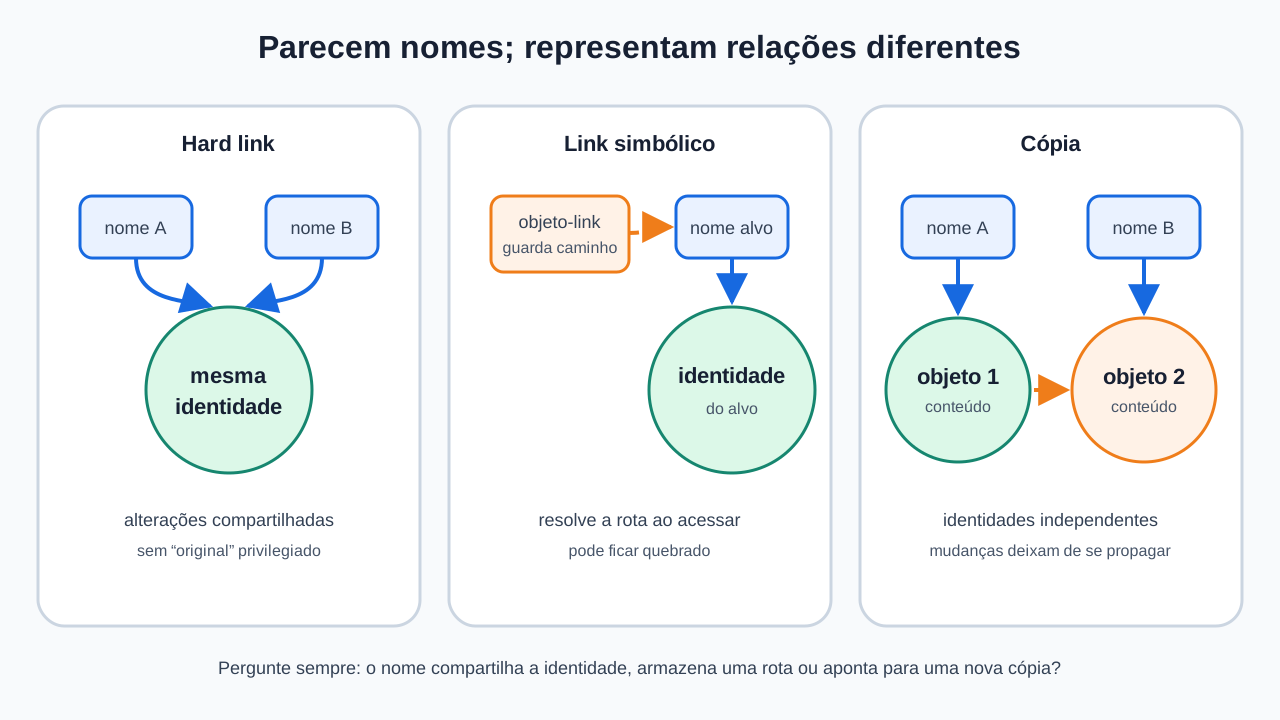
| Situação | Link físico | Link simbólico | Cópia |
|---|---|---|---|
| Identidade do objeto | a mesma | objeto-link distinto; alvo é resolvido por caminho | outra identidade |
| Conteúdo alterado no destino | visível por todos os hard links | visível ao seguir o link | não altera a cópia |
| Pode ficar quebrado | não enquanto a entrada existir e o sistema estiver íntegro | sim | não por mover o original |
| Cruza sistema de arquivos/volume | em geral, não | pode cruzar | pode, se houver espaço e ferramenta adequada |
| Remover o nome | reduz referências ao mesmo objeto | remove o link, não o alvo | remove a cópia |
No Windows existem ainda junctions e outros reparse points. Eles não devem ser usados como sinônimos universais de symlink. A documentação e a ferramenta empregada determinam se o objeto é um link físico, simbólico, junction ou outra forma de redirecionamento.
Criar, renomear e remover alteram o namespace
Criar um arquivo combina, conceitualmente, a alocação de uma identidade com a inclusão de um nome no diretório. mkdir() cria um diretório; link() acrescenta um link físico; symlink() cria um objeto que contém um caminho; unlink() remove uma entrada de nome.
Renomear também opera no namespace. Dentro das garantias e limites da mesma implementação, rename() troca a associação do nome de forma atômica para observadores: não deve existir um intervalo em que o novo nome apareça “pela metade”. Isso não transforma qualquer sequência de várias operações em uma transação nem garante persistência após queda de energia — assunto ligado a sincronização e journaling.
Também é perigoso implementar a sequência “verifique o caminho, depois abra” supondo que nada mudará entre as duas etapas. Outro processo pode renomear entradas ou substituir um componente por link. Interfaces como openat() permitem resolver caminhos relativos a um descritor de diretório, e flags de resolução ajudam programas sensíveis a declarar limites. A lição geral é operar sobre referências estáveis e usar operações atômicas oferecidas pelo sistema.
Observe nomes, identidades e links sem adivinhar
Em Linux, você pode criar uma demonstração isolada dentro de um diretório temporário:
demo_dir="$(mktemp -d)"
printf 'guia\n' > "$demo_dir/aula.txt"
ln "$demo_dir/aula.txt" "$demo_dir/aula-hard.txt"
ln -s "aula.txt" "$demo_dir/aula-simbolico.txt"

ls -li "$demo_dir"
stat "$demo_dir/aula.txt" "$demo_dir/aula-hard.txt"
readlink "$demo_dir/aula-simbolico.txt"
Os dois primeiros nomes devem exibir a mesma identidade de inode naquele sistema de arquivos e uma contagem de links coerente. readlink mostra o caminho armazenado pelo symlink. O resultado exato e a formatação variam conforme a ferramenta e o sistema.
Para encerrar sem usar remoção recursiva:
unlink "$demo_dir/aula-simbolico.txt"
unlink "$demo_dir/aula-hard.txt"
unlink "$demo_dir/aula.txt"
rmdir "$demo_dir"
No PowerShell, uma observação sem alterações pode começar por:
Get-Item -LiteralPath .\arquivo-exemplo.txt |
  Format-List FullName, Length, Attributes, CreationTime, LastWriteTime, LinkType, Target
Nem todos os campos estarão preenchidos em todos os sistemas de arquivos. Para NTFS, fsutil hardlink list <arquivo> lista nomes físicos associados, conforme permissões e versão da plataforma. Use caminhos de laboratório e confirme o tipo antes de criar ou remover links.
Erros comuns
- “O nome fica dentro do arquivo.” Em modelos comuns, a entrada de diretório associa o nome à identidade; os metadados pertencem ao objeto.
- “Inode existe em todo sistema de arquivos.” É uma abstração central em Unix/Linux, não um formato universal.
- “Extensão define o conteúdo.” Ela é uma convenção; não valida nem converte os bytes.
- “Diretório é apenas uma pasta visual.” Ele participa da resolução e mantém associações de nomes.
- “Caminho identifica o objeto para sempre.” Renomeações, montagens e links podem mudar a resolução.
- “Descritor é um caminho.” Ele é um índice local do processo para uma abertura mantida pelo kernel.
- “O descritor 3 é global.” O mesmo número pode representar recursos diferentes em processos diferentes.
- “
ctimeé a criação.” Em POSIX, relaciona-se à mudança de estado do arquivo. - “Hard link é um atalho para o original.” Ambos os nomes referenciam a mesma identidade.
- “Hard link duplica os dados.” Não; uma cópia cria um objeto separado.
- “Symlink guarda o arquivo.” Ele guarda um caminho e pode ficar quebrado.
- “Remover um symlink remove o alvo.” A remoção normal atua sobre o próprio link.
- “Apagar um nome sempre libera os blocos imediatamente.” Outros links e descritores abertos podem manter o objeto acessível.
- “Renomear e copiar são equivalentes.” Renomear altera o namespace; copiar cria conteúdo em outro objeto.
- “Permissão no arquivo basta para apagar seu nome.” A modificação do diretório também é relevante.
O que você deve guardar
O sistema de arquivos oferece objetos nomeados sobre mecanismos de armazenamento. Diretórios associam nomes a identidades; caminhos descrevem uma busca componente por componente; metadados descrevem tipo, tamanho, propriedade, permissões, horários e outras características.
Abrir resolve um caminho e devolve um descritor local ao processo. O uso posterior pode continuar mesmo que o nome seja alterado ou removido, enquanto houver referências abertas. Essa separação entre namespace e objeto é essencial para entender comportamento correto e diagnosticar arquivos “apagados” que ainda ocupam espaço.
Hard links são nomes equivalentes para o mesmo objeto. Links simbólicos são objetos que armazenam caminhos. Cópias são independentes. Distinguir os três evita perda de dados, automações frágeis e interpretações erradas de tamanho ou identidade.
Na próxima aula, veremos como discos, partições, volumes, pontos de montagem e journaling sustentam essa organização.
Referências
- The Open Group — POSIX.1-2024: General Concepts. Acesso em 5 set. 2026.
- The Open Group — POSIX.1-2024:
open. Acesso em 5 set. 2026. - The Open Group — POSIX.1-2024:
stat. Acesso em 5 set. 2026. - The Open Group — POSIX.1-2024:
link. Acesso em 5 set. 2026. - The Open Group — POSIX.1-2024:
symlink. Acesso em 5 set. 2026. - The Open Group — POSIX.1-2024:
unlink. Acesso em 5 set. 2026. - The Open Group — POSIX.1-2024:
rename. Acesso em 5 set. 2026. - Linux Kernel Documentation — Overview of the Linux Virtual File System. Acesso em 5 set. 2026.
- Linux Kernel Documentation — Pathname lookup. Acesso em 5 set. 2026.
- Linux Kernel Documentation — ext4 Directory Entries. Acesso em 5 set. 2026.
- Linux Kernel Documentation — ext4 Index Nodes. Acesso em 5 set. 2026.
- Microsoft Learn — Hard Links and Junctions. Acesso em 5 set. 2026.
- Microsoft Learn —
fsutil hardlink. Acesso em 5 set. 2026. - Microsoft Learn — Symbolic Link Effects on File Systems Functions. Acesso em 5 set. 2026.