
Discos, partições, volumes, montagem e journaling
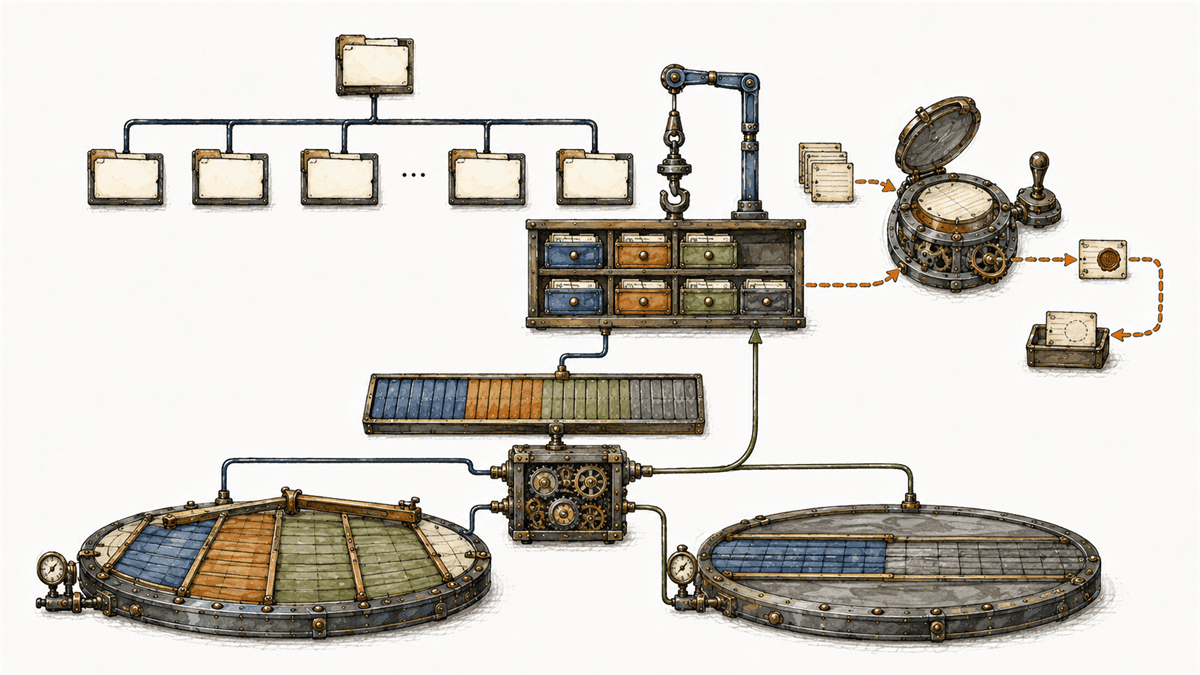
Do dispositivo ao caminho existem várias camadas
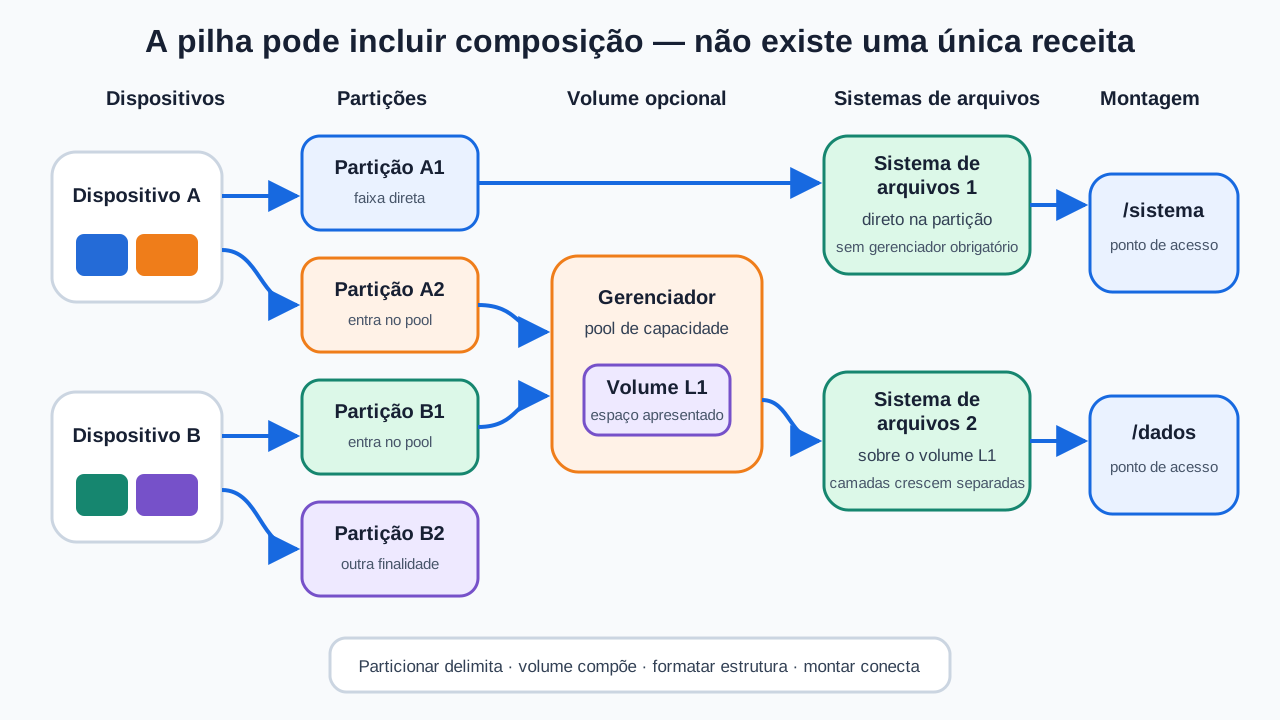
Salvar um arquivo parece uma única ação, mas o sistema atravessa camadas diferentes. O dispositivo oferece capacidade endereçável; uma tabela pode dividir essa capacidade em partições; um gerenciador pode compor volumes lógicos; um sistema de arquivos organiza objetos; e a montagem conecta essa organização ao namespace visto pelos processos.
Essas camadas não formam uma receita obrigatoriamente idêntica. Um sistema de arquivos pode ocupar uma partição, um dispositivo inteiro, um volume construído sobre vários dispositivos ou outro recurso apresentado como armazenamento em blocos. Entender as fronteiras evita comandos no alvo errado e diagnósticos baseados apenas no nome exibido pela interface.
A aula anterior explicou como sistemas de arquivos organizam nomes, objetos, metadados e links. Agora veremos onde essa organização reside, como passa a integrar uma hierarquia e como mecanismos de consistência ajudam após uma interrupção inesperada.
Disco, SSD e dispositivo de bloco não são sinônimos perfeitos
Disco é usado informalmente para diferentes meios de armazenamento. Um HDD magnético possui pratos e partes mecânicas; um SSD usa memória não volátil e controladores; dispositivos virtuais, arranjos, unidades USB e volumes remotos podem aparecer ao sistema por interfaces semelhantes sem serem discos físicos.
No modelo de dispositivo de bloco, o sistema acessa unidades numeradas por endereços lógicos. Um LBA identifica um bloco lógico exposto pela interface. O tamanho lógico usado pelos comandos pode diferir da granularidade física interna e da unidade de apagamento ou programação do meio. Controladores também podem remapear posições, manter cache e executar nivelamento de desgaste.
Portanto, o número de um LBA não informa diretamente prato, célula ou posição física. Ele faz parte do contrato entre sistema e dispositivo. A camada de E/S estudada anteriormente transforma operações em requisições adequadas a esse contrato.
Alinhamento continua relevante. Se estruturas maiores começam em limites incompatíveis com blocos físicos, páginas ou faixas de um arranjo, uma gravação lógica pode exigir trabalho físico adicional. Ferramentas modernas costumam escolher alinhamentos apropriados, mas imagens antigas, clonagens e configurações manuais merecem verificação.
Partição delimita uma faixa do dispositivo
Uma partição descreve uma região, normalmente contígua em LBAs, dentro de um dispositivo. A tabela de partições registra início, fim, tipo e outros atributos. Criar uma partição não cria automaticamente arquivos nem diretórios: apenas reserva e identifica uma faixa para determinada finalidade.
Os dois estilos conhecidos em computadores pessoais são:
- MBR: formato legado com registros de partição no primeiro setor lógico e limitações históricas de endereçamento e quantidade de entradas primárias;
- GPT: formato definido pela especificação UEFI, com endereços de 64 bits, identificadores GUID, checksums e tabelas principal e de backup.
No GPT, o LBA inicial contém um MBR protetor para reduzir interpretações destrutivas por ferramentas antigas. O cabeçalho principal e seu array de entradas ficam no início; cópias de segurança das estruturas GPT ficam no final. Essa redundância protege a descrição das partições, não os arquivos guardados dentro delas.
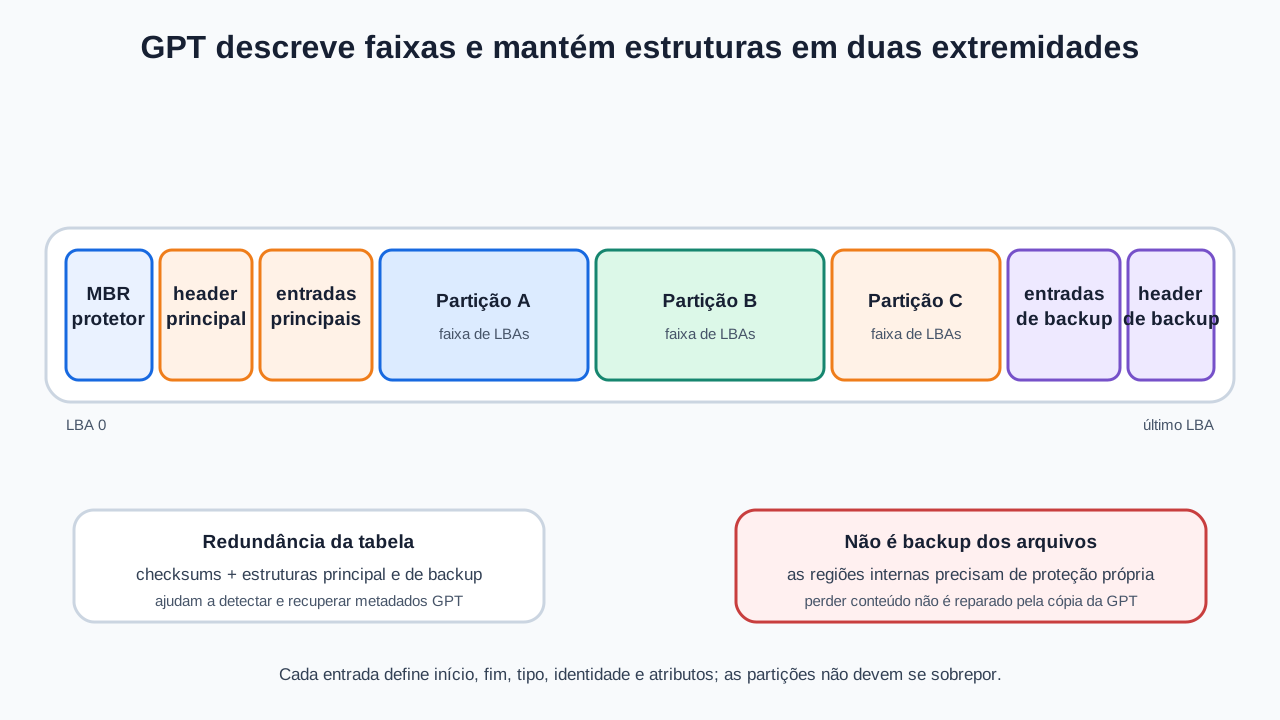
Tipo de partição, sistema de arquivos detectado e finalidade não são a mesma coisa. A entrada GPT pode indicar uma categoria; os bytes da região podem conter um sistema de arquivos, swap, dados criptografados, metadados de um gerenciador de volumes ou nada reconhecível. Detectar uma assinatura não autoriza alterar o conteúdo.
Particionar, redimensionar ou reescrever uma tabela modifica estruturas críticas. Antes de qualquer ação, é necessário confirmar dispositivo por identidade, capacidade, modelo, relações de dependência e backups válidos. Nomes como /dev/sdb podem mudar entre inicializações; “Disco 1” pode mudar após conectar outro hardware.
Volume lógico separa capacidade apresentada da geometria física
Uma partição pode ser usada diretamente, mas uma camada de gerenciamento de volumes acrescenta flexibilidade. Ela recebe uma ou mais regiões físicas, divide capacidade em unidades próprias e apresenta volumes lógicos aos níveis superiores.
Essa composição permite, conforme a tecnologia:
- reunir espaço de vários dispositivos;
- criar volumes com tamanhos administráveis;
- ampliar ou reduzir certas camadas sob condições específicas;
- implementar espelhamento, distribuição ou paridade;
- criar snapshots;
- inserir criptografia ou provisionamento fino.
Os recursos não são universais nem gratuitos. Um volume distribuído pode aumentar desempenho ou capacidade, mas também ampliar o impacto da perda de um componente. Espelhamento não corrige exclusão acidental propagada às réplicas. Snapshot não é automaticamente um backup independente. Criptografia exige gestão de chaves. Provisionamento fino exige monitorar o espaço físico real.
Também é importante separar volume lógico de sistema de arquivos. Aumentar o volume não garante que o sistema de arquivos passe a usar o novo espaço; reduzir a camada inferior antes da superior pode destruir dados. Cada tecnologia define ordem, suporte e condições próprias.
Formatar cria as estruturas do sistema de arquivos
Formatar, neste contexto, inicializa uma região com as estruturas esperadas por um sistema de arquivos. Isso pode incluir superbloco ou registros equivalentes, mapas de alocação, diretório raiz, áreas de metadados e, quando aplicável, journal.
Formatar não é montar. A formatação prepara a organização persistente; a montagem torna uma instância acessível em um namespace. Também não é uma simples “limpeza”: criar um novo sistema de arquivos sobrescreve metadados essenciais e pode tornar dados anteriores inacessíveis, ainda que alguns bytes permaneçam fisicamente até serem reutilizados.
Cada sistema de arquivos possui capacidades e limites: tamanhos, nomes, permissões, links, atributos, checksums, compressão, snapshots, comportamento em falhas e compatibilidade. Não existe escolha universalmente melhor. A decisão depende de sistema operacional, carga, portabilidade, ferramentas de recuperação e requisitos de integridade.
Montar conecta uma raiz de sistema de arquivos ao namespace
Em sistemas Unix-like, montar associa a raiz de um sistema de arquivos a um ponto da hierarquia. Se um volume é montado em /dados, atravessar esse caminho passa a mostrar o diretório raiz daquele sistema de arquivos. Os arquivos não foram copiados para /dados; a resolução mudou de uma estrutura para outra naquele ponto.
Se o diretório usado como ponto de montagem já continha nomes, eles ficam encobertos enquanto a montagem estiver ativa e reaparecem depois da desmontagem. Isso explica incidentes em que “arquivos sumiram” após montar ou “voltaram” após desmontar. Gravar no diretório antes de a montagem esperada ocorrer também pode consumir espaço no sistema de arquivos subjacente.
O Windows costuma expor volumes por letras como C:\, mas também permite montá-los em pastas e identificá-los por caminhos de GUID. Letra de unidade é um ponto de acesso, não a identidade física do dispositivo.
Uma montagem reúne pelo menos:
- origem: dispositivo, volume, compartilhamento ou outra instância;
- alvo: ponto no namespace;
- tipo: implementação que interpreta os dados;
- opções: leitura, escrita e comportamentos específicos;
- visão: conjunto de montagens disponível ao processo.
No Linux, namespaces de montagem permitem que grupos de processos vejam árvores diferentes. Um contêiner pode observar outra composição sem que os bytes tenham sido duplicados. Logo, perguntar “onde está montado?” exige considerar em qual namespace e processo a observação ocorre.
Identificadores estáveis evitam depender da ordem de descoberta
Sistemas podem identificar dispositivos e sistemas de arquivos por nomes transitórios, rótulos, UUIDs, GUIDs de partição e caminhos derivados de hardware. Cada identificador responde a uma camada.
O nome /dev/sda2, por exemplo, expressa uma descoberta e uma partição segundo convenções do Linux, mas pode não permanecer ligado ao mesmo hardware em todas as situações. Um UUID de sistema de arquivos identifica aquela instância formatada; PARTUUID identifica a entrada de partição; um identificador de volume pertence à tecnologia que o criou.
Clonar byte a byte também clona alguns identificadores internos. Conectar simultaneamente original e clone pode criar ambiguidade. A especificação GPT determina que software de cópia consciente do formato gere novos GUIDs; ferramentas de clonagem bruta, porém, podem reproduzir exatamente a tabela. Identidade deve ser verificada, não presumida.
Cache acelera gravações, mas conclusão não significa persistência imediata
Aplicações escrevem por interfaces do sistema operacional. Frequentemente, os dados passam primeiro pelo page cache e são marcados como sujos. O kernel pode agrupar e ordenar gravações antes de enviá-las à camada de blocos. Controladores e dispositivos ainda podem manter caches próprios.
O retorno de write() normalmente informa que os bytes foram aceitos pela camada responsável, não que atravessaram todas as caches e estão persistidos em mídia não volátil. Interfaces como fsync() solicitam sincronização dos dados e metadados necessários daquela abertura segundo o contrato da plataforma. Mesmo assim, a garantia final depende de drivers, dispositivos, barreiras, energia e implementação corretos.
Durabilidade de uma substituição de arquivo costuma exigir pensar tanto no conteúdo quanto na entrada do diretório. Um padrão frequente é gravar um arquivo temporário no mesmo sistema de arquivos, sincronizá-lo, renomeá-lo atomicamente e sincronizar o diretório conforme a plataforma. Copiar esse padrão sem compreender erros, permissões e garantias ainda pode produzir falhas.
Journaling registra atualizações antes de consolidá-las
Alterar um arquivo pode exigir várias gravações relacionadas: alocação de blocos, tamanho, entrada de diretório e mapas de espaço livre. Se faltar energia no meio, parte pode refletir o estado novo e parte o antigo. Journaling reduz esse risco ao agrupar mudanças relevantes em transações e registrá-las em uma área de log antes ou durante a instalação nas posições finais.
Um fluxo simplificado é:
- preparar a transação e as mudanças protegidas;
- registrar no journal descrições e blocos necessários;
- persistir um registro de commit quando a transação está completa;
- aplicar ou consolidar as mudanças nas posições finais;
- liberar espaço antigo do journal depois do checkpoint;
- após falha, reproduzir transações comprometidas e ignorar as incompletas.
No ext4, o JBD2 protege o sistema contra inconsistências de metadados após crash. No modo padrão data=ordered, metadados passam pelo journal e dados associados são ordenados antes do commit pertinente; data=journal registra também dados; data=writeback oferece outra ordenação. Essas são políticas do ext4, não definições universais de journaling.
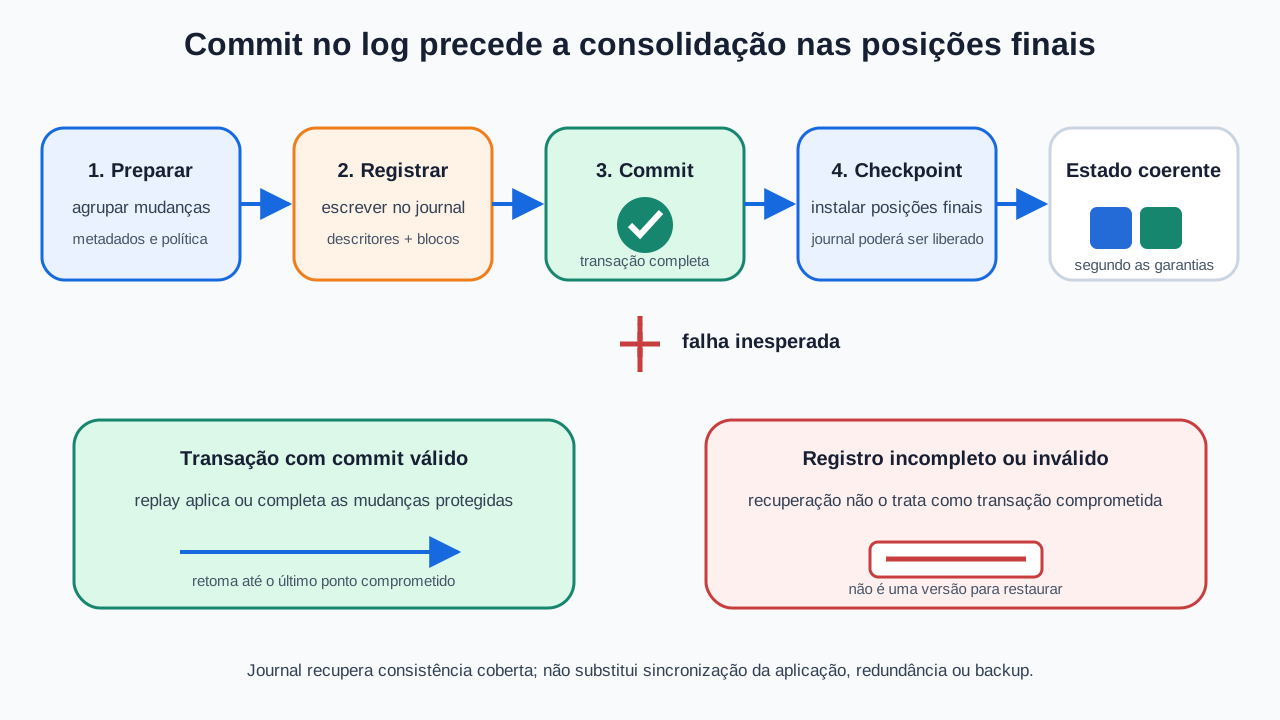
Journaling não garante que toda gravação de aplicação sobreviverá, não recupera uma versão apagada por engano e não protege contra falha física, corrupção propagada ou ransomware. Ele também não transforma várias operações de negócio em uma transação de banco de dados. Seu objetivo principal é acelerar e tornar previsível a recuperação de consistência coberta pelo journal.
Outros sistemas usam copy-on-write, logs, árvores com checksums ou combinações diferentes. Mesmo sistemas com journal podem executar verificação adicional se detectarem corrupção, falha de hardware ou estado que o log não consegue resolver.
Integridade, consistência e disponibilidade são perguntas diferentes
- Consistência estrutural: metadados formam uma organização válida depois da recuperação?
- Durabilidade: quais alterações confirmadas pela aplicação realmente sobreviveram?
- Integridade: os bytes correspondem ao que deveria estar armazenado?
- Disponibilidade: o sistema consegue acessar os dados no prazo necessário?
- Recuperabilidade: existe cópia independente e testada para restaurar perdas?
Journal ajuda principalmente na primeira pergunta e, conforme o modo e a sincronização, participa da segunda. Checksums ajudam a detectar algumas corrupções, mas detecção não implica correção. RAID pode manter serviço diante de certas falhas, mas não conserva histórico. Backup acrescenta uma cópia recuperável com outra política de retenção e falha.
Observe a pilha sem modificar o armazenamento
No Linux, comece por comandos somente de leitura:
lsblk -o NAME,TYPE,SIZE,FSTYPE,FSVER,LABEL,UUID,MOUNTPOINTS
findmnt
df -hT
cat /proc/self/mountinfo
lsblk mostra relações entre dispositivos de bloco; findmnt consulta montagens; df relata capacidade segundo os sistemas de arquivos montados; /proc/self/mountinfo revela a visão do processo atual. Saídas dependem de versão, permissões, namespaces e tecnologias presentes.
No PowerShell, uma inspeção inicial pode usar:
Get-Disk | Select-Object Number, FriendlyName, PartitionStyle, OperationalStatus, Size
Get-Partition | Select-Object DiskNumber, PartitionNumber, DriveLetter, Type, Size
Get-Volume | Select-Object DriveLetter, FileSystem, FileSystemLabel, HealthStatus, Size, SizeRemaining
Essas visões representam camadas diferentes; não una linhas apenas pela posição em que aparecem. Relacione disco, partição e volume por propriedades explícitas. Não inicialize, formate, converta, redimensione ou repare durante uma etapa de inventário.
Uma sequência segura de diagnóstico é:
- confirmar o sintoma e o namespace afetado;
- identificar ponto de acesso ou montagem;
- resolver o sistema de arquivos e a origem;
- seguir dependências por volume, criptografia, arranjo e partição;
- confirmar o dispositivo físico ou virtual;
- verificar capacidade, estado, logs e erros sem alterar nada;
- planejar backup, janela e reversão antes de qualquer correção.
Erros comuns
- “Disco e dispositivo de bloco são a mesma coisa.” O segundo é uma interface e pode representar hardware, composição ou recurso virtual.
- “Particionar cria um sistema de arquivos.” Partição delimita uma faixa; formatação cria estruturas de sistema de arquivos.
- “Volume é sempre uma partição.” Pode coincidir com ela ou resultar de outras camadas.
- “Aumentar o volume aumenta automaticamente o sistema de arquivos.” As camadas podem exigir operações separadas e ordenadas.
- “Formatar apenas apaga a lista de arquivos.” A operação cria metadados novos e pode destruir o acesso ao conteúdo anterior.
- “Montar copia os arquivos para uma pasta.” Montagem conecta uma raiz existente ao namespace.
- “Arquivos desapareceram porque montei o volume.” Conteúdo anterior do ponto pode apenas estar encoberto.
- “Letra de unidade identifica o disco.” Ela é um ponto de acesso a um volume.
- “
/dev/sdbsempre é o mesmo hardware.” A ordem de descoberta pode mudar. - “GPT de backup é backup dos arquivos.” Ela replica estruturas da tabela de partições.
- “
write()retornou, então está fisicamente persistido.” Caches e writeback podem permanecer no caminho. - “Journal guarda versões antigas.” Ele registra transações para consistência; não é histórico de arquivos.
- “Journaling dispensa backup.” Não protege contra exclusão, corrupção lógica ou perda de todos os dispositivos.
- “RAID é backup.” Redundância operacional e cópia recuperável têm objetivos diferentes.
- “Snapshot é sempre independente.” Muitos snapshots dependem dos mesmos metadados, chaves ou dispositivos.
- “
dfe soma dos arquivos devem ser idênticos.” Arquivos abertos removidos, reservas, snapshots e metadados podem explicar diferenças.
O que você deve guardar
Dispositivo, partição, volume, sistema de arquivos e ponto de montagem são camadas distintas. A tabela de partições delimita regiões; um gerenciador de volumes pode reorganizar capacidade; a formatação cria estruturas; a montagem conecta uma raiz ao namespace.
O caminho da gravação inclui caches e ordenação. Retorno da chamada, commit de journal, checkpoint e persistência física não são o mesmo evento. Aplicações que precisam de durabilidade devem usar as interfaces corretas e tratar falhas em cada etapa.
Journaling ajuda a recuperar consistência após interrupção, mas não substitui backup, redundância, checksums nem projeto transacional da aplicação. Diagnóstico seguro começa pela observação das relações e só depois considera mudanças.
Na próxima aula, iniciaremos o módulo de proteção e operação entendendo usuários, grupos, permissões, ACLs e menor privilégio.
Referências
- UEFI Forum — UEFI Specification 2.11. Acesso em 5 set. 2026.
- UEFI Forum — GUID Partition Table Disk Layout. Acesso em 5 set. 2026.
- Linux Kernel Documentation — ext4 High Level Design. Acesso em 5 set. 2026.
- Linux Kernel Documentation — ext4 Journal. Acesso em 5 set. 2026.
- Linux Kernel Documentation — The Linux Journalling API. Acesso em 5 set. 2026.
- Linux man-pages —
mount_namespaces(7). Acesso em 5 set. 2026. - util-linux —
findmnt(8). Acesso em 5 set. 2026. - util-linux —
blkid(8). Acesso em 5 set. 2026. - The Open Group — POSIX.1-2024:
fsync. Acesso em 5 set. 2026. - Microsoft Learn — Local File Systems. Acesso em 5 set. 2026.
- Microsoft Learn — Overview of Disk Management. Acesso em 5 set. 2026.
- Microsoft Learn — Initialize New Disks. Acesso em 5 set. 2026.
- Microsoft Learn — Naming a Volume. Acesso em 5 set. 2026.