
Entrada e saída, interrupções, DMA, buffers e drivers
Entrada e saída transforma pedidos em operações de dispositivo
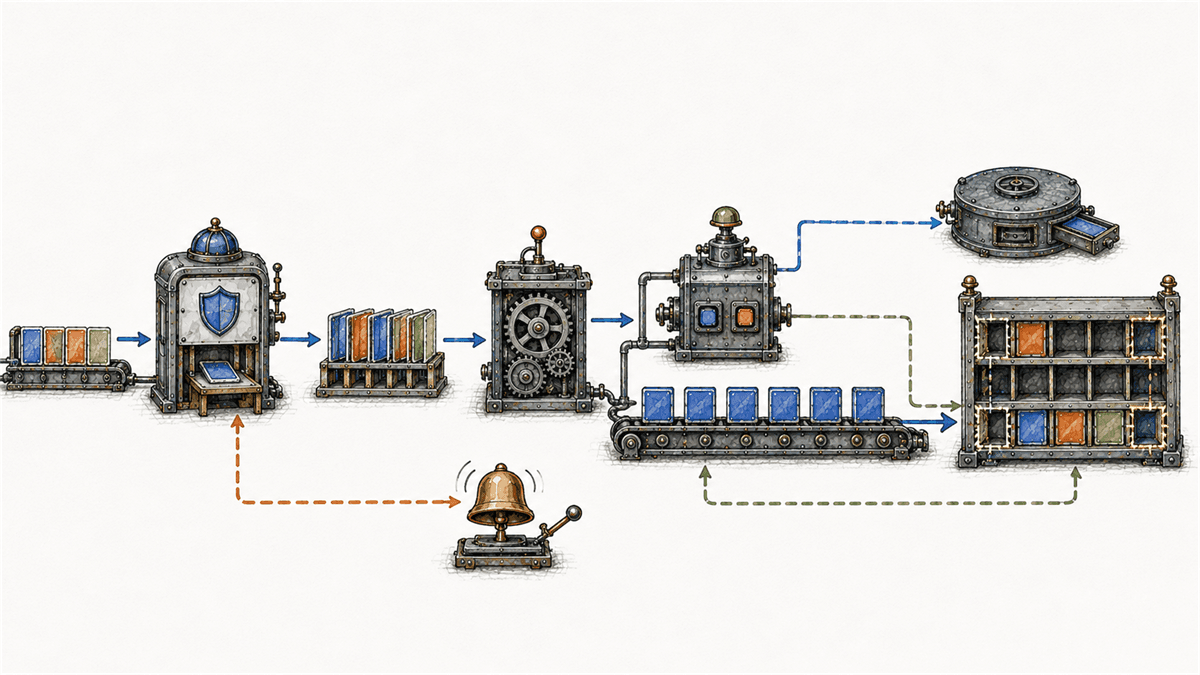
Uma aplicação não precisa conhecer registradores de uma controladora de armazenamento, o formato das filas de uma placa de rede nem o protocolo elétrico de um teclado. Ela solicita uma operação por uma interface do sistema operacional; o kernel valida o pedido, localiza o recurso, coordena memória e execução e encaminha trabalho ao driver responsável pelo dispositivo.
Chamamos de entrada e saída, ou E/S, a comunicação entre o sistema computacional e recursos externos ao fluxo normal de instruções da CPU: armazenamento, rede, teclado, tela, sensores, aceleradores e muitos outros. Entrada leva dados ou eventos ao sistema; saída envia dados ou comandos. Um mesmo dispositivo pode realizar ambas.
A aula anterior mostrou como paginação e memória virtual administram páginas e quadros. Agora conectaremos essa memória aos dispositivos. Sistemas de arquivos, diretórios e volumes terão páginas próprias; aqui o foco é o caminho mecânico da E/S.
Aplicação, subsistema, driver, controlador e dispositivo têm papéis diferentes
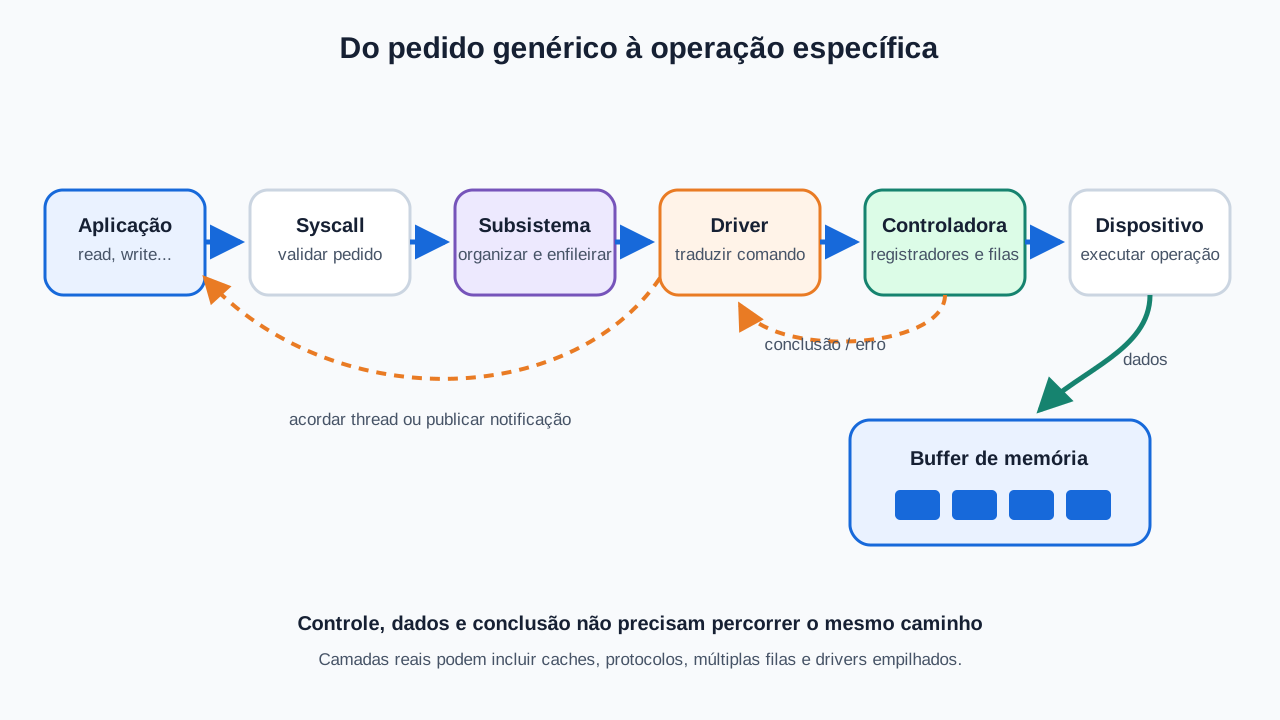
Considere o serviço da plataforma de estudos lendo um bloco de dados. Uma visão simplificada do percurso é:
- a aplicação chama uma interface como
read()sobre um descritor; - a chamada de sistema entra no kernel e valida identificador, buffer, tamanho e permissões;
- o subsistema apropriado organiza o pedido segundo o tipo de recurso;
- o driver traduz o pedido para comandos compreendidos pelo controlador;
- o controlador conversa com o dispositivo e movimenta os dados;
- a conclusão retorna ao kernel;
- a thread é acordada ou uma notificação assíncrona fica disponível;
- a aplicação recebe quantidade transferida ou erro.
Essas camadas podem incluir caches, sistemas de arquivos, protocolos, filas e outros drivers. Uma operação lógica também pode virar várias operações físicas, ser combinada com pedidos vizinhos ou ser atendida sem tocar o dispositivo porque o dado já estava em memória.
O controlador é hardware ou firmware que expõe registradores, filas e capacidades ao sistema. O driver é software que conhece esse contrato. O dispositivo é o recurso final — embora, na prática, controladora e dispositivo possam estar no mesmo componente.
Registradores permitem comandar e observar o dispositivo
Para iniciar uma operação, o driver costuma escrever parâmetros em registradores ou descritores: direção, posição, tamanho, endereço do buffer e comando. Depois consulta estado, recebe um evento ou examina uma fila de conclusão.
Há duas formas históricas de acessar registradores:
- E/S mapeada em memória (MMIO): uma faixa do espaço de endereços representa registradores do dispositivo;
- port-mapped I/O: instruções e espaço de portas específicos, disponíveis em algumas arquiteturas.
Um endereço MMIO não representa RAM comum. Leituras e escritas podem produzir efeitos no hardware, e a ordem observada importa. Drivers usam primitivas da plataforma para mapear e acessar essas regiões; um ponteiro de aplicação ou uma leitura comum de memória não substitui essas interfaces.
Descoberta, associação e energia também pertencem à integração. Barramentos como PCI e USB descrevem identidades e recursos; o modelo de dispositivos associa uma instância compatível ao driver, acompanha conexão e remoção e coordena suspensão e retomada.
Polling consulta o estado repetidamente
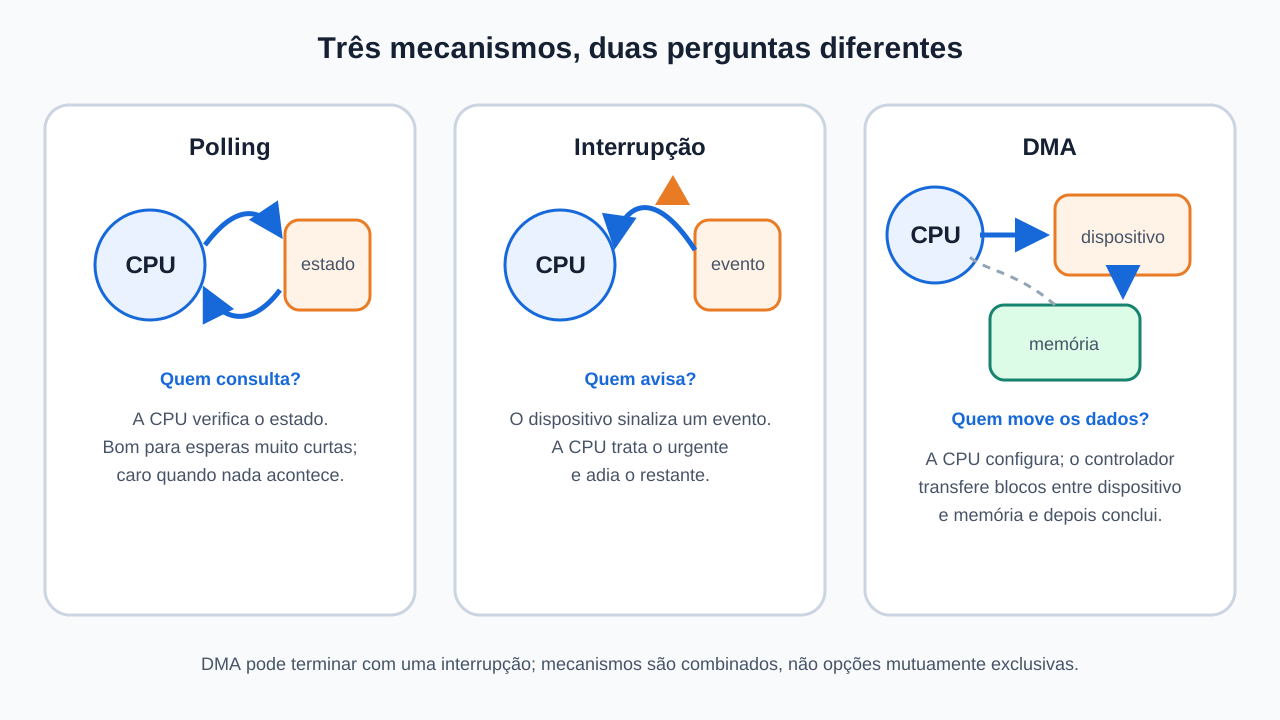
No polling, a CPU pergunta ao controlador se a operação terminou ou se existe trabalho disponível. O modelo é direto:
iniciar operação
enquanto não estiver pronta
    consultar estado
processar resultado
Polling pode ser adequado quando o evento chegará em pouquíssimo tempo, quando a latência precisa ser muito previsível ou quando o custo de uma interrupção superaria poucas consultas. Drivers de alta vazão também podem alternar entre interrupções e polling sob carga.
O custo aparece quando a espera é longa ou rara: ciclos são gastos confirmando repetidamente que nada mudou. Inserir pausas reduz consumo, mas aumenta o tempo até perceber a conclusão. Polling não é automaticamente ruim; é uma troca entre latência, uso de CPU e taxa esperada de eventos.
Não confunda polling do hardware com APIs de aplicação chamadas poll, select ou mecanismos semelhantes. Essas interfaces permitem que uma thread espere até descritores estarem prontos; internamente, o kernel pode usar interrupções, filas e outros mecanismos em vez de fazer a aplicação consultar registradores continuamente.
Interrupção permite que o dispositivo sinalize um evento
Uma interrupção de hardware avisa ao processador que um evento requer tratamento. Enquanto o dispositivo trabalha, a CPU pode executar outra tarefa. Quando a controladora sinaliza conclusão, dado disponível ou erro, o controlador de interrupções direciona o evento a uma CPU e o kernel identifica o tratador registrado.
Um fluxo geral é:
- preservar o contexto mínimo necessário;
- identificar a fonte e reconhecer ou mascarar o evento conforme o hardware;
- registrar estado indispensável;
- agendar trabalho que pode esperar;
- retornar da interrupção;
- concluir o processamento em contexto apropriado;
- acordar consumidores ou completar pedidos.
O tratador imediato precisa ser curto porque executa em contexto restrito e pode atrasar eventos do sistema. Linux oferece tratadores encadeados em thread; Windows usa rotinas de serviço de interrupção e normalmente transfere trabalho adicional a DPCs. Os nomes variam, mas o princípio é separar resposta urgente de processamento adiável.
Interrupção não carrega o bloco de dados. Ela comunica um evento. Os bytes podem ter sido movidos pela CPU, por DMA ou permanecer em um buffer do controlador. Também não existe obrigatoriamente uma interrupção por pedido: controladoras modernas agrupam conclusões, usam múltiplas filas e podem sinalizar por mensagens como MSI/MSI-X.
Interrupções em excesso também custam. Coalescência ou moderação permite agrupar vários eventos antes de notificar a CPU, melhorando vazão e reduzindo overhead, mas acrescentando latência. O equilíbrio depende da carga: áudio interativo, rede de alta taxa e armazenamento em lote possuem necessidades diferentes.
DMA move dados sem a CPU copiar cada unidade
No Direct Memory Access, um controlador ou dispositivo transfere dados entre o dispositivo e a memória sem fazer a CPU executar uma instrução de cópia para cada palavra. A CPU ainda participa: o driver prepara buffers e descritores, configura direção e tamanho, publica o trabalho e trata conclusão e erros.
Uma leitura com DMA pode seguir assim:
- o kernel obtém um buffer apropriado;
- a camada de DMA cria um endereço acessível pelo dispositivo;
- o driver entrega endereço, tamanho e direção ao controlador;
- o dispositivo grava os dados na memória;
- uma interrupção ou consulta indica conclusão;
- o driver sincroniza o estado necessário e libera ou reutiliza o mapeamento;
- o consumidor recebe os bytes válidos.
DMA não significa acesso irrestrito a qualquer endereço. CPU, kernel e dispositivo podem enxergar espaços de endereços diferentes. A API de DMA da plataforma cria os mapeamentos corretos e pode usar uma IOMMU para traduzir e limitar os endereços acessíveis ao periférico.
Ignorar essa camada é perigoso: um endereço virtual da CPU não é automaticamente um endereço válido para o dispositivo. O buffer pode ocupar páginas físicas dispersas, o hardware pode aceitar apenas determinada largura de endereço e a memória precisa permanecer estável durante a operação.
Scatter-gather descreve um buffer fisicamente disperso
Uma aplicação vê um buffer virtual contínuo, mas suas páginas podem ocupar quadros físicos separados. Um dispositivo com scatter-gather DMA recebe uma lista de segmentos e transfere todos sem exigir uma cópia prévia para um grande bloco fisicamente contínuo.
Cada descritor informa um endereço de DMA e um comprimento. O controlador percorre a lista, enquanto o driver mantém limites, direção, propriedade e duração do mapeamento. Há limites reais: número máximo de segmentos, alinhamento, tamanho por descritor e fronteiras que o hardware não atravessa.
Se o dispositivo não alcança determinadas regiões ou não suporta a dispersão necessária, a plataforma pode usar um bounce buffer: copia os dados para uma área intermediária compatível, realiza a transferência e, em uma leitura, copia o resultado de volta. Funciona, mas reduz o benefício de evitar cópias.
“Zero-copy” também é um objetivo relativo. Uma rota pode eliminar uma cópia entre dois buffers de software e ainda executar DMA, mapear páginas, atualizar descritores ou copiar em outra camada. A afirmação precisa dizer qual cópia foi removida e entre quais participantes.
Coerência de cache e propriedade do buffer precisam ser explícitas
CPU e dispositivo podem acessar a mesma região por caminhos diferentes. Em plataformas coerentes, hardware mantém visibilidade consistente para determinadas operações. Em outras, o driver precisa sincronizar caches e respeitar as APIs de mapeamento antes de mudar quem possui o buffer.
Um protocolo conceitual seguro é:
CPU prepara dados
driver entrega o buffer ao dispositivo
CPU deixa de alterar a região
dispositivo transfere
driver recebe a conclusão e sincroniza
CPU volta a acessar o conteúdo
Se a CPU modifica um buffer de transmissão depois de entregá-lo, o dispositivo pode observar dados misturados. Se a CPU lê um buffer de recepção antes da sincronização, pode enxergar conteúdo antigo. Barreiras de memória e operações de DMA têm papéis específicos; adicionar volatile não resolve coerência nem ordenação entre hardware, caches e CPUs.
IOMMU também melhora isolamento ao restringir o mapa entregue ao dispositivo. Isso reduz a superfície de erros e ataques DMA, mas depende de hardware, firmware, configuração e drivers compatíveis. Não transforma um driver defeituoso em componente seguro.
Buffers absorvem diferenças de ritmo e formato
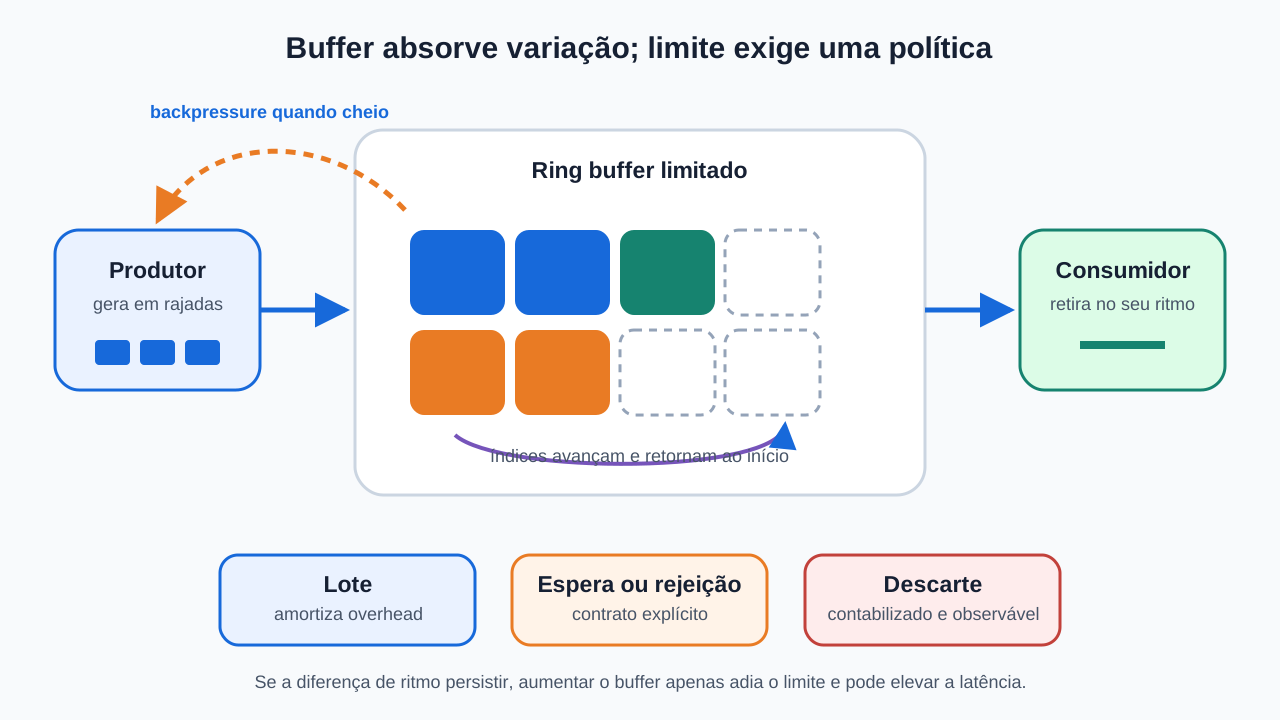
Um buffer guarda dados temporariamente enquanto produtor e consumidor avançam em ritmos ou unidades diferentes. Um teclado produz eventos esporádicos; áudio exige fluxo regular; rede chega em pacotes; armazenamento prefere blocos e filas. Sem espaço intermediário, qualquer atraso curto poderia perder dados ou bloquear imediatamente todo o caminho.
Buffers permitem:
- combinar pequenas operações em lotes maiores;
- alinhar dados às exigências do dispositivo;
- manter pedidos enquanto o hardware trabalha;
- desacoplar interrupção rápida do consumo em contexto normal;
- suportar leitura antecipada e escrita posterior;
- aplicar controle de fluxo quando a capacidade se aproxima do limite.
Eles não criam capacidade infinita. Quando o produtor mantém taxa maior que o consumidor, a fila cresce até atingir o limite. Depois, o sistema precisa exercer backpressure, bloquear, rejeitar, sobrescrever segundo contrato ou descartar com contabilidade. Apenas aumentar o buffer posterga o momento e pode elevar latência.
Buffer, cache e fila não são sinônimos. Um cache mantém uma cópia para evitar buscar novamente; um buffer acomoda transferência e diferenças de ritmo; uma fila organiza itens pendentes e sua ordem. A mesma estrutura pode cumprir mais de um papel, mas o diagnóstico precisa saber qual contrato importa.
Buffer circular mantém fluxo contínuo com espaço limitado
Em um ring buffer, posições formam um ciclo lógico. O produtor avança um índice de escrita e o consumidor, um índice de leitura. Ao chegar ao fim do vetor, cada índice retorna ao início. O espaço entre eles indica itens disponíveis e capacidade livre.
Essa estrutura aparece em áudio, rede e filas entre driver e controlador. Para funcionar corretamente, o protocolo precisa definir:
- como distinguir vazio de cheio;
- quem pode atualizar cada índice;
- quando conteúdo e descritor ficam visíveis;
- como sinalizar novo trabalho e espaço liberado;
- o que fazer quando a fila está cheia;
- como tratar wrap-around e contadores que avançam continuamente.
Em filas DMA, descritores podem alternar propriedade entre driver e dispositivo. O driver não reutiliza um descritor ainda pertencente ao hardware; o dispositivo não consome um item que não foi publicado. Esse é um problema de sincronização com participantes além das threads estudadas anteriormente.
E/S bloqueante, não bloqueante e assíncrona são contratos de espera
Em uma leitura bloqueante, a thread pode dormir até haver dado, conclusão, erro ou interrupção por sinal. Dormir não ocupa a CPU continuamente; o escalonador executa outro trabalho. Quando o evento ocorre, a thread se torna pronta.
Em modo não bloqueante, a operação retorna imediatamente se não puder avançar naquele momento, frequentemente com uma indicação como EAGAIN. A aplicação decide quando tentar novamente, normalmente guiada por uma interface de prontidão. Repetir em loop sem espera apenas converte o desenho em polling caro.
Em E/S assíncrona, a aplicação submete trabalho e recebe a conclusão depois, por evento, fila, callback ou outra interface. Isso não implica DMA: uma operação pode ser assíncrona para a thread e ainda usar cópias pela CPU; outra pode bloquear a thread enquanto o hardware usa DMA internamente.
Também não se deve assumir transferência completa. POSIX permite que read() retorne menos bytes que o solicitado, e uma operação interrompida pode retornar o que já transferiu ou EINTR quando nada foi transferido. Protocolos robustos tratam quantidade real, fim de arquivo, indisponibilidade temporária e erro.
Latência, vazão, IOPS e profundidade de fila medem aspectos diferentes
Uma operação de E/S tem custos de software, espera em fila, serviço do dispositivo e conclusão. Métricas comuns respondem a perguntas diferentes:
- latência: quanto uma operação demora;
- vazão: quantos bytes são transferidos por tempo;
- IOPS ou taxa de operações: quantos pedidos terminam por tempo;
- profundidade de fila: quantos pedidos estão pendentes ou em andamento;
- utilização: quanto tempo o recurso aparece ocupado segundo a ferramenta;
- erros, retries e timeouts: quantas operações não seguiram o caminho esperado.
Mais profundidade pode manter um dispositivo paralelo ocupado e elevar vazão, mas também aumenta espera por pedido. Lotes maiores amortizam overhead e interrupções, porém podem prejudicar latência de cauda. A melhor configuração depende do objetivo do serviço, não apenas do pico de throughput.
No servidor da plataforma, uma fila crescente de gravações pode resultar de armazenamento lento, rajada legítima, retries, flush, limites do dispositivo ou consumidor bloqueado. Trocar o driver sem evidência é tão prematuro quanto culpar o disco apenas por alta utilização.
Observar dispositivos, drivers e interrupções no Linux
Estas consultas não alteram o sistema:
head -n 20 /proc/interrupts
lspci -k
lsusb -t
/proc/interrupts registra contagens por CPU e por fonte, incluindo eventos que não pertencem a um periférico. Compare duas amostras: o total isolado depende do tempo de atividade. lspci -k mostra dispositivos PCI e módulos do kernel associados quando a ferramenta está instalada. lsusb -t apresenta a árvore USB e classes ou drivers disponíveis.
Para localizar a associação de um dispositivo já conhecido no modelo do kernel:
readlink /sys/class/net/eth0/device/driver 2>/dev/null
Substitua eth0 por uma interface que realmente exista; nomes variam. Ausência de saída pode indicar dispositivo virtual, permissão, outro nome ou falta de associação naquele caminho — não prova driver defeituoso.
No Windows, uma visão somente de leitura pode ser obtida no PowerShell:
Get-PnpDevice -PresentOnly |
  Select-Object -First 20 Class, FriendlyName, Status, InstanceId
As categorias e estados não equivalem diretamente aos do Linux. Para diagnosticar desempenho ou falha, combine inventário, logs, métricas da operação, versão do driver e contexto da carga.
Erros comuns
- “Driver é o próprio dispositivo.” Driver é software; controladora e periférico são componentes de hardware ou firmware.
- “Interrupção transfere os dados.” Ela sinaliza um evento; PIO ou DMA movimenta os bytes.
- “DMA não usa CPU.” A CPU e o driver configuram, publicam e concluem a operação, embora não copiem cada unidade.
- “DMA usa o ponteiro virtual da aplicação.” Dispositivos usam endereços e mapas próprios preparados pela plataforma.
- “DMA é sempre zero-copy.” Bounce buffers e cópias em outras camadas ainda podem existir.
- “Polling é sempre inferior.” Esperas muito curtas e cargas intensas podem favorecer polling controlado.
- “Interrupção por pacote é obrigatória.” Hardware pode agrupar conclusões ou usar várias filas.
- “Buffer maior resolve consumidor lento.” Apenas absorve uma diferença temporária e pode aumentar latência.
- “Cache, buffer e fila são iguais.” Eles evitam nova busca, acomodam transferência e ordenam pendências, respectivamente.
- “E/S assíncrona significa DMA.” Um descreve o contrato com a aplicação; o outro, a movimentação entre dispositivo e memória.
- “Uma leitura retorna sempre o tamanho pedido.” Retornos parciais são válidos e precisam ser tratados.
- “Contagem alta de interrupções prova problema.” Taxa, distribuição, trabalho concluído e latência dão contexto.
- “
volatiletorna DMA coerente.” Coerência e ordenação exigem as primitivas da arquitetura e da API de DMA.
O que você deve guardar
O sistema operacional transforma uma solicitação genérica em operação específica por meio de subsistemas, drivers e controladores. Registradores comandam e expõem estado; o driver conhece seus efeitos e integra descoberta, filas, energia, erros e conclusão.
Polling e interrupção respondem a como perceber mudanças. DMA responde a como mover dados sem a CPU executar cada cópia. Eles são combináveis: a CPU configura DMA, o dispositivo transfere e uma interrupção anuncia o fim.
Buffers e filas absorvem variações, permitem lotes e sustentam execução concorrente, mas exigem capacidade, propriedade e backpressure explícitos. Desempenho precisa equilibrar latência, vazão, taxa de operações e profundidade de fila.
Na próxima aula, veremos como sistemas de arquivos organizam arquivos, diretórios, metadados e links sobre mecanismos de armazenamento.
Referências
- Linux Kernel Documentation — Bus-Independent Device Accesses. Acesso em 5 set. 2026.
- Linux Kernel Documentation — Linux generic IRQ handling. Acesso em 5 set. 2026.
- Linux Kernel Documentation — Dynamic DMA mapping Guide. Acesso em 5 set. 2026.
- Linux Kernel Documentation — The Linux Kernel Device Model. Acesso em 5 set. 2026.
- Linux Kernel Documentation — The Userspace I/O HOWTO. Acesso em 5 set. 2026.
- Linux man-pages —
proc_interrupts(5). Acesso em 5 set. 2026. - The Open Group — POSIX.1-2024:
read. Acesso em 5 set. 2026. - The Open Group — POSIX.1-2024:
poll. Acesso em 5 set. 2026. - Microsoft Learn — Introduction to Interrupt Service Routines. Acesso em 5 set. 2026.
- Microsoft Learn — DMA Verification. Acesso em 5 set. 2026.
- Microsoft Learn — Using Direct I/O with DMA. Acesso em 5 set. 2026.
- Microsoft Learn — Kernel DMA Protection. Acesso em 5 set. 2026.
- ACM, IEEE-CS e AAAI — CS2023: Operating Systems. Acesso em 5 set. 2026.