
Monitoramento e diagnóstico de CPU, memória, disco e processos
Monitorar não é apenas olhar números
Um sistema pode responder lentamente com CPU aparentemente folgada, memória quase toda ocupada e disco exibindo muita atividade. Nenhuma dessas observações, sozinha, identifica a causa. A CPU pode estar esperando E/S; a memória ocupada pode ser cache recuperável; o disco pode transferir muitos dados com latência aceitável; e o processo que mais consome recursos pode ser consequência, não origem, do problema.
Monitoramento coleta e acompanha sinais do sistema. Diagnóstico usa esses sinais, o contexto e testes controlados para explicar um sintoma. O primeiro pode avisar que algo mudou; o segundo precisa construir uma hipótese capaz de explicar quando, onde e por que o impacto ocorreu.
Esta aula aplica operacionalmente conceitos das aulas sobre escalonamento de CPU, memória virtual e entrada e saída. O foco agora não é reconstruir esses mecanismos, mas interpretar sua evidência durante uma investigação.
Comece pelo sintoma e por uma janela de tempo
“O servidor está lento” ainda não é uma pergunta diagnóstica. Registre a operação afetada, quem percebeu, início, duração, frequência, host, serviço e consequência. “Entre 14h12 e 14h18, a geração do relatório passou de 4 para 38 segundos no host A” oferece uma janela que pode ser comparada com métricas, processos e registros.
Antes de reiniciar ou encerrar processos, preserve o que for seguro: horário, carga, memória, E/S, lista de processos, estado do serviço e eventos do kernel. A aula sobre serviços, systemd e registros mostra como delimitar o journal por unidade e boot. Reiniciar pode recuperar temporariamente a função, mas também muda PIDs, esvazia filas e caches e destrói parte da evidência.
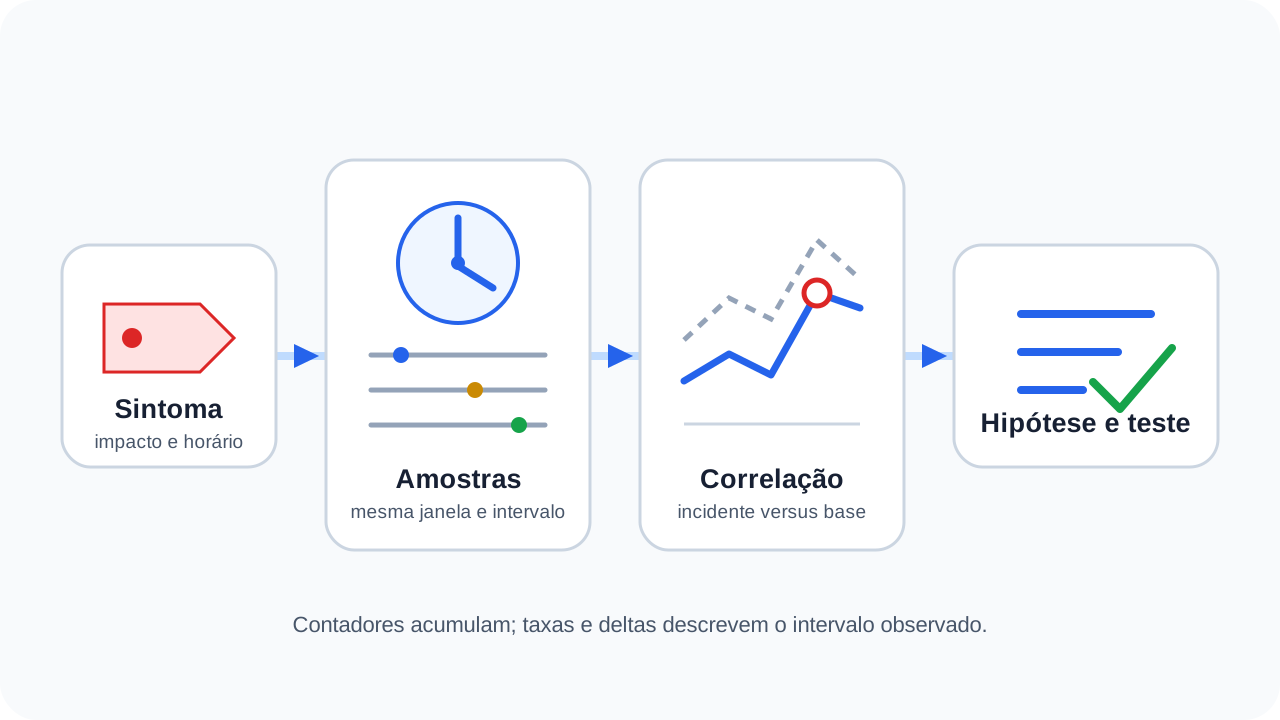
Uma sequência útil é:
- delimitar sintoma, impacto e período;
- confirmar o escopo: uma operação, processo, serviço, host ou vários;
- coletar amostras sincronizadas sem alterar o sistema;
- comparar com uma linha de base equivalente;
- localizar espera, saturação, erro ou crescimento anormal;
- atribuir o comportamento a processos, serviços ou grupos;
- formular uma hipótese e prever o que mais deveria ser observado;
- testar uma mudança pequena, validar o resultado e manter reversão disponível.
Contador, taxa, nível e distribuição respondem perguntas diferentes
Um contador acumulado cresce desde algum marco, como boot ou criação do processo. Seu valor absoluto raramente revela a intensidade atual; o delta dividido pelo intervalo produz uma taxa. Um nível descreve um estado naquele instante, como bytes disponíveis ou fila atual. Uma distribuição preserva variação, como latências em faixas ou percentis, que uma média pode esconder.
Ferramentas também escolhem períodos distintos. Em vmstat, o primeiro relatório sem a opção que o omite traz médias desde a inicialização; relatórios seguintes representam o intervalo configurado. O iostat segue ideia semelhante. Comparar um acumulado de horas com uma taxa de um segundo cria uma narrativa falsa.
Intervalos muito longos diluem picos; intervalos muito curtos amplificam ruído e aumentam o custo da observação. A própria coleta consome CPU, memória, disco ou rede. Use resolução suficiente para capturar o sintoma, duração suficiente para enxergar o padrão e frequência compatível com o ambiente.
Uma linha de base não é um número universal retirado de outra máquina. Compare o sistema consigo mesmo em horários, cargas e versões semelhantes. Uma CPU sustentada em 85% pode ser saudável quando entrega a demanda com latência estável; 35% pode coexistir com uma única thread crítica saturando um núcleo.
CPU: ocupação não basta
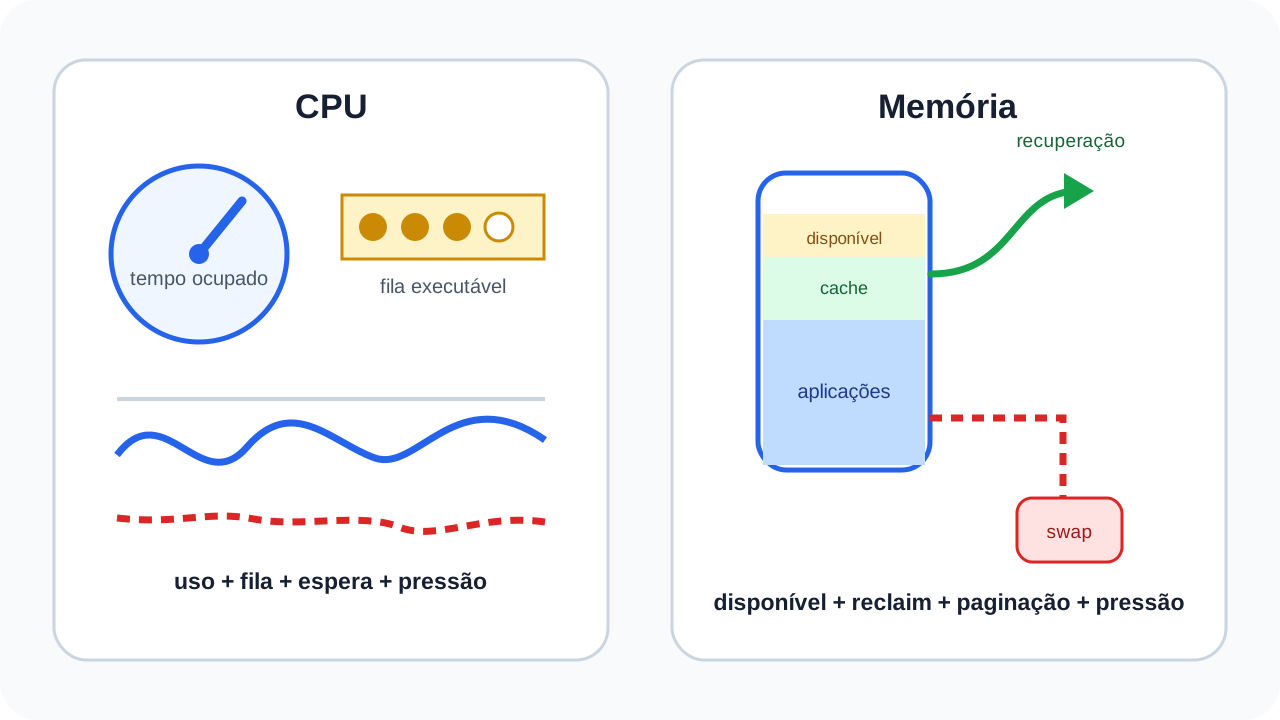
Percentuais de CPU distribuem o tempo observado em categorias. No Linux, ferramentas como vmstat, mpstat e top podem separar execução em espaço de usuário, kernel, ociosidade, espera de E/S e tempo retirado de uma máquina virtual pelo hospedeiro. Os nomes e cálculos variam entre ferramentas e versões, portanto consulte a documentação da instalação.
Interprete pelo menos quatro dimensões:
| Evidência | Pergunta útil | Cuidado |
|---|---|---|
| CPU por sistema e por núcleo | existe capacidade ociosa e ela está distribuída? | a média total pode esconder um núcleo saturado |
| fila executável | há mais tarefas prontas do que CPU disponível? | um pico breve não prova contenção persistente |
| categorias de tempo | o trabalho ocorre em usuário, kernel, espera ou virtualização? | iowait não identifica sozinho um disco culpado |
| processo e thread | quem acumulou tempo no mesmo intervalo? | média por processo pode esconder uma thread quente |
No Linux, load average não é porcentagem de CPU. /proc/loadavg contabiliza, nas médias de 1, 5 e 15 minutos, entidades executáveis ou esperando por E/S de disco. O valor precisa ser relacionado à quantidade de CPUs lógicas e, principalmente, à composição da espera. Uma carga alta com CPU ociosa pode apontar tarefas bloqueadas, não falta de ciclos de processador.
O campo r de vmstat mostra processos executáveis, rodando ou esperando tempo de CPU. Crescimento persistente de r, núcleos ocupados e degradação simultânea favorecem a hipótese de contenção de CPU. Já st pode revelar tempo cedido pelo hipervisor em uma máquina virtual. Interrupções e trocas de contexto elevadas merecem contexto: são trabalho necessário em muitos sistemas e só ganham significado quando mudam junto ao impacto.
Pressure Stall Information (PSI) complementa utilização ao estimar quanto tempo tarefas ficam paradas por falta de CPU, memória ou E/S. Os arquivos /proc/pressure/cpu, /proc/pressure/memory e /proc/pressure/io expõem janelas e totais. Pressão indica perda de tempo por contenção; ainda é necessário descobrir a carga e o componente responsáveis.
Memória: ocupada não significa indisponível
Sistemas usam RAM livre para cache porque acesso à memória é mais rápido que nova leitura de armazenamento. Por isso, MemFree baixo não demonstra falta de memória. No Linux, MemAvailable estima quanto pode ser oferecido a novas aplicações sem swap, considerando páginas livres e partes recuperáveis do cache e do kernel.
Observe a trajetória, não apenas uma fotografia:
MemAvailablecai continuamente ou se estabiliza?- cache cresce para servir uma carga conhecida e pode ser recuperado?
- há recuperação frequente, compactação ou pressão PSI de memória?
- entradas e saídas de swap acontecem durante o sintoma?
- page faults maiores aumentam junto à latência?
- o kernel registrou uma decisão do OOM killer?
Swap em uso não equivale a thrashing atual. Páginas antigas podem permanecer no espaço de troca mesmo depois de a pressão passar. Os campos si e so de vmstat, a pressão, a latência e a taxa de falhas ajudam a distinguir ocupação histórica de movimentação ativa.
RSS aproxima páginas residentes associadas a um processo, mas páginas compartilhadas podem aparecer em mais de um processo. Somar RSS de toda a lista pode superestimar a RAM física. VSZ descreve espaço de endereçamento virtual, não quantidade de RAM consumida. Para atribuição rigorosa, mecanismos como PSS em smaps distribuem proporcionalmente páginas compartilhadas, ao custo de uma coleta mais detalhada.
Disco: vazão, latência e fila precisam andar juntas
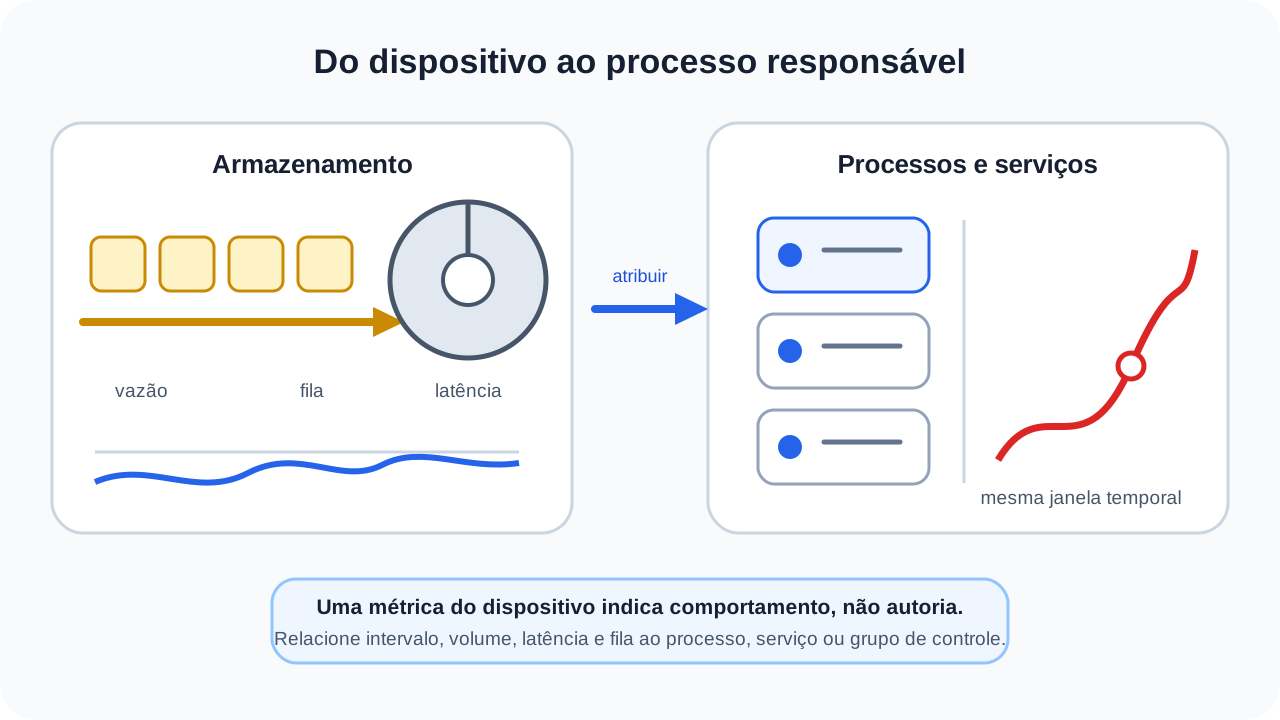
Armazenamento pode limitar uma aplicação mesmo sem atingir a vazão anunciada pelo fabricante. Requisições pequenas e aleatórias, sincronização de dados, cache, controladora, camada virtual, volume lógico e sistema de arquivos alteram o comportamento. Diferencie capacidade de espaço — bytes e inodes disponíveis — de desempenho do dispositivo.
No iostat -x, indicadores frequentes incluem:
- taxa de operações e vazão: quantas requisições e quantos bytes foram concluídos no intervalo;
await: tempo médio, incluindo espera na fila e atendimento, para requisições concluídas;aqu-sz: profundidade média da fila;%util: fração do tempo em que houve E/S em andamento segundo a contabilidade do dispositivo.
%util próximo de 100% pode sinalizar saturação em dispositivos que atendem essencialmente uma requisição por vez. A documentação do sysstat alerta que esse número não representa o limite de desempenho de dispositivos capazes de paralelismo, como matrizes RAID e SSDs modernos. Neles, várias operações podem avançar juntas. Combine latência, fila, vazão, capacidade conhecida e impacto da aplicação.
Também evite tratar iowait da CPU como “porcentagem de uso do disco”. Ele descreve uma condição do processador segundo a contabilidade do kernel e não aponta qual dispositivo, processo ou dependência causou a espera. Use estatísticas do dispositivo e atribuição por processo para testar a hipótese.
Um dispositivo ocupado ainda não diz quem causou a carga
Depois de localizar mudança no recurso, desça até processos e serviços no mesmo intervalo. pidstat pode amostrar CPU, memória, page faults e E/S por tarefa. ps oferece uma fotografia flexível; top ajuda na observação interativa. Em sistemas com systemd e cgroup v2, dados do grupo podem representar melhor um serviço formado por vários trabalhadores do que um único PID.
PIDs são reutilizados. Associe PID a comando, horário, unidade, cgroup ou identificador estável. Processos curtos também podem desaparecer entre duas amostras. Para cargas com muitos trabalhadores, agregue no nível do serviço e só depois identifique indivíduos.
Uma escrita volumosa atribuída a um processo não prova que ela seja indevida. Pode ser o trabalho esperado. A pergunta é se volume, padrão, latência e fila mudaram junto ao sintoma, e se uma explicação plausível conecta os fatos.
Uma coleta inicial no Linux deve ser pequena e sincronizada
Os comandos abaixo são somente de leitura, mas dependem de permissões e de pacotes instalados. iostat e pidstat normalmente pertencem ao sysstat. Opções e campos variam conforme a versão. Ajuste duração e intervalo ao ambiente; não deixe coletores de alta frequência rodando indefinidamente.
date --iso-8601=seconds
uptime
cat /proc/loadavg
cat /proc/pressure/cpu
cat /proc/pressure/memory
cat /proc/pressure/io
free -h
vmstat -y -w -t 1 5
iostat -y -xz 1 5
pidstat -dur 1 5
-y evita, onde suportado, misturar o primeiro relatório desde o boot com as amostras do intervalo. -t registra horário no vmstat; mantenha relógios coerentes para cruzar fontes. Cinco amostras podem orientar uma triagem, mas não substituem coleta que cubra todo o incidente.
Uma fotografia ordenada de processos pode complementar:
ps -eo pid,ppid,stat,ni,psr,%cpu,%mem,rss,vsz,etimes,comm --sort=-%cpu
ps -eo pid,ppid,stat,%cpu,%mem,rss,etimes,comm --sort=-rss
STAT ajuda a reconhecer tarefas executáveis, dormindo ou em espera ininterruptível; os códigos exatos são documentados pelo ps. %CPU pode ser calculado sobre a vida do processo, não apenas sobre o último segundo. Para taxas no intervalo, prefira um amostrador apropriado.
Para relacionar erros de kernel e serviço à mesma janela, reutilize a abordagem da aula anterior:
journalctl -k -b --since '30 minutes ago' --no-pager
journalctl -u exemplo.service -b --since '30 minutes ago' --no-pager
Não publique saídas sem revisão. Linhas de comando, nomes de usuário, caminhos, argumentos, endereços e logs podem conter segredos ou dados pessoais.
No Windows, contadores também dependem de intervalo
O Windows expõe performance counters para objetos como processador, memória, disco e processo. Muitos tipos exigem duas amostras e seus horários para que a taxa seja calculada. Gerenciador de Tarefas, Monitor de Recursos e Monitor de Desempenho oferecem visões diferentes; Get-Counter, typeperf e logman permitem coleta por linha de comando.
Um exemplo de leitura curta no PowerShell é:
Get-Counter `
  '\Processor(_Total)\% Processor Time', `
  '\Memory\Available MBytes', `
  '\PhysicalDisk(_Total)\Avg. Disk sec/Transfer' `
  -SampleInterval 1 -MaxSamples 5
Os nomes dos conjuntos e contadores podem ser localizados conforme o idioma do sistema. Liste o que existe com Get-Counter -ListSet * e selecione instâncias pertinentes. O objeto _Total ajuda na visão geral, mas pode esconder um processador lógico ou disco específico. Em versões recentes, o conjunto Process V2 reduz ambiguidades causadas por nomes de instância não exclusivos do conjunto antigo.
Não transplante um limiar fixo entre hardware, carga e versão. A documentação de suporte da Microsoft oferece roteiros de investigação, mas o valor operacional deve nascer da linha de base, do objetivo do serviço e do impacto observado.
Exemplo: relatório lento com CPU moderada
Imagine que relatórios ficaram lentos durante seis minutos. A CPU total permaneceu em 45%. Concluir “não é infraestrutura” seria prematuro.
Na mesma janela, a carga subiu, tarefas bloqueadas apareceram em vmstat, a pressão de E/S aumentou e o volume de dados mostrou maior await e fila. pidstat atribuiu escritas a trabalhadores do serviço de relatório. O journal registrou o começo de uma exportação maior que o padrão. Juntos, esses sinais sustentam a hipótese de contenção de armazenamento durante a exportação.
A hipótese faz previsões: quando a exportação terminar, fila, pressão e latência devem recuar junto ao tempo de resposta; em uma reprodução controlada com volume equivalente, o padrão deve reaparecer. Se a aplicação continuar lenta depois de a E/S normalizar, a explicação é insuficiente e a investigação prossegue.
Mesmo nesse cenário, a ação não é automaticamente “trocar o disco”. Pode haver consulta ineficiente, escrita temporária desnecessária, concorrência entre rotinas, limite do volume virtual ou configuração do sistema de arquivos. O diagnóstico localiza a restrição e reduz o espaço de busca; a correção depende da causa confirmada.
Métricas, logs, rastros e perfis se complementam
Métricas resumem comportamento ao longo do tempo e são eficientes para tendência e alerta. Logs registram eventos discretos com contexto. Rastros acompanham uma operação entre componentes. Perfis amostram onde CPU ou espera são consumidas dentro do programa. Nenhuma fonte substitui todas as outras.
Se CPU está saturada e um processo foi atribuído, um profiler pode separar cálculo útil, laço defeituoso ou contenção interna. Se armazenamento tem latência, um rastro pode mostrar qual operação de aplicação esperou. Se o kernel encerrou um processo por falta de memória, o journal fornece o evento enquanto a série temporal explica como a pressão evoluiu.
Colete com finalidade e retenção definidas. Observabilidade irrestrita custa recursos e pode ampliar exposição de dados. Prefira sinais necessários, acesso mínimo, relógios sincronizados e identificadores que permitam correlação sem registrar conteúdo sensível.
Erros comuns
- “CPU alta é sempre ruim.” Alta ocupação pode representar trabalho útil; procure fila, latência e objetivo não atendido.
- “Load 8 significa 80%.” Load average contabiliza entidades executáveis ou esperando E/S e não é porcentagem.
- “CPU total baixa exclui gargalo de CPU.” Uma thread pode limitar um núcleo enquanto os demais ficam ociosos.
- “
iowaitalto prova disco lento.” Ele não identifica dispositivo nem causa; correlacione estatísticas de E/S e processos. - “Memória livre baixa exige limpar cache.” Cache é uso produtivo e recuperável; observe disponível, recuperação e pressão.
- “Swap usada significa thrashing.” Ocupação pode ser histórica; procure movimentação ativa e impacto.
- “VSZ é RAM consumida.” É espaço virtual; RSS, PSS e características de compartilhamento respondem outras perguntas.
- “Somar RSS dá o uso real.” Páginas compartilhadas podem ser contadas repetidamente.
- “Disco a 100% está no limite físico.”
%utilexige cautela em dispositivos paralelos. - “Mais vazão sempre significa pior desempenho.” O dispositivo pode entregar mais trabalho com latência estável.
- “O processo no topo causou o incidente.” A lista é uma fotografia; ele pode ser consequência ou trabalho legítimo.
- “Uma amostra basta.” Diagnóstico precisa de intervalo, tendência e correlação.
- “Reiniciar confirma a causa.” Reinício modifica muitas variáveis e pode apenas esconder o sintoma.
- “Existe um limite universal.” Capacidade, objetivo e linha de base variam entre sistemas.
O que você deve guardar
Diagnóstico começa no efeito percebido, não na ferramenta. Delimite o tempo, preserve o estado e obtenha amostras comparáveis. Saiba se cada valor é contador, taxa, nível ou distribuição. Compare com uma linha de base do próprio ambiente.
Para CPU, relacione ocupação, núcleos, fila executável, categorias de tempo e pressão. Para memória, diferencie ocupação de indisponibilidade e acompanhe cache, recuperação, swap, page faults e pressão. Para armazenamento, una vazão, latência, profundidade da fila e particularidades do dispositivo. Depois, atribua a carga a processos, serviços ou cgroups no mesmo intervalo.
Em ambientes virtualizados, o escopo muda a interpretação: uma métrica pode pertencer ao host, ao convidado, ao cgroup ou ao processo. A aula sobre máquinas virtuais e contêineres explica quais recursos cada modelo compartilha e onde ficam suas fronteiras.
Referências
- Linux Kernel — Pressure Stall Information. Acesso em 5 set. 2026.
- Linux Kernel — The
/procFilesystem. Acesso em 5 set. 2026. - Linux Kernel — Control Group v2. Acesso em 5 set. 2026.
- Linux man-pages —
/proc/loadavg. Acesso em 5 set. 2026. - Linux man-pages —
/proc/meminfo. Acesso em 5 set. 2026. - procps-ng —
vmstat(8). Acesso em 5 set. 2026. - procps-ng —
ps(1). Acesso em 5 set. 2026. - sysstat —
iostat(1). Acesso em 5 set. 2026. - sysstat — ferramentas de desempenho do Linux. Acesso em 5 set. 2026.
- Microsoft Learn — About Performance Counters. Acesso em 5 set. 2026.
- Microsoft Learn — Troubleshoot performance problems in Windows. Acesso em 5 set. 2026.