
Paginação, memória virtual, page fault e swap
Paginação conecta o mapa do processo à memória disponível
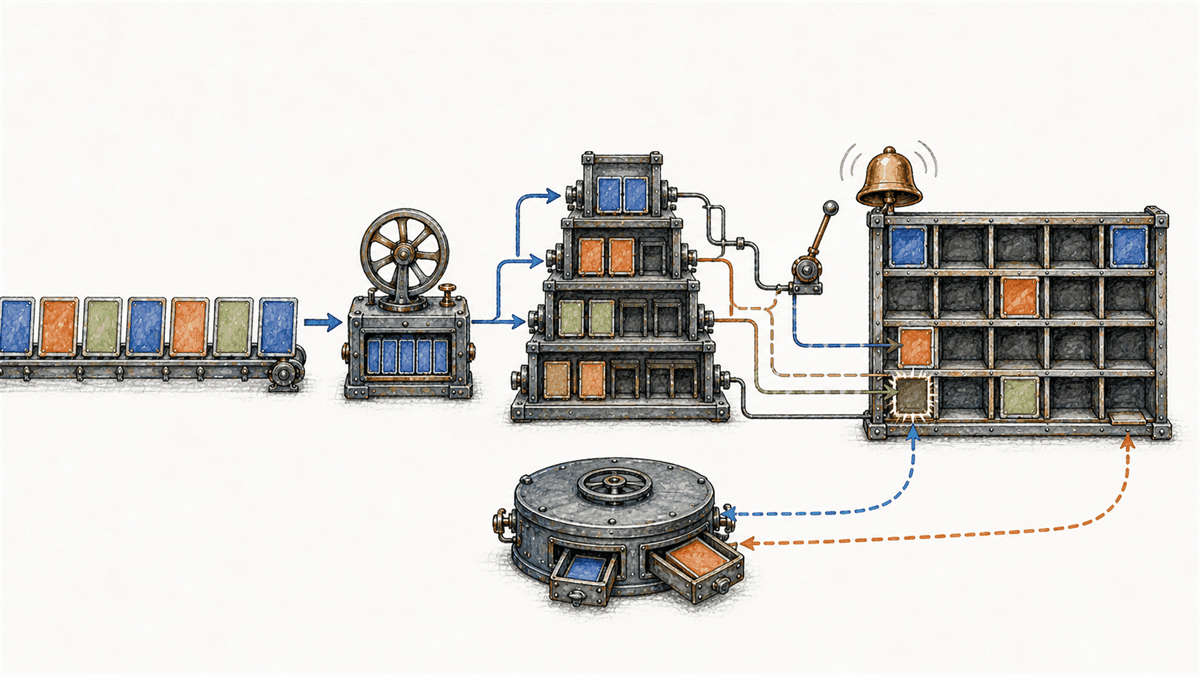
A aula anterior mostrou que um processo usa endereços virtuais e não posições fixas da RAM. A paginação implementa essa separação ao dividir o espaço virtual em blocos chamados páginas e a memória física em blocos de tamanho correspondente, os quadros. Uma página virtual pode ser associada a qualquer quadro adequado, permanecer sem sustentação física até ser acessada ou ter seu conteúdo recuperado de outra origem.
Memória virtual é o conjunto de abstrações e mecanismos que oferece a cada processo um espaço de endereçamento protegido, permite mapeamentos privados ou compartilhados e administra a presença dos dados na memória física. Ela não é apenas “uma parte do disco usada como RAM”. Swap é somente uma das possíveis fontes para páginas que não estão residentes.
Este conteúdo aprofunda memória física, endereços e o espaço de um processo. O foco agora é tradução, presença, faltas de página e pressão de memória. Heap, pilha e regiões continuam pertencendo ao modelo anterior; políticas detalhadas de diagnóstico ficarão para a aula de monitoramento.
Página virtual e quadro físico têm a mesma granularidade básica
Considere, para fins didáticos, páginas de 4 KiB. Um intervalo virtual de 16 KiB contém quatro páginas. Elas não precisam ocupar quatro quadros consecutivos: a página virtual 0 pode estar no quadro 7, a página 1 no quadro 42 e a página 2 ainda não estar presente. Para o programa, o intervalo continua organizado.
O tamanho real de página depende da arquitetura e da configuração. Sistemas modernos também podem oferecer páginas maiores. Portanto, 4 KiB é um exemplo recorrente, não uma constante universal.
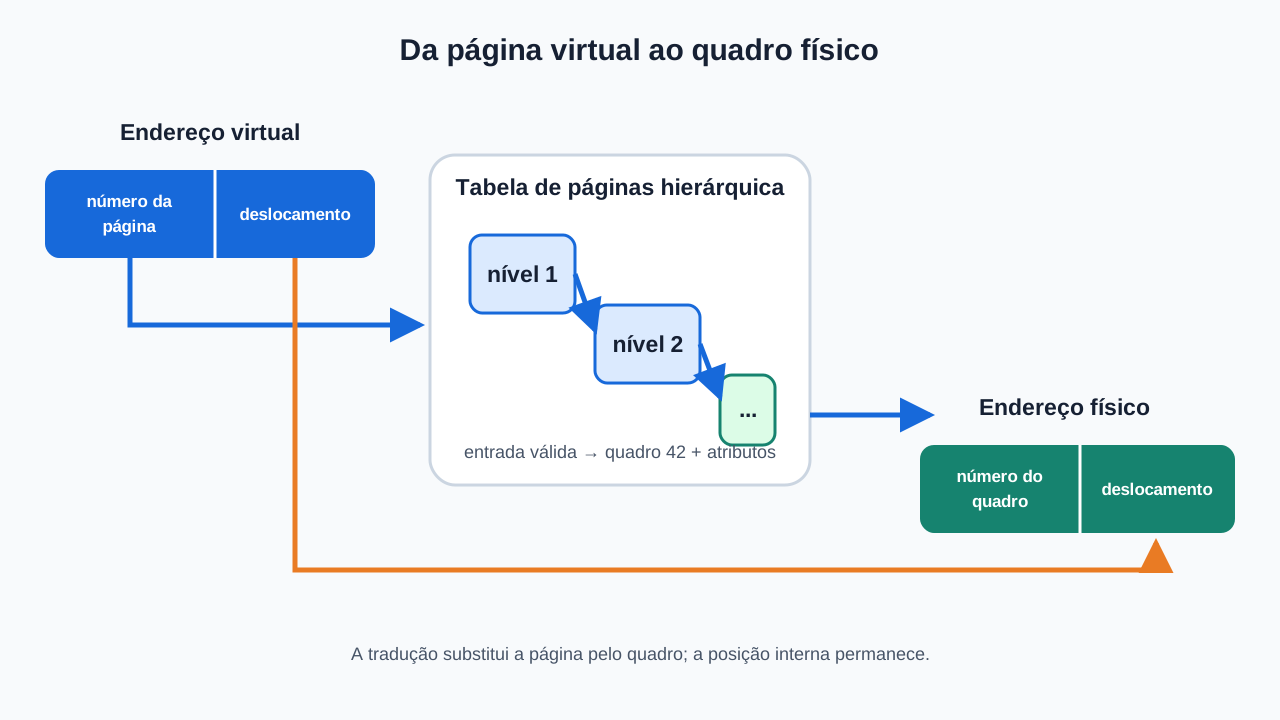
Um endereço virtual paginado é interpretado em duas partes:
- número da página virtual: seleciona a tradução;
- deslocamento: indica o byte dentro da página.
A tradução troca o número da página pelo número do quadro e preserva o deslocamento. Se a página virtual começa em 0x4000 e o acesso usa deslocamento 0x012, o byte procurado estará no quadro traduzido, também no deslocamento 0x012.
Páginas reduzem a necessidade de contiguidade física, mas não eliminam toda fragmentação. Pode existir fragmentação interna quando a última página de uma alocação não é completamente usada. Alocações que exigem vários quadros fisicamente contíguos, como alguns buffers e páginas enormes, continuam mais difíceis sob fragmentação física.
A tabela de páginas registra traduções e atributos
Cada processo possui um contexto de tradução. Suas tabelas de páginas associam páginas virtuais a quadros ou a estados que permitem ao kernel decidir como atender um acesso. Uma entrada pode representar, conforme a arquitetura e o sistema:
- quadro físico atualmente presente;
- permissão de leitura, escrita e execução;
- página acessada ou modificada;
- conteúdo ainda não materializado;
- informação necessária para recuperar conteúdo não residente;
- mapeamento inválido.
Espaços de 64 bits podem representar uma quantidade enorme de páginas. Manter uma tabela linear completa desperdiçaria memória para as vastas lacunas não usadas. Por isso, implementações comuns organizam as tabelas em níveis hierárquicos. Partes sucessivas do número da página escolhem entradas em cada nível; estruturas inferiores só precisam existir para regiões relevantes.
O Linux define uma hierarquia de software atualmente com até cinco níveis e adapta ou dobra níveis conforme a arquitetura. Isso não significa que todos os processadores façam exatamente cinco consultas nem que o programador de aplicação deva decorar nomes internos. O princípio duradouro é a navegação hierárquica e esparsa.
As próprias tabelas ocupam memória. Processos com muitos mapeamentos dispersos ou conjuntos virtuais enormes podem aumentar esse custo mesmo que nem todo conteúdo esteja residente. Páginas maiores reduzem a quantidade de traduções necessária, mas podem desperdiçar mais espaço e exigir blocos físicos mais difíceis de obter.
A MMU executa a tradução e a TLB guarda atalhos
A MMU é a unidade de hardware que participa da tradução e verifica atributos de proteção. Consultar vários níveis de tabela a cada leitura de memória seria caro, então processadores mantêm um cache pequeno e rápido de traduções recentes: a Translation Lookaside Buffer, ou TLB.
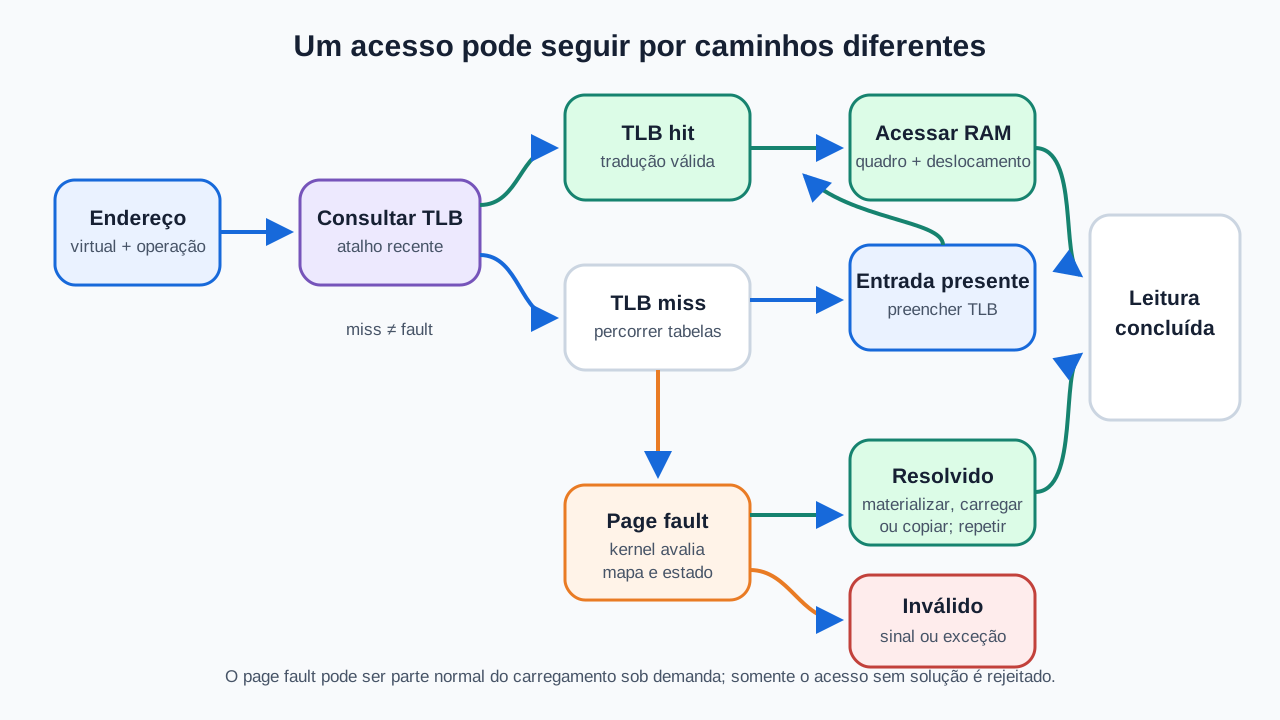
Em um TLB hit, a tradução compatível com o contexto e o acesso já está no cache. Em um TLB miss, o processador ou uma rotina da arquitetura precisa percorrer as tabelas; se encontrar uma entrada válida e presente, pode preencher a TLB e repetir o acesso.
TLB miss e page fault não são sinônimos. O primeiro pode terminar apenas com a descoberta de uma tradução já existente. O page fault surge quando o estado encontrado exige intervenção do sistema: a página não está presente, precisa ser criada, está protegida para copy-on-write ou o acesso viola o mapeamento.
Quando o kernel altera uma tradução, entradas antigas da TLB não podem continuar valendo. O sistema invalida a página, a faixa ou o contexto necessário. Em máquinas com vários núcleos, essa coerência pode exigir comunicação entre CPUs que executaram aquele espaço, acrescentando custo a mudanças frequentes de mapeamento.
Page fault é uma exceção, não necessariamente um defeito
Quando a MMU não consegue completar o acesso com o estado atual, o processador pausa o fluxo normal e transfere controle ao tratador do kernel. Esse evento é uma falta de página. O sistema examina o endereço, a região, a operação e a entrada correspondente.
Há resultados legítimos comuns:
- demand-zero: o processo acessa pela primeira vez uma página anônima válida; o sistema fornece conteúdo inicial zerado segundo o contrato;
- carregamento sob demanda: código ou dado de um arquivo mapeado é lido apenas quando necessário;
- copy-on-write (COW): duas execuções compartilham uma página protegida; na primeira escrita, o sistema cria uma cópia privada para quem escreve;
- retorno do swap: conteúdo anônimo preservado fora da RAM precisa ser trazido de volta;
- proteção inválida: o endereço não pertence a uma região permitida ou a operação viola suas permissões.
Nos quatro primeiros casos, o kernel pode preparar um quadro, atualizar a entrada, ajustar a TLB e repetir a instrução. Para a aplicação, o resultado parece um acesso comum, embora exista custo adicional. No último caso, não há tradução legítima a construir; o processo recebe um sinal ou exceção, como discutido na aula anterior.
Por isso, “o programa teve page fault” não basta como diagnóstico. Aplicações saudáveis acumulam faults ao iniciar, carregar bibliotecas, crescer estruturas e escrever em páginas COW. Importam o tipo, a taxa, a latência, a origem e a correlação com a carga.
Minor e major page fault descrevem o custo de resolução
No Linux, as métricas tradicionais separam:
- minor fault: resolvido sem carregar uma página do disco;
- major fault: exigiu carregar uma página do disco.
Um demand-zero ou uma página já presente em outro contexto pode gerar minor fault. Um major fault pode trazer conteúdo de swap ou de um arquivo mapeado, inclusive executável e biblioteca. Portanto, major fault não prova uso de swap.
Outras plataformas podem definir e contabilizar faltas de maneira diferente. No Windows, por exemplo, a documentação distingue hard faults, que exigem leitura do backing store, de soft faults resolvidos sem esse acesso. Compare contadores somente após conhecer a definição da ferramenta.
Uma taxa baixa de major faults pode ser normal durante inicialização. Taxa persistente acompanhada de espera de armazenamento, aumento de latência e troca intensa de páginas sugere pressão ou conjunto de trabalho maior que a capacidade disponível.
Copy-on-write adia a cópia até existir escrita
Após uma operação como fork() em sistemas POSIX, copiar imediatamente todas as páginas privadas seria caro e muitas delas seriam substituídas por exec() logo depois. Com COW, processo pai e filho podem inicialmente mapear os mesmos quadros com escrita protegida.
Se apenas leem, o compartilhamento continua. Quando um deles tenta escrever:
- a proteção provoca um page fault esperado;
- o kernel aloca um quadro;
- copia o conteúdo necessário;
- altera o mapa de quem escreveu para a cópia privada;
- permite que a instrução seja repetida.
COW economiza cópia antecipada, não torna a escrita gratuita. Uma carga que modifica grande parte do espaço após fork() ainda paga alocação, cópia e atualização de traduções. O mecanismo também aparece em snapshots e deduplicação, com contratos próprios.
Carregamento sob demanda evita trazer o que não será usado
Executáveis e bibliotecas podem ser mapeados sem leitura imediata de todas as páginas. Quando a CPU alcança uma página de código ainda ausente, o fault permite carregá-la de seu arquivo. Trechos nunca executados talvez nunca ocupem RAM.
O mesmo vale para um arquivo mapeado por mmap(): mapear uma faixa cria uma relação no espaço virtual, não obriga a ler o arquivo inteiro naquele instante. Esse comportamento reduz trabalho inicial e deixa o sistema formar um conjunto residente segundo o uso real.
O custo aparece no primeiro acesso. Sistemas podem usar leitura antecipada quando detectam padrões sequenciais, trocando mais I/O imediato por menos faults futuros. Se o padrão for aleatório, antecipação excessiva pode desperdiçar largura de banda e memória.
Reclaim escolhe memória que pode ser reutilizada
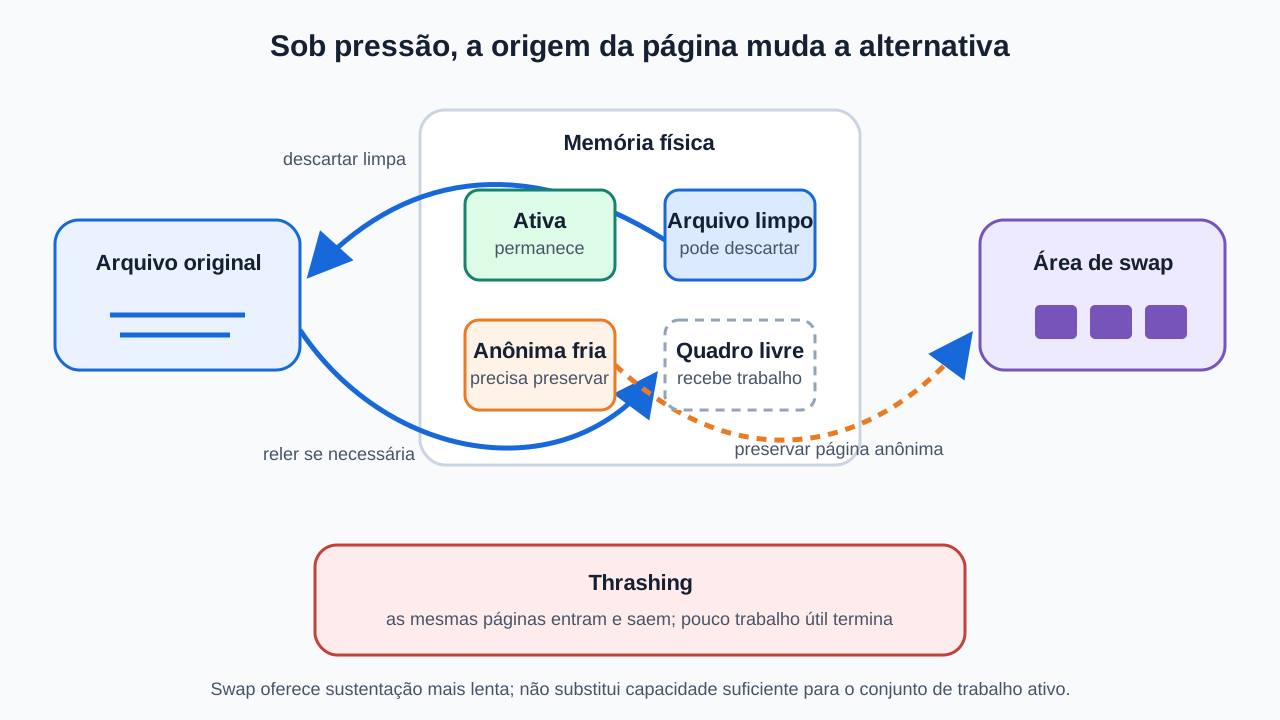
Quando quadros livres ficam escassos, o sistema precisa recuperar memória. Duas categorias ajudam a entender as opções:
- páginas apoiadas em arquivo e limpas: podem ser descartadas porque o conteúdo continua no arquivo e pode ser relido;
- páginas anônimas modificadas: não possuem uma cópia atual em arquivo comum; para preservá-las fora da RAM, é necessário um backing store como swap.
Páginas sujas apoiadas em arquivo precisam ser gravadas antes de descarte, respeitando o sistema de arquivos e o contrato de sincronização. Páginas fixadas, não pagináveis ou indispensáveis ao kernel podem não ser candidatas.
Algoritmos reais não mantêm uma lista perfeita do “menos usado”. Eles aproximam recência, frequência, tipo e custo com bits de acesso, listas, gerações e outras estruturas. O objetivo é preservar o conjunto de trabalho ativo e recuperar o que tem menor probabilidade ou menor custo de reutilização.
Swap preserva páginas anônimas fora da RAM
Swap é uma área de armazenamento usada para guardar conteúdo paginável que precisa sair da memória física sem ser perdido, especialmente páginas anônimas. Em Linux, pode ser uma partição ou um arquivo; outras plataformas usam mecanismos e terminologia próprios.
Swap amplia as opções de reclaim e pode manter processos ociosos sem conservar todas as suas páginas na RAM. Porém, o armazenamento persistente possui latência muito maior que memória e não transforma um equipamento em outro com RAM equivalente.
Um ciclo simplificado sob pressão é:
- o sistema identifica uma página pouco ativa;
- se necessário, preserva seu conteúdo no swap;
- reutiliza o quadro para trabalho mais ativo;
- um acesso futuro provoca page fault;
- o conteúdo retorna a um quadro disponível.
No Linux atual, vm.swappiness representa uma preferência aproximada baseada no custo relativo entre I/O de swap e paginação de arquivos, numa escala documentada de 0 a 200. Não é “a porcentagem de RAM a partir da qual começa o swap”, e zero não significa desativação absoluta em toda situação. Alterá-lo sem medir o workload pode apenas deslocar o custo.
Swap usado também não prova problema. Páginas frias podem permanecer nele enquanto a RAM serve a dados úteis, mesmo depois de a pressão diminuir. Taxas contínuas de entrada e saída, latência e ausência de progresso são sinais mais importantes que o total isolado.
Thrashing transforma a maior parte do tempo em movimentação
Thrashing ocorre quando a carga ativa exige mais páginas do que a memória consegue manter e o sistema passa a recuperar e expulsar repetidamente as mesmas unidades. A CPU espera, o armazenamento trabalha e pouco trabalho útil termina.
Adicionar swap pode evitar uma falha imediata, mas não resolve por si só um conjunto de trabalho persistentemente maior que a RAM. Respostas possíveis dependem da causa: limitar concorrência, reduzir dados ativos, corrigir vazamento, ajustar cache da aplicação, distribuir carga, impor limites de memória ou aumentar capacidade.
O encerramento de processos por falta de memória é uma etapa distinta. No Linux, se reclaim não consegue liberar o necessário, o sistema pode invocar o OOM killer para recuperar memória. Ter swap não garante que esse ponto nunca será alcançado; limites de cgroup, compromisso, páginas não recuperáveis e carga ainda importam.
Páginas grandes trocam alcance da TLB por flexibilidade
Se uma entrada da TLB cobre 4 KiB, são necessárias muitas traduções para um conjunto grande. Páginas enormes fazem cada entrada cobrir uma região maior, reduzindo pressão sobre TLB e tabelas em workloads adequados.
O benefício tem custos:
- maior fragmentação interna quando a região não é bem aproveitada;
- necessidade de memória física mais contígua ou de compactação;
- custo maior para copiar, migrar ou preencher a unidade;
- comportamento diferente entre páginas enormes reservadas e transparentes.
Não existe regra de que página maior sempre melhora desempenho. Bancos de dados, runtimes e cargas científicas podem se beneficiar, mas a decisão deve ser medida com o mecanismo e a plataforma concretos.
Observar antes de ajustar
No Linux, estes comandos somente leem informações:
getconf PAGESIZE
free -h
vmstat 1 5
getconf mostra o tamanho básico informado ao processo. free resume memória e swap. Em vmstat, observe especialmente swap-in e swap-out, blocos lidos e gravados, CPU esperando I/O e a tendência ao longo das amostras. A primeira linha costuma resumir o período desde a inicialização; as seguintes representam os intervalos solicitados.
Para contadores gerais do kernel:
awk '/pgfault|pgmajfault|pswpin|pswpout/ { print }' /proc/vmstat
Os valores são cumulativos. Colete duas amostras com intervalo conhecido e calcule a diferença; não compare números absolutos de máquinas com tempos de atividade distintos. Para processos, /proc/<PID>/stat registra contagens minor e major, sujeitas às permissões e à definição documentada.
Evite usar drop_caches como “limpeza de RAM” em produção. A própria documentação do kernel afirma que os caches são recuperados automaticamente e que descartá-los pode criar custo relevante de CPU e I/O. Também não altere swappiness, overcommit ou limites apenas porque um total parece alto. Primeiro correlacione demanda, faults, reclaim, I/O, latência e progresso da aplicação.
Erros comuns
- “Memória virtual é swap.” Memória virtual é o sistema de endereçamento, tradução e proteção; swap é um backing store possível.
- “Todo page fault é erro.” Demand-zero, COW e carregamento sob demanda produzem faults esperados.
- “TLB miss é page fault.” Um miss pode encontrar a tradução válida na tabela sem intervenção equivalente a uma página ausente.
- “Major fault significa swap.” O conteúdo também pode vir de executável, biblioteca ou arquivo mapeado.
- “Páginas consecutivas ocupam quadros consecutivos.” A contiguidade virtual pode ser construída sobre quadros dispersos.
- “Swap livre significa sistema saudável.” Uma máquina sem swap pode sofrer pressão; observe capacidade, reclaim e latência.
- “Swap usado significa falta de RAM agora.” Conteúdo frio pode continuar no swap sem troca ativa.
- “Aumentar swap equivale a aumentar RAM.” Isso amplia sustentação, mas mantém uma diferença grande de latência.
- “Página grande é sempre mais rápida.” Alcance da TLB melhora, porém flexibilidade e aproveitamento podem piorar.
- “Limpar cache libera memória desperdiçada.” Cache normalmente é reutilizável e evita I/O futuro.
- “
swappiness=0desativa swap.” O parâmetro expressa custo relativo e sua semântica é mais específica. - “Um contador cumulativo alto prova incidente.” Taxa no intervalo e correlação com sintomas são essenciais.
O que você deve guardar
Paginação divide o espaço virtual em páginas e a memória física em quadros. O número da página é traduzido; o deslocamento permanece. Tabelas hierárquicas tornam mapas grandes e esparsos viáveis, enquanto a TLB guarda traduções recentes para evitar percursos repetidos.
Page fault é a entrada controlada do kernel quando o acesso não pode prosseguir com o estado atual. Pode materializar uma página zerada, carregar arquivo, executar copy-on-write, trazer conteúdo do swap ou rejeitar um acesso inválido. Major fault indica I/O de armazenamento na métrica tradicional do Linux, não necessariamente swap.
Reclaim tenta preservar o conjunto de trabalho e reutilizar páginas menos úteis. Conteúdo limpo apoiado em arquivo pode ser relido; páginas anônimas podem precisar de swap. Quando o sistema movimenta páginas repetidamente e quase não produz trabalho, há thrashing.
Na próxima aula, conectaremos CPU e memória aos dispositivos ao estudar entrada e saída, interrupções, DMA, buffers e drivers.
Referências
- Linux Kernel Documentation — Page Tables. Acesso em 5 set. 2026.
- Linux Kernel Documentation — Memory Management: Concepts overview. Acesso em 5 set. 2026.
- Linux Kernel Documentation — Cache and TLB Flushing Under Linux. Acesso em 5 set. 2026.
- Linux Kernel Documentation — Examining Process Page Tables. Acesso em 5 set. 2026.
- Linux Kernel Documentation — Documentation for
/proc/sys/vm/. Acesso em 5 set. 2026. - Linux man-pages —
proc_pid_stat(5). Acesso em 5 set. 2026. - The Open Group — POSIX.1-2024:
mmap. Acesso em 5 set. 2026. - The Open Group — POSIX.1-2024:
fork. Acesso em 5 set. 2026. - Microsoft Learn — Working Set. Acesso em 5 set. 2026.
- Microsoft Learn — Page State. Acesso em 5 set. 2026.
- ACM, IEEE-CS e AAAI — CS2023: Operating Systems. Acesso em 5 set. 2026.